艾清遥,清华大学计算机科学与技术系副教授,博士生导师。主要研究方向为信息检索,包括信息表示学习、排序优化理论、检索增强技术等在互联网搜推和智慧司法上的应用。曾担任 ACM SIGIR-AP 2023 大会联合主席,NTCIR-18/19 程序联合主席,ACM TOIS 副主编,SIGIR、CIKM、WSDM 等国际顶级信息检索会议的领域主席。曾获北京市科技进步一等奖、钱伟长中文信息处理科学技术奖一等奖、钱伟长青年创新奖、Google 全球研究学者奖、ACM SIGIR 杰出青年学者奖、ACM SIGIR 2024 最佳论文奖、SIGIR-AP’23 最佳论文荣誉提名等。
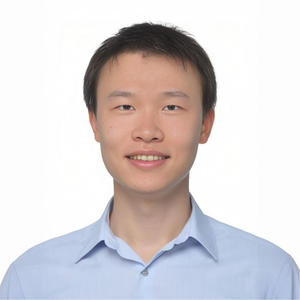
专题演讲嘉宾:艾清遥 博士
清华大学计算机科学与技术系副教授,博士生导师
by 艾清遥 博士
清华大学
计算机科学与技术系副教授,博士生导师检索增强生成(RAG)已成为帮助大型语言模型(LLMs)利用和学习外部知识的主流范式。然而,传统的 RAG 方法通常将 LLMs 视为静态的黑箱,仅依赖提示词和上下文工程来整合检索到的信息。这忽略了两个重要的问题,即 LLM 推理过程中的动态信息需求和 LLM 在内、外部知识利用过程存在的机制鸿沟。为此,我们针对性地提出动态化和参数化的检索增强生成范式,通过主动分析 LLMs 在推理过程中不断变化的需求,实时将检索到的知识注入模型的内部表示和参数中,弥合外部知识检索与内在模型动态之间的差距,实现对 LLM 外部知识利用效率和性能的全面提升。具体而言,我将重点介绍如何从注意力网络和多层感知机权重两个角度实现动态化和参数化的检索增强,在不改变 LLM 原有参数的前提下实现无缝且实时的外部知识注入。实验表明,与传统 RAG 相比,基于动态化和参数化的检索增强技术可以在提升系统的准确性和适应性的同时显著减少计算开销。我们相信动态化和参数化的检索增强范式将为弥合外部知识检索与内在模型动态之间的差距,推进大语言模型信息系统的动态定制化和可持续学习提供重要指导。
演讲提纲
1. RAG 的技术演进与核心挑战
- 传统 RAG 的局限性
- 动态化与参数化的 RAG 价值
2. 基于检索与生成推理解耦技术的动态化 RAG 实例
- 基于交叉注意力机制的知识注入
- 跨任务对比实验
- 推理复杂度理论分析
3. 基于增量参数模块的参数化 RAG 实例
- LLM 内外部知识机制理论
- 外部知识的参数化模块构建
- 参数化 RAG 流程范式
- 性能与效率对比实验
4. 未来方向与行业启示
- 动态感知与参数化注入的复合架构
- 持续学习框架
您认为,这样的技术在实践过程中有哪些痛点?
- 技术理论仍待完善
- 需要软硬件结合的系统支持
演讲亮点
- 解密动态化与参数化 RAG 突破 Transformer 架构限制的核心机理
- 实证多文档场景下推理延迟与准确率不可兼得的破解之道
听众收益
- 掌握下一代 RAG 技术的动态化与参数化实施方法论
关注主办方(InfoQ)


联系我们
交通指南
上海浦东滨江喜来登酒店
SHERATON SHANGHAI PUDONG RIVERSIDE
地址:上海浦东大道2288号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手