庞亮,中国科学院计算技术研究所智能算法安全重点实验室副研究员,新加坡国立大学访问学者,研究方向为自然语言生成和信息检索。在国际会议发表过论文 60 余篇,谷歌引用超过 4000。担任国际会议程序委员和期刊审稿人,中文信息学会信息检索专委会常务委员,中文信息学会青工委副主任,北京市科技新星,中国科学院青促会会员。曾获中文信息学会优秀博士学位论文奖,CIKM 最佳论文候选,SIGIR 最佳论文提名。提出的深度文本匹配模型在 Kaggle QQP 文本匹配比赛中获得全球第四。NeurIPS 2018 多智能体挑战赛强化学习全球冠军。多跳开放问答 HotpotQA 位列全球榜单第一。
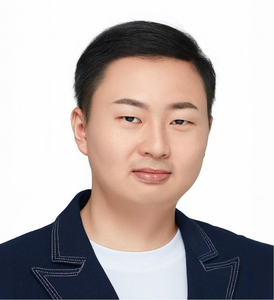
专题演讲嘉宾:庞亮 博士
中国科学院副研究员
by 庞亮 博士
中国科学院
副研究员检索增强生成(RAG)是提升大语言模型(LLM)生成内容准确性与可信性的关键技术,但传统 RAG 存在局限:多依赖 LLM 的上下文学习能力(In-Context Learning)直接拼接信息检索与 LLM 模块,未对系统进行全流程优化,导致效果难达最优,成为技术落地的核心瓶颈。为破解此难题,我们聚焦 RAG 系统的信息检索模块与 LLM 生成模块两大核心部件,从双视角切入实现技术突破,构建具备自增强能力的检索增强大模型,突破传统技术的参数知识边界。在信息检索模块优化上,传统系统设计初衷是服务人类用户,可依托用户点击、停留等反馈信号迭代进化;但在 RAG 场景中,LLM 成为信息传递中间层,隔绝用户反馈与检索模块,使其失去进化依据。针对此痛点,我们提出 “用户调试模式” 与 “影子用户模式”,打通反馈信号传递链路,让检索模块基于应用反馈持续优化,提升结果与 LLM 生成目标的匹配度。在 LLM 生成模块优化上,传统 LLM 未针对 “外部知识利用” 专项训练,常规提升思路需大量长上下文标注数据,成本高、周期长。我们设计无监督学习任务,让 LLM 通过无监督信号自主学习外部知识利用方法;同时理论分析发现 LLM 内部存在天然知识选择机制,可利用该特性指导其精准筛选、运用外部知识,提升信息整合转化效率,实现生成质量与知识准确性双重提升。
演讲提纲
1. RAG 的技术背景与核心挑战
- 大语言模型的知识边界
- 多视角看 RAG 的价值与挑战
2. 在信息检索视角下构建用户反馈优化的 RAG 实例
- 传统检索模块的用户反馈环路
- 基于 RAG 的信息检索模块优化
- 基于 RAG 的用户反馈环路的设计
- 价值与挑战
3. 在大模型视角下高效利用外部知识的 RAG 实例
- 传统 LLM 利用外部知识的挑战
- 无监督 RAG 学习任务设计
- 性能与效率对比实验
- LLM 内部天然知识选择机制
- 性能与效率对比实验
4. 未来方向与行业启示
- 基于多智能体的信息检索与大模型深度融合
- 外部记忆压缩的 RAG
您认为,这样的技术在实践过程中有哪些痛点?
- 优化信号的规模化与用户反馈的代价的权衡
- RAG 无监督方式的规模化效应的验证
演讲亮点
- 提出用户反馈环路的构建是系统持续优化的重点
- 首次从理论上分析 RAG 的内部知识选择机制
听众收益
- 掌握下一代 RAG 技术的优化策略
关注主办方(InfoQ)


联系我们
交通指南
上海浦东滨江喜来登酒店
SHERATON SHANGHAI PUDONG RIVERSIDE
地址:上海浦东大道2288号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手