在传统 AI 的黄金时代,大模型通过海量数据学会了“思考&rdquo... 展开 >
具身智能:当 AI 学会“动手思考”
会议室:多功能厅 2出品人:王铁震
- Topic 1
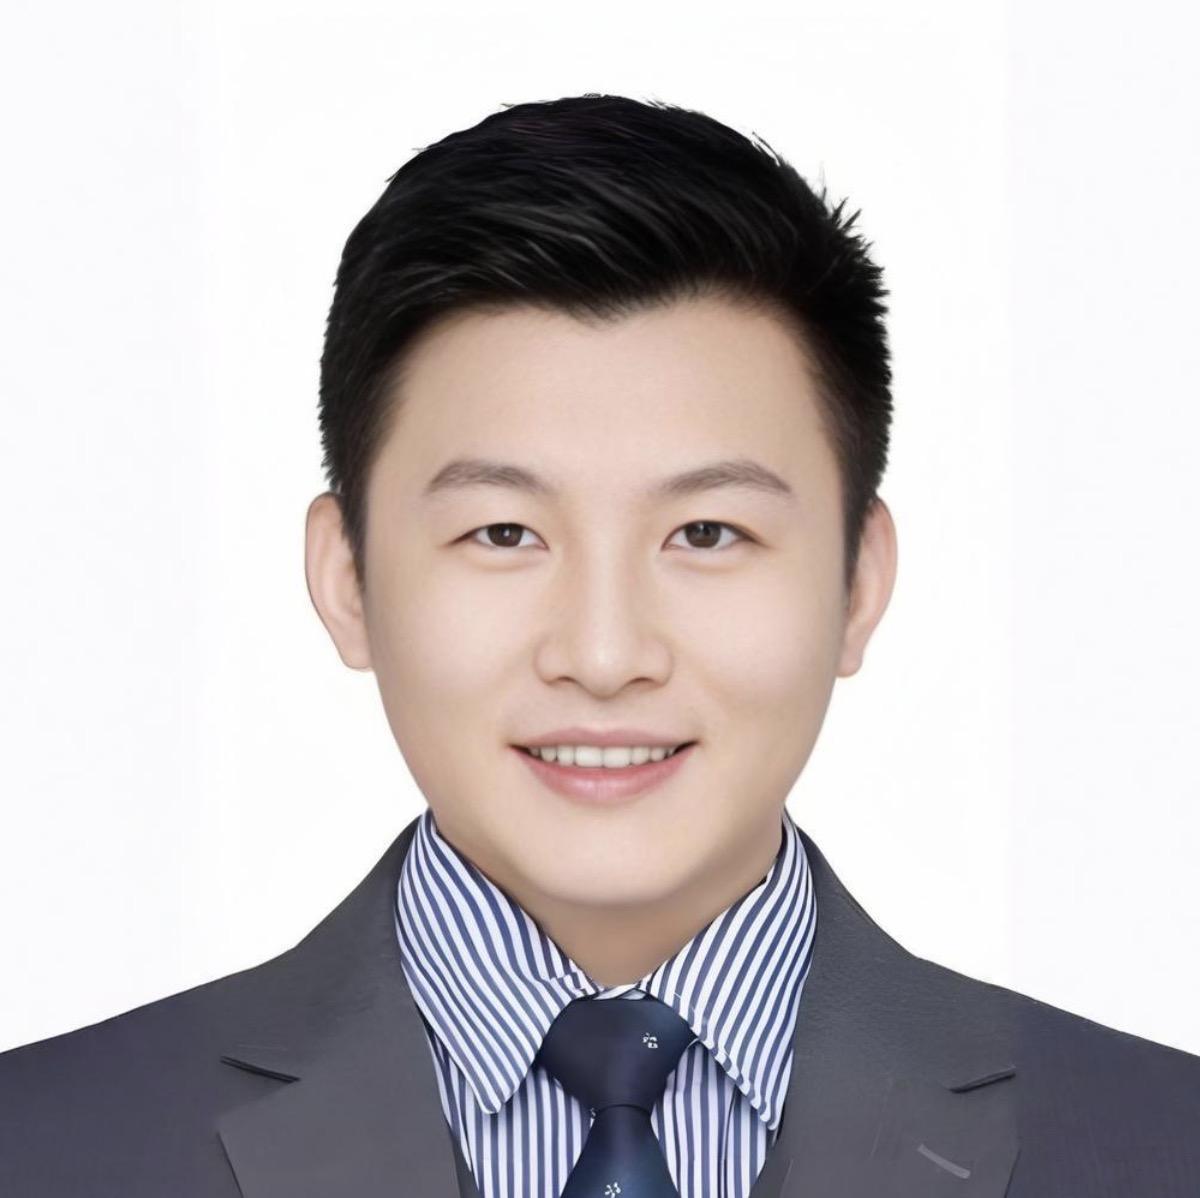
隋伟 博士
地瓜机器人 算法副总裁 - Topic 2
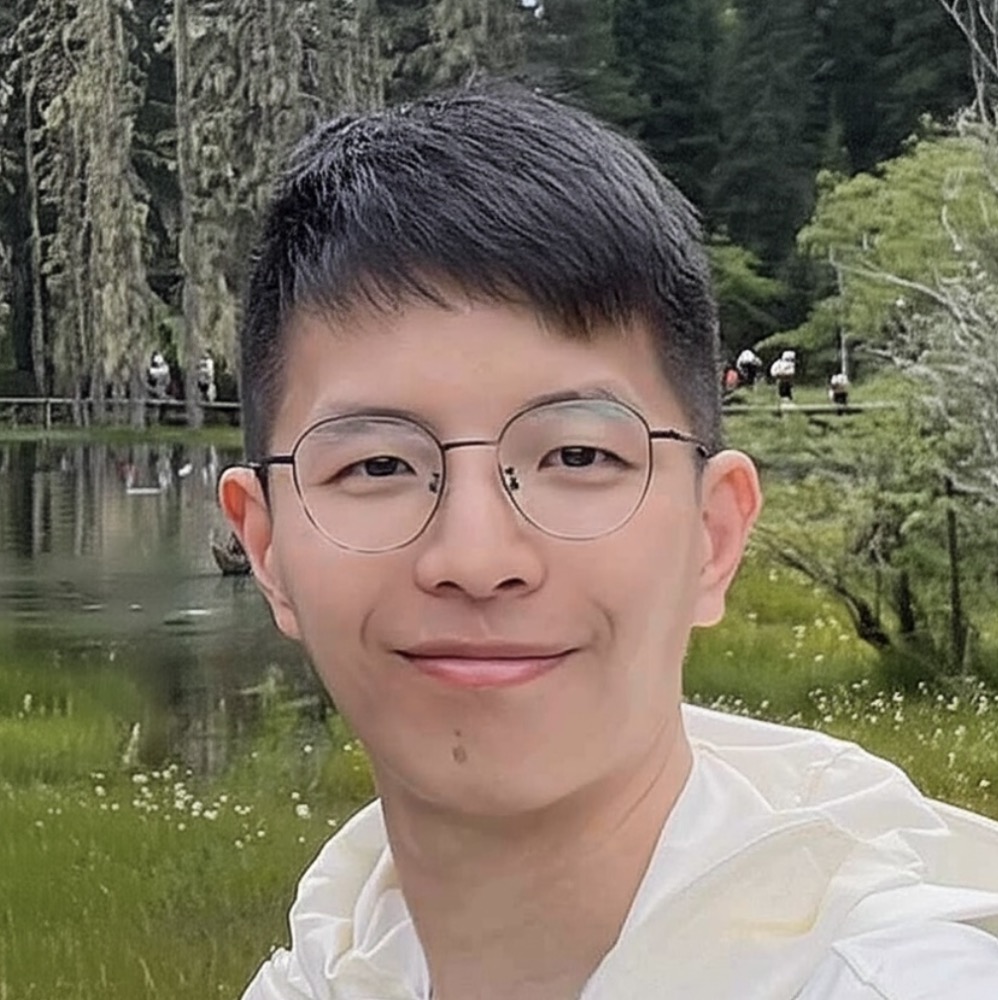
Tim Qian
BamBot 作者 - Topic 3
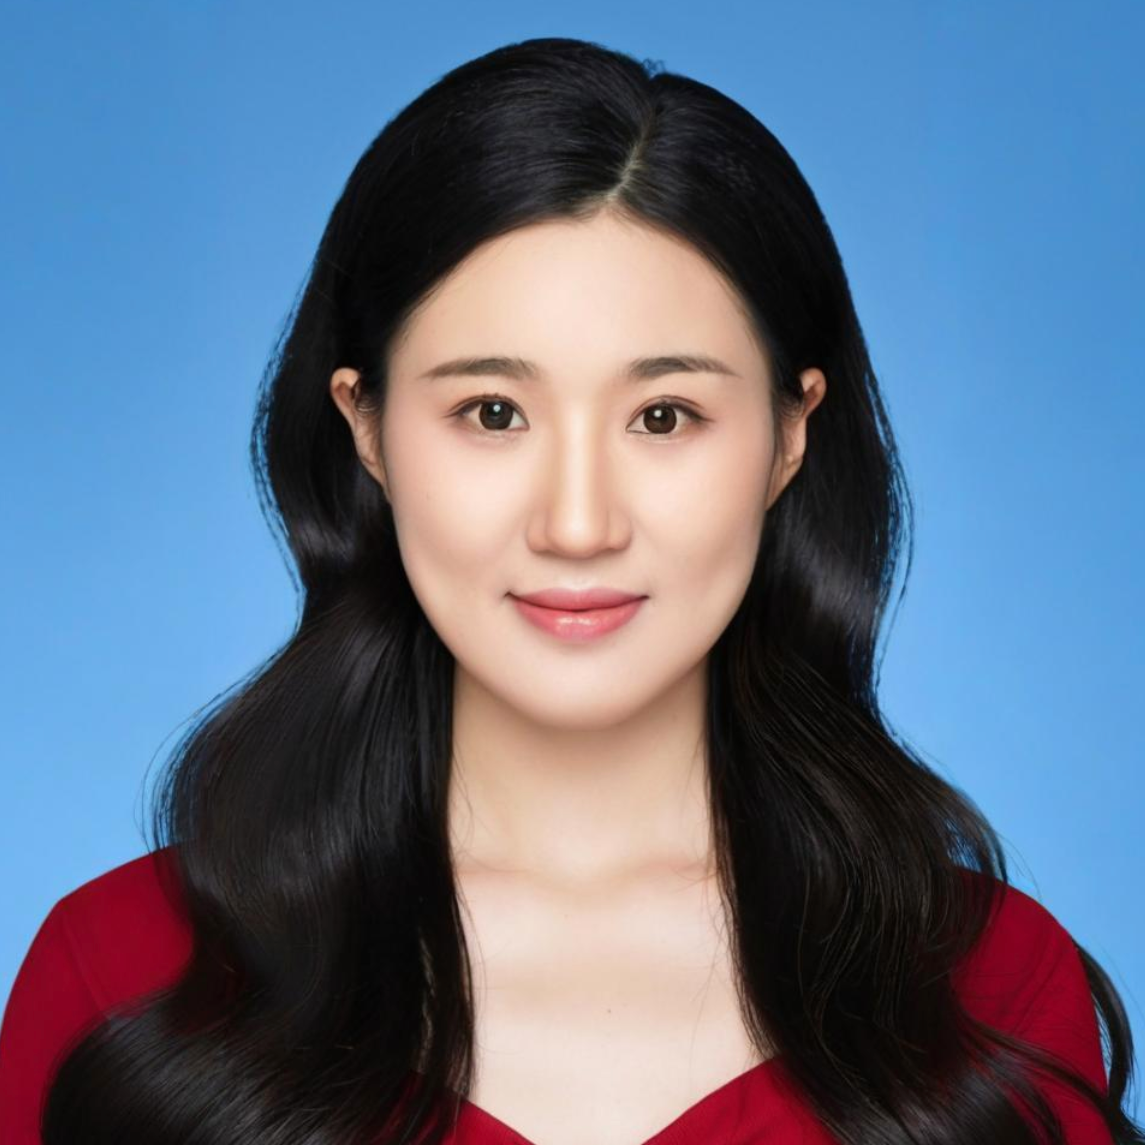
于超 博士
清华大学 助理研究员
专题出品人:王铁震
Hugging Face工程师
王铁震,Hugging Face 工程师,兼具实干精神与梦想追求,坚信开源是连接全球的纽带,让 AI 的益处普惠大众。他秉持"高手在民间"的理念,渴望激励更多的开源模型从业者成为行业的关键意见领袖,挖掘群体的智慧与潜能,促进社区的成长和影响力的扩大。
地点:多功能厅 2
专题:具身智能:当 AI 学会“动手思考”
在传统 AI 的黄金时代,大模型通过海量数据学会了“思考”,但它们始终被困在数字世界——无法真正触摸、操作或感受物理环境。具身智能(Embodied AI)的崛起,正在打破这一界限,代表了人工智能从“看得见”到“摸得着”的一次思想跃迁。通过赋予 AI “身体”(机器人、机械臂、智能传感器等),我们不再只是训练它回答问题,而是让它通过动作与环境互动,像人类一样“动手思考”。
但真正的挑战在于:如何让 AI 的“大脑”和“身体”协同工作?如何构建能够在复杂环境中自主行为的 AI 系统? 本次专题将邀请全球顶尖研究者、工程师和创业者,探讨具身智能的关键技术、应用场景以及未来趋势,共同探寻这一新兴领域如何推动下一代 AI 的发展。
by 隋伟 博士
地瓜机器人
算法副总裁传统的具身智能操作方法将视觉感知、语言理解和动作规划分割为独立模块,导致系统复杂、误差易累积且泛化能力不足。视觉语言动作模型(VLA)则实现了从多模态感知到动作生成的端到端学习,构建了 “所见即所动” 的智能决策闭环,极大地推动了具身智能发展。
然而视觉语言动作模型本身也存在诸多挑战,例如训练数据难以获取、模型结构缺少长时序和物理逻辑推理的能力。这意味着 VLA 虽然能实现一些操作功能但是对不同场景、不同任务的泛化性仍然存在挑战,无法满足实际的需求。
本次演讲主要分享 VLA 技术的基本原理和机制,以及在落地过程中涉及到的数据、评测等问题, 从而提升 VLA 的性能和易用性。
演讲提纲
1. 具身智能 VLA 的现状及挑战
- VLA 是什么,用来解决什么问题及 VLA 的业界发展现状
- 分层式 VLA 和端到端 VLA 的路线
- VLA 的挑战:模型场景泛化性、任务泛化性和本体泛化性弱,VLA 模型数据获取困难,对算力要求大
2. 分层式 VLA 架构
- 模型架构
- 分模块功能及原理
3. VLA 的数据方案
- 仿真数据的获取方式
- 遥操采集及数据预处理
4. VLA 的量化部署
- 模型优化
- 模型量化
您认为,这样的技术在实践过程中有哪些痛点?
- 如何设计合理的、符合需求的 VLA 模型,让模型具备一定的泛化和迁移能力
- 如何获取高质量的 VLA 数据
- VLA 在边缘侧的高效运行
演讲亮点
- 从实用的角度,详细介绍 VLA 的技术原理,和影响性能的关键因素
- 对 VLA 中常用的仿真和真机采集两条数据路线进行详细的分析
- 详细介绍 VLA 对端侧算力的需求以及部署的工程实践
听众收益
- 系统了解具身智能领域中 VLA 技术的现状、挑战和发展趋势
- 理解 VLA 的模型技术架构,各个模块的作用
- 理解仿真数据和真机数据的区别和作用
- 获得开发 VLA 的实践思路和工程经验,包括模型设计、数据获取和量化部署
by Tim Qian
BamBot
作者近年来,AI 技术的爆发为机器人真正走进千家万户铺平了道路。我们可以看到,各类新型机器人以及具身智能模型和应用正如雨后春笋般涌现,机器人的能力越来越强、应用场景也越来越丰富。然而,随之而来的一个现实问题却愈发凸显:不同品牌、不同类型的机器人往往采用各自不同的控制方式,而各类 AI 模型的接入、使用方法和适用场景也存在显著差异。对于普通用户来说,真正想让机器人为自己高效工作,依然面临着较高的技术门槛。要打破这一壁垒,核心在于通过技术手段实现标准化和抽象化。比如,构建统一的控制接口、适配多种模型的通用框架,降低机器人和 AI 技术的使用门槛,让用户无需关心底层技术细节,就能便捷地调动和管理各类智能硬件和应用,真正释放具身智能的价值。本次演讲将聚焦于如何基于浏览器构建一个面向多种机器人和 AI 模型的通用控制平台,分享其中的技术架构设计思路、关键挑战与实践经验。
演讲提纲
1. 机器人落地过程中的实际技术痛点
- 尽管机器人硬件和 AI 模型发展迅速,但端到端交付仍存在明显障碍
- 普通用户上手难度大,技术人员在实际部署时也面临以下挑战:
- 控制逻辑分散,强依赖代码能力,缺少统一入口
- 机器人品类多样,协议、接口不统一,适配成本高
- 控制链条复杂,涉及硬件、通信、界面多层,系统集成难度大
2. 为什么技术方案选在浏览器端
- 浏览器天然跨平台,避免了多端适配的重复工作
- 前端技术栈成熟,3D 渲染、实时通信、界面交互能力强
- 配合 WebAssembly、WebRTC、WebGPU 等技术,浏览器的能力边界大幅提升
- 可以在无需安装、即时访问的前提下,完成从仿真到控制的完整链路
3. 浏览器中的可视化与物理仿真技术挑战
- 高性能 3D 渲染:如何在浏览器内流畅展示机器人状态与环境
- 物理仿真同步:真实物理引擎的接入与前端渲染的一致性问题
- 数据交互:高频数据下的前后端通信优化
- 性能瓶颈与资源管理:浏览器环境下如何避免性能坍塌
4. 控制系统的扩展性设计
- 设计目标:控制通道抽象、输入方式可插拔、模型驱动灵活接入
- 实现方式:
- 控制输入统一封装,支持键盘、手柄、Web UI、AI 模型等多种输入源
- 模型层与控制层解耦,支持不同智能模型快速切换
- 统一协议设计,便于新硬件、新控制方式的接入
5. 多机器人适配方案
- 通过标准化控制接口屏蔽底层差异
- 基于能力描述和协议映射的适配层设计
- 结合仿真与真实硬件,形成开发、测试、部署的一体化闭环
- 最终目标:让技术人员专注于控制逻辑和应用开发,底层适配、协议转换透明化
您认为,这样的技术在实践过程中有哪些痛点?
- 性能瓶颈:浏览器虽然能力越来越强,但相比原生应用,性能仍有限制
- 浏览器环境下的硬件访问受限
- 前后端同步的复杂性 - 机器人控制涉及状态同步、仿真与真实硬件对齐、AI 模型推理结果接入
- 高频控制指令与状态反馈之间的网络延迟不可忽视,尤其跨网络部署时
演讲亮点
- 从用户需求反推技术架构,如何设计一个既符合直觉、易上手,又具备强大扩展性的具身智能平台
- Web Serial 协议在机器人控制链中的应用实践,打通浏览器与真实硬件的关键技术路径
- 浏览器内多输入控制与 AI 驱动控制的融合设计,如何在一个统一平台下无缝切换传统控制与智能控制
听众收益
- 系统了解具身智能平台的架构思路、技术选型与发展趋势
- 获得面向实际落地的平台设计与多设备接入的工程经验
- 理解浏览器在机器人控制中的优势与技术边界,拓展具身智能开发思路
by 于超 博士
清华大学
助理研究员人工智能正在从“感知”走向“行动”,由大模型驱动的具身智能正成为下一代 AI 的前沿方向。随着 o1/R1 系列的发布,训练范式正在从纯数据驱动的预训练/后训练,转向奖励信号驱动的强化学习(RL),未来 RL 所需算力甚至将超过预训练。然而,现有 RL 框架在面对具身智能的规模化训练时仍然捉襟见肘:一方面,具身智能存在“大脑–小脑–复合”架构的模型异质性;另一方面,其“渲训推一体化”特性带来了仿真、渲染与训练/推理的算力竞争。
为此,我们提出 RLinf ——首个面向具身智能的高可扩展与自适应大规模 RL 框架。RLinf 的 “inf” 既代表 infrastructure,也象征 infinite scaling。它通过 混合式执行模式、多后端集成方案 和 动态调度机制,在具身场景中实现超过 120% 的加速,并在 VLA 模型上带来 40–60% 性能提升。同时,RLinf 的通用性也已在数学推理等跨领域任务中验证,取得 AIME24/25 和 GPQA-diamond 等基准的 SOTA 表现。
本次演讲我将分享 RLinf 的设计理念与关键创新,并分享其在具身智能与跨领域应用中的系统级成果。
演讲提纲
1. 背景与趋势
• 从感知到行动:具身智能成为 AI 新前沿
• o1/R1 引领范式转变:奖励驱动的 RL 取代纯数据驱动
• RL 基础设施的重要性与现有框架的不足
2. 具身智能的独特挑战
• 模型异质性:大脑(推理)+ 小脑(执行)+ 复合架构
• 渲训推一体化:仿真、渲染与训练/推理并行,资源冲突严重
3. RLinf 框架设计与创新
• 混合执行模式:流水化无“气泡”,>120% 加速
• 多后端集成:VLM 用 Megatron+SGLang,VLA 用 FSDP+HF
• 动态通信与调度:负载均衡,自动扩缩容
4. 应用实践
• 具身智能:覆盖百余类任务,VLA 提升 40–60%
• 跨领域:数学推理模型在 AIME、GPQA 基准上达到 SOTA
5. 总结与展望
• RL 正在重塑大模型训练
• RLinf = 高效、省力、可扩展的具身智能 RL 基础设施
• 助力科研与产业走向下一代通用智能
实践痛点
- 要支撑如此庞大的训练算力需求,RL 基础设施(RL infra)的效率和可扩展性变得至关重要。然而,现有框架虽然在传统 RL 与 LLM 后训练上已有突破,但在面向具身智能的规模化 RL上却仍是一片空白。
演讲亮点
- 首创混合执行模型,结合分离式与共享式优势,通过细粒度流水线设计消除系统“气泡”
- 同时支持“大脑”和“小脑”等异构模型的差异化需求,为 VLA 模型带来 40-60% 的性能提升
- 大规模分布式训练中,实现真正的按需扩缩,最大化 GPU 利用率
听众收益
- 用同样硬件获得更高训练效率
- 快速上手具身智能与跨领域任务
- 系统化文档 + 智能助手 + 开源社区支持
- 面向未来的持续进化科研生态
关注主办方(InfoQ)
联系我们
交通指南
上海浦东滨江喜来登酒店
SHERATON SHANGHAI PUDONG RIVERSIDE
地址:上海浦东大道2288号
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手