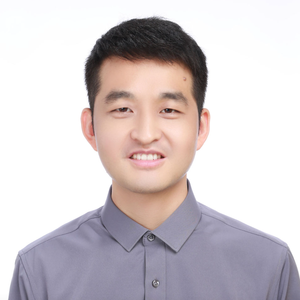
作为搜推广业务稳定性负责人,负责并参与到搜推广业务稳定性建设,长期从事搜索、推荐、广告等核心业务的稳定性与架构治理,负责 AI 核心链路的可靠性工程建设,覆盖模型、推理框架、GPU 算力与成本治理等方向。近年来聚焦 AI-in-SRE 体系实践,推动 AI 系统从“可用”走向“可控、可规模化”,探索 SRE Agent 与 AI 系统自演进能力建设。
讲师介绍
议题介绍
地点:富力1
所属专题:AI for SRE
演讲:AI-in-SRE Loop:当 AI 成为核心业务后,SRE 的下一站
在小红书业务中随着 AI 成为搜索、推荐、广告等核心业务的主链路,系统稳定性面临的挑战已发生本质变化:模型异常不再只是效果波动,而是直接导致业务不可用;GPU、推理框架和模型本身,正在成为生产系统的一部分。在这样的背景下,SRE 的角色也必须进化。
本次分享我将介绍一种新的理念——AI-in-SRE Loop:AI 不只是用于告警和运维辅助,而是深度参与 SRE 的全生命周期决策,从事前预防、事中感知与定位,到事后学习与策略演进。希望为正在或即将进入 AI 规模化阶段的团队,提供一套可落地的工程路径。
演讲提纲
一、AI 系统稳定性:为什么“完全不一样”
1. AI 不稳定性的来源变化
- 从 CPU → GPU / 显存 / 拓扑
- 从进程挂 → TTFT、OOM、输出异常
- 从服务级 → 模型级 / 请求级 / 链路级
2. 故障的“裂变方式”发生改变
- 一次模型异常 → 全链路雪崩
- 一次显存抖动 → 整池推理能力下降
3. 最真实的约束:资源与成本
- GPU 长期紧张 + 异构常态
- 训推冲突是常态,不是异常
- 结论:稳定性 = 可预测性 + 成本可控性
二、AI-in-SRE Loop:一种新的稳定性范式
- AI 参与 SRE 的全生命周期决策,AI 的角色演进:观测者 → 分析者 → 建议者 → 执行者(受控)→ 学习者
- 我们也是做一些 SRE 在 AI 上的落地 Case:推荐性能裂化自动分析、Coredump 分析、SRE 分身 bot、告警规则合理性巡检/风险巡检跟踪治理等
三、26 年 AI 应用的核心工程建设
1. AI 核心链路稳定性工程
- 模型分级 + 主备模型
- 模型级熔断,而不是服务熔断
- 自动摘模型 / 切模型池 / 降级输出
- 任何 AI 请求,都必须有“兜底输出”
2. 大模型可观测体系(SRE 的眼睛)
- 为什么“QPS + RT”完全不够
- 模型级指标:
- TTFT / TPOT
- 输出长度 / 拒答率 / 异常输出
- 请求级 Trace:
- Prompt → 模型 → 工具 → 输出
- GPU 级观测:
- 显存碎片、OOM 前兆、利用率
3. GPU 与异构算力稳定性治理
- GPU 健康检查 + 自动摘卡
- 不追求一致性能,而是分池:
- 高质量池 / 稳定池 / 低成本池
- 训转推机制产品化
- 高峰期自动挪
- 低峰期自动还原
4. 智能拦截变更
- 建设变更风险识别引擎
- 五种维度:人 + 时间 + 内容 + 流程合规 + Fallback 能力
- 三大类型:基础通用风险 + 变更渠道风险 + 个性化风险
- 变更内容语义识别难
- 基于大模型对代码和配置的理解能力,结合历史变更记录,分析当前变更风险
四、SRE Agent:SRE 的“代理人”
- 24 小时看全局
- 跨模型 / GPU / 链路分析
- 风险预知
- 受控自动执行
- 人从“操作员”变成“策略设计者”
五、总结:SRE 没有被 AI 替代,但 SRE 正在升级为AI 系统的可靠性工程师
您认为,这样的技术在实践过程中有哪些痛点?
1. 指标定义难
- 什么是“模型异常输出”?
- TTFT 波动多少算故障? 没有银弹,只能结合业务共建
2. 自动化执行的信任问题
- 谁敢让 AI 自动摘模型?
- 谁敢自动切 GPU 池?
- 必须有「受控执行 + 审计 + 回滚」
3. 成本与稳定性的天然冲突
- 最稳定的方案,往往最贵
- 最省钱的方案,往往最脆
- SRE 必须参与预算和策略设计
4. 组织层面的阻力
- 模型团队 / 平台团队 / SRE边界变模糊,稳定性责任归属
演讲亮点
- 不是泛泛而谈 AI,而是明确 AI 已经是生产系统
- 提出 AI-in-SRE Loop 的方法论,而非工具堆砌
- 模型级、GPU 级、链路级的工程实践
- 把“成本”纳入稳定性设计,而不是事后背锅
- SRE Agent 的未来形态,而不是人肉值班
听众收益
1. 对 SRE / 架构师
- 一套 AI 系统稳定性工程的完整认知框架
- 知道 2026 年 SRE 应该往哪里演进
2. 对 AI 平台 / 模型团队
- 明白为什么“模型好 ≠ 系统可用”
- 如何和 SRE 协作,而不是互相甩锅
3. 对技术管理者
- 看到 AI 规模化后的真实工程成本
- 知道为什么需要为 AI 稳定性单独投入
关注主办方(InfoQ)


联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手