在系统规模不断扩大、架构日益复杂的背景下,传统依赖规则、告警和人工经验的运维方式... 展开 >
AI for SRE
会议室:富力1出品人: 党受辉
- Topic 1
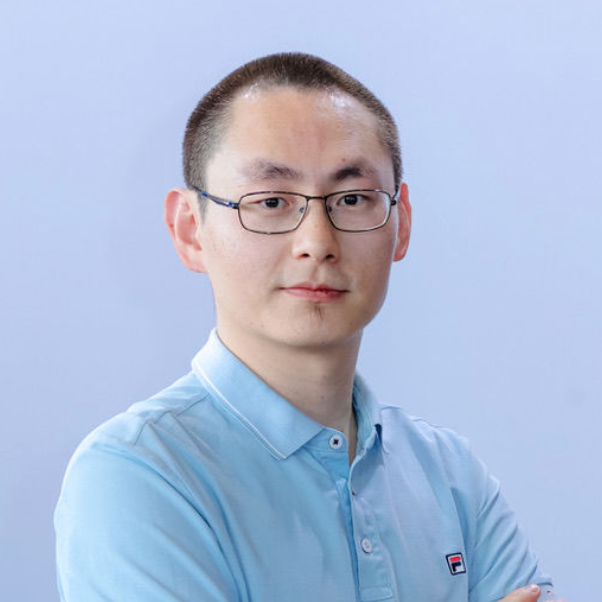
石鹏(东方德胜)
美图 高级运维经理,SRE 负责人 - Topic 2
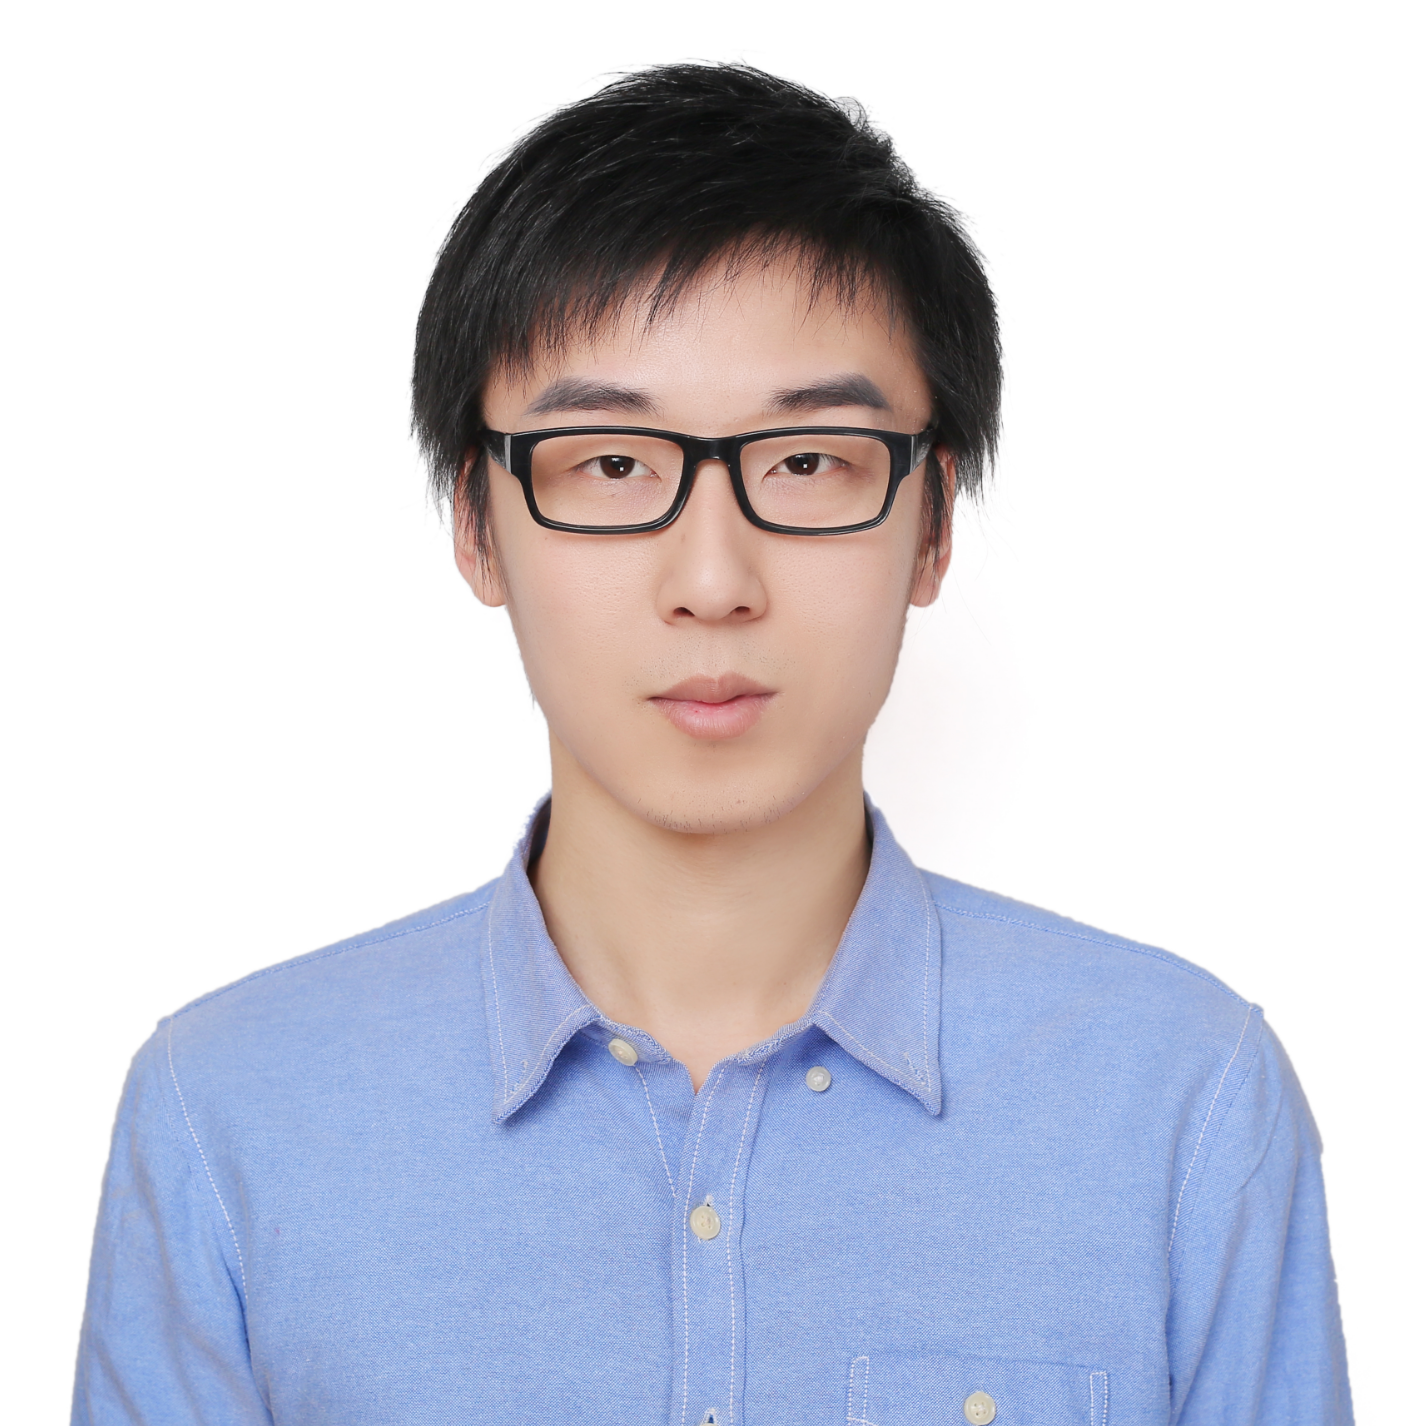
雷阳
腾讯 资深 SRE 工程师 - Topic 3
赵文成
小米 高级服务端工程师,运维平台研发负责人 - Topic 4
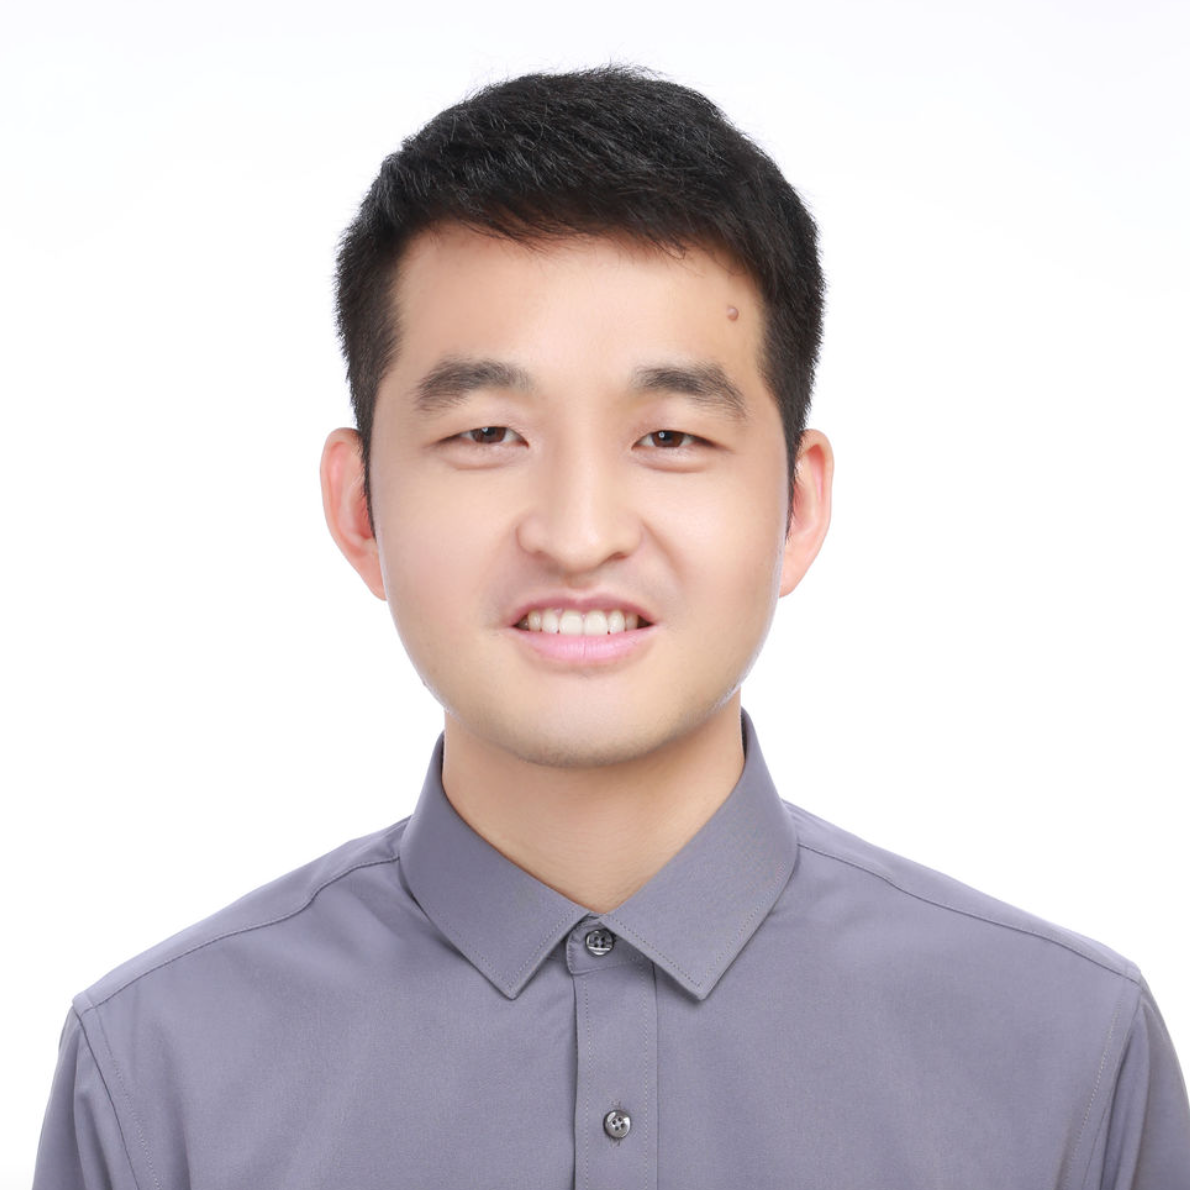
田云龙
小红书 资深高可用架构师
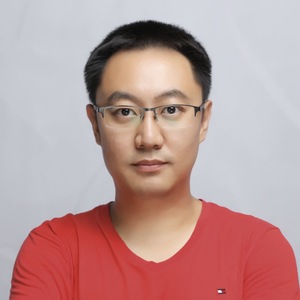
专题出品人: 党受辉
腾讯 IEG技术运营部助理总经理,专家工程师
党受辉,腾讯 IEG 技术运营部助理总经理,专家工程师。腾讯游戏 SRE 负责人,负责研发工具链、运维自动化、线上可靠性等研运一体基础设施平台蓝鲸智云;信通院 SREelite《SRE 实践白皮书》作者之一。
地点:富力1
专题:AI for SRE
在系统规模不断扩大、架构日益复杂的背景下,传统依赖规则、告警和人工经验的运维方式,已难以应对高频变更与不确定性风险。如何将 AI 能力真正嵌入站点可靠性工程(SRE)的核心工作流中?本专题将深入探讨 AI 如何与 SRE 的工程实践形成闭环。
by 石鹏(东方德胜)
美图
高级运维经理,SRE 负责人在 AIGC 业务开始规模化落地后,我们的 SRE 团队很快感受到两股压力同时袭来:一方面是多层算法流带来的复杂调度与稳定性挑战,另一方面是长期积累的治理“旧账”——元数据散乱、标准化缺失,正在持续放大运维成本。与其继续靠堆人力硬扛,我们选择开启一条“补课式”的转型路径:一边补齐标准化与 SOP 的基础能力,一边探索基于 Multi-Agent 架构的智能运维体系。
在这次分享中,我会结合美图的真实实践,拆解我们如何利用 MCP 协议解耦复杂工具链,通过 Skills 机制将标准化运维能力封装为可执行单元,逐步打通从知识问答、OnCall 工单处理,到根因定位(RCA)与故障自愈的完整闭环。这套体系最终帮助我们实现了约 40% 的人效提升,也让运维从“人肉响应”走向“语义驱动执行”。
同时,我也会重点分享在生产环境中踩过的坑:例如如何划定 Agent 的指令安全边界,如何应对模型幻觉带来的数据一致性风险,以及这些取舍背后的工程权衡,希望为正在探索 SRE Agent 落地的团队提供一条可参考的演进路径。
演讲提纲
1. 序幕:AIGC 爆发下的运维“债务”危机
- 业务挑战:美图 AIGC 多层算法流带来的高频调度与稳定性压力
- 现状审视:坦诚历史“旧账”——元数据散乱、标准化断层如何制约 Agent 的生产力
- 演进策略:通过构建 “Skills-based SOP” 体系,实现运维能力的快速补齐与跨代演进
2. 筑基:Skills 体系——将 SOP 转化为 Agent 的“肌肉记忆”
- 定义革新:从静态文档到可执行 Skills:包含专家经验、结构化约束与执行工具的统一封装
- 方法论落地:如何通过 Agent 语义驱动,反向强制推行元数据治理与标准化运维建模
- 补课成效:通过 Skills 的标准化沉淀,在解决历史债务的同时,为 Agent 提供精准的执行上下文
3. 架构:基于 LangGraph 的有状态 Skills 调度
- 核心选型:为什么选择 LangGraph?解决故障处理中复杂的“循环判断”与“异常回滚”逻辑
- 节点化编排:将每一个 Skill SOP 节点化,利用循环图实现复杂运维任务的动态自适应编排
- 协议统一:引入 MCP (Model Context Protocol) 解耦工具层,构建标准化、可插拔的 SRE 能力库
4. 实战:从“对话问答”到“闭环执行”的进阶
- 场景一:根因定位 (RCA):Agent 如何按照 SOP Skills 自动巡检、收集证据并实现分钟级的故障锁定
- 场景二:全生命周期故障管理:打通告警压缩、工单处理到故障自愈的 Skills 流转闭环
- 效能提升:实战数据展示:40% 效率提升背后的技术逻辑与人机协作模式
5. 深度反思:生产环境下的 Trade-off 与避坑
- SOP 刚性 vs. 决策灵活性:如何在 LangGraph 中通过“条件边”设置安全红线,防止 Agent 跳出 SOP 范围
- 一致性困境:解决秒级推理速度与毫秒级基础设施状态变化之间的“时序错位”
- 幻觉治理:如何通过“语义沙箱”与“多重校验”规避模型虚构运维指令的风险
6. 总结:从“补课生”到“智理者”
- 核心价值:Agent 不是取代 SRE,而是通过 Skills 体系释放人类的创造力
- 未来展望:美图在自愈式基础设施治理上的下一步目标
您认为,这样的技术在实践过程中有哪些痛点?
- 指令执行的安全边界 vs. 自动化效率: 在 SRE 场景下,完全闭环的自动操作(如自动重启或配置变更)风险极大。我们在实践中面临“人机协作”的权衡:是追求极致的自动化,还是保留强制的人工确认?最终我们通过“语义校验 + 灰度执行库”来建立安全水位,但这牺牲了一定的响应实时性。
- 状态一致性挑战: SRE 环境是高度动态的,Agent 的推理速度(秒级)往往滞后于基础设施的状态变化(毫秒级)。如何确保模型在决策时看到的元数据不是“过期的快照”,是我们面临的长期挑战,涉及了复杂的实时缓存与感知反馈机制。
- 模型幻觉与生产稳定性: LLM 可能在根因分析(RCA)中虚构不存在的指标或参数。我们选择了“限制搜索空间”的方案,即 Agent 只能在定义的 Skills 库内操作,这虽然增强了安全性,但也限制了 Agent 发现“黑天鹅”问题的天马行空。
演讲亮点
- 基于 MCP 协议的“插件式”SRE 架构: 区别于业界常见的“硬编码”工具调用,我们引入了 MCP(Model Context Protocol) 协议来标准化 Skill 层。这使得运维工具链与模型底座实现完全解耦,不同团队开发的运维脚本只需简单适配即可转化为 Agent 的原子能力
- “补课式”元数据治理路径: 我们分享的重点不在于模型多强,而在于如何通过 Agent 倒逼运维标准化。我们展示了一套“元数据-标准化-Agent驱动”的演进模型,通过 LLM 语义识别来反向清理历史冗余的资产数据,这种“由上而下”的治理思路与传统“由底向上”的方式截然不同
听众收益
- 获得一份“旧账”公司的智能运维转型地图: 针对历史债务沉重(资产乱、流程杂)的企业,听众可以学习如何通过“补课”策略,在不重构全量底层系统的前提下,快速上线具备生产力的 SRE Agent
- 掌握 Multi-Agent 在垂直领域的落地架构: 深入了解如何利用 Python/Celery 构建高并发的 Agent 任务调度层,以及如何设计多 Agent 协作流(如从工单助手到故障自愈的交接棒逻辑)
- 避坑指南: 听众将直接获得我们在生产环境中使用 Agent 进行故障定位与风险评估时的真实失效案例,了解如何从流程、工程和算法三个维度规避 Agent 的“乱作为”
by 雷阳
腾讯
资深 SRE 工程师本次分享将探讨 LLM 如何驱动运维领域从“自动化工具”迈向“智能体(Agent)”的深刻变革。我将解析从手动、脚本到平台,最终实现 AI 自主决策的三阶段模式演进。核心部分将以业务版本生命周期为主线,结合业务真实场景实战案例,详细拆解智能体(Agent)在 CI/ CD /CO 全链路(如代码分析、智能发布、业务巡检)的具体落地与应用。最终结合“AI 工时”策略,用精确数据验证智能化运维“数字分身”的降本增效成果,为团队转型提供实战参考。
演讲提纲
1. 运维模式的代际演变
2. “ AI 工时”与智能体类型
- 设计原则:基于 ReAct 模式(Reasoning + Acting),我们将模型的推理时长与工具执行时长融合,定义了新的度量标准——“AI工时”
- 智能体的三种形态:
- AI Chat (RAG):基于知识库的问答,辅助人工获取信息
- AI Task / Common:意图识别 + 参数提取。从“听懂指令”到“执行任务”,是当前的主流形态
- AI Auto (终极目标):具备主动发现、自主规划、智能编排的能力。它不再是被动响应,而是能进行动态规划和结果评估
- 概念引申:介绍“工时爆炸”与“工时提炼”的动态规划策略,解释AI如何处理复杂任务
3. 场景落地:全生命周期的智能化实践
- CI(集成阶段)—— 侧重连续性与安全
- CD(交付/部署阶段)—— 重头戏
- 测试环境(Autopilot 全 AI 托管)
- 正式环境(人机协同)
- 发布前:版本管理的 Checklist 检查、智能编排分组、发布前风险评估
- 发布中:业务巡检报告(运行镜像)、标准运维报错辅助分析(动态决策)
- 发布后:自动生成发布总结与复盘报告
- CO(运营阶段)—— 智能监控
- 指标监控与功能验证
- 利用 AI 进行舆情分析,辅助判断业务稳定性
4. 收益与未来展望
- 模式对比
- 原有模式(人 + 自动化业务):按人力投入( PMI )计算,成本高且弹性差
- 智能模式(AI + 审核):计算公式变革为 “测试服操作次数 × Agent 原子调用工时 + 正式服操作次数 × 单个 Agent 工时”
- 价值总结
- 不仅实现了降本(减少人力投入),更实现了增效( AI 24 小时待命,响应更稳更快)
- 未来展望
您认为,这样的技术在实践过程中有哪些痛点?
- SRE 是严肃且严谨的领域,如果把智能体安全的应用于 SRE 领域需要严格把控
- 如何衡量智能体的真实价值,要进行科学的评估,用数据说话
- 智能化过程中,大模型的泛化能力和上下文管理任然是一个难点,在进行智能体建设如果避免大模型短板或者借助其他手段解决问题非常关键
演讲亮点
- 智能体价值衡量
- SRE 智能体如何设计,如何结合平台能力
- 游戏版本周期内多智能体协作
听众收益
- 智能体在 SRE 领域如何落地,获得收益
- 智能体在游戏 SRE 的场景切入
by 赵文成
小米
高级服务端工程师,运维平台研发负责人在 AI 浪潮席卷运维领域的当下,我们常常陷入对“智能”的狂热追捧,却可能忽略了 SRE 的本质:一套将稳定性、效率、成本目标工程化、自动化的系统性实践。本次分享将结合小米在 AI for SRE 领域的探索,探讨一个核心命题:如何将 SRE 专家大脑中那些难以编码的隐性知识、经验与判断逻辑,有效地“注入” AI,并形成可度量、可进化的工程闭环?分享小米在核心 Skills 管理、记忆嵌入、数据资产沉淀方面的实践,解析背后的实现逻辑与架构。
演讲提纲
1. 回顾与演进——AI for SRE 的三级跳
2. 攻坚核心——SRE 知识资产的沉淀、激活与闭环
- Skills 管理:将 SRE 经验转化为可执行的“肌肉记忆”
- 记忆与知识库:构建AI的“情景认知”与“长期记忆”
- 数据统计与价值衡量:驱动闭环演进
3. 实现架构
- 总体架构蓝图
- 关键组件详解
4. 展望与反思——AI 时代的 SRE“债务”与壁垒
对于小米而言,各业务线庞大、复杂、历史悠久的运维数据、流程知识与系统间隐式依赖,既是训练“最懂小米”的AI的独一无二燃料,其梳理、整合、合规使用的难度也构成了最大的壁垒。成功的关键在于,能否将这些“数据资产”工程化为“情境化知识资产”。
您认为,这样的技术在实践过程中有哪些痛点?
- 知识沉淀层面:显性化与时效性的两难
- 可靠性与自主性之间的平衡之难
- 组织与流程层面:变革的阻力
演讲亮点
- 以工程方法弥补当前模型情境学习能力的不足
- 将知识管理体系设计成一个具有反馈闭环的系统,确保了 AI 能力的根基会随着时间越用越强,而非逐渐腐化
听众收益
- 了解 AI 在 SRE 领域从工具到伙伴的演进脉络与未来方向
- 了解小米在构建企业级 AI-SRE 闭环体系中的架构思路、核心组件与踩坑经验
- 探讨如何识别、沉淀和治理 SRE 核心数据资产,为自身企业的 AI 应用提供落地思路
- 重新思考流程、人与AI的关系,以及在效率提升背后必须面对的长期挑战
by 田云龙
小红书
资深高可用架构师在小红书业务中随着 AI 成为搜索、推荐、广告等核心业务的主链路,系统稳定性面临的挑战已发生本质变化:模型异常不再只是效果波动,而是直接导致业务不可用;GPU、推理框架和模型本身,正在成为生产系统的一部分。在这样的背景下,SRE 的角色也必须进化。
本次分享我将介绍一种新的理念——AI-in-SRE Loop:AI 不只是用于告警和运维辅助,而是深度参与 SRE 的全生命周期决策,从事前预防、事中感知与定位,到事后学习与策略演进。希望为正在或即将进入 AI 规模化阶段的团队,提供一套可落地的工程路径。
演讲提纲
一、AI 系统稳定性:为什么“完全不一样”
1. AI 不稳定性的来源变化
- 从 CPU → GPU / 显存 / 拓扑
- 从进程挂 → TTFT、OOM、输出异常
- 从服务级 → 模型级 / 请求级 / 链路级
2. 故障的“裂变方式”发生改变
- 一次模型异常 → 全链路雪崩
- 一次显存抖动 → 整池推理能力下降
3. 最真实的约束:资源与成本
- GPU 长期紧张 + 异构常态
- 训推冲突是常态,不是异常
- 结论:稳定性 = 可预测性 + 成本可控性
二、AI-in-SRE Loop:一种新的稳定性范式
- AI 参与 SRE 的全生命周期决策,AI 的角色演进:观测者 → 分析者 → 建议者 → 执行者(受控)→ 学习者
- 我们也是做一些 SRE 在 AI 上的落地 Case:推荐性能裂化自动分析、Coredump 分析、SRE 分身 bot、告警规则合理性巡检/风险巡检跟踪治理等
三、26 年 AI 应用的核心工程建设
1. AI 核心链路稳定性工程
- 模型分级 + 主备模型
- 模型级熔断,而不是服务熔断
- 自动摘模型 / 切模型池 / 降级输出
- 任何 AI 请求,都必须有“兜底输出”
2. 大模型可观测体系(SRE 的眼睛)
- 为什么“QPS + RT”完全不够
- 模型级指标:
- TTFT / TPOT
- 输出长度 / 拒答率 / 异常输出
- 请求级 Trace:
- Prompt → 模型 → 工具 → 输出
- GPU 级观测:
- 显存碎片、OOM 前兆、利用率
3. GPU 与异构算力稳定性治理
- GPU 健康检查 + 自动摘卡
- 不追求一致性能,而是分池:
- 高质量池 / 稳定池 / 低成本池
- 训转推机制产品化
- 高峰期自动挪
- 低峰期自动还原
4. 智能拦截变更
- 建设变更风险识别引擎
- 五种维度:人 + 时间 + 内容 + 流程合规 + Fallback 能力
- 三大类型:基础通用风险 + 变更渠道风险 + 个性化风险
- 变更内容语义识别难
- 基于大模型对代码和配置的理解能力,结合历史变更记录,分析当前变更风险
四、SRE Agent:SRE 的“代理人”
- 24 小时看全局
- 跨模型 / GPU / 链路分析
- 风险预知
- 受控自动执行
- 人从“操作员”变成“策略设计者”
五、总结:SRE 没有被 AI 替代,但 SRE 正在升级为AI 系统的可靠性工程师
您认为,这样的技术在实践过程中有哪些痛点?
1. 指标定义难
- 什么是“模型异常输出”?
- TTFT 波动多少算故障? 没有银弹,只能结合业务共建
2. 自动化执行的信任问题
- 谁敢让 AI 自动摘模型?
- 谁敢自动切 GPU 池?
- 必须有「受控执行 + 审计 + 回滚」
3. 成本与稳定性的天然冲突
- 最稳定的方案,往往最贵
- 最省钱的方案,往往最脆
- SRE 必须参与预算和策略设计
4. 组织层面的阻力
- 模型团队 / 平台团队 / SRE边界变模糊,稳定性责任归属
演讲亮点
- 不是泛泛而谈 AI,而是明确 AI 已经是生产系统
- 提出 AI-in-SRE Loop 的方法论,而非工具堆砌
- 模型级、GPU 级、链路级的工程实践
- 把“成本”纳入稳定性设计,而不是事后背锅
- SRE Agent 的未来形态,而不是人肉值班
听众收益
1. 对 SRE / 架构师
- 一套 AI 系统稳定性工程的完整认知框架
- 知道 2026 年 SRE 应该往哪里演进
2. 对 AI 平台 / 模型团队
- 明白为什么“模型好 ≠ 系统可用”
- 如何和 SRE 协作,而不是互相甩锅
3. 对技术管理者
- 看到 AI 规模化后的真实工程成本
- 知道为什么需要为 AI 稳定性单独投入
关注主办方(InfoQ)
联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手