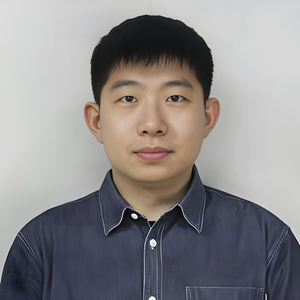
好未来数字效能前端专家,研究与实践方向包括数据可视化、低代码、前端工程化治理,以及基于 SDD 的 AI Coding 规模化落地。曾就职于京东、快手、阿里本地零售,长期负责平台型业务的前端架构与研发效能建设。当前聚焦数据基建、BI 平台与 AI to BI 方向的工程化落地与持续建设。
让 AI 运行在工程资产上:从 PRD 到上线的交付闭环、Hybrid 执行、 Doc 与 Code 联动
所属专题:Coding Agent 驱动的研发新范式
嘉宾 : 李文鹏 | 好未来前端专家
会议室 : 首府3
讲师介绍
议题介绍
演讲:让 AI 运行在工程资产上:从 PRD 到上线的交付闭环、Hybrid 执行、 Doc 与 Code 联动
大模型与 Coding Agent 让“生成代码”变得容易,但在真实研发流程中,企业遇到的核心矛盾已经从“能不能写”转向“能不能稳定交付、能不能容易落地”:需求理解与实现经常漂移,AI 产出缺少一致性约束,质量与回归验证成本被放大;同时如果“人 / Agent”无法在同一迭代内顺畅切换(交接成本高、上下文补齐不成体系),AI 往往只能停留在局部试点,难以规模化复制。
与此同时,AI 工具与平台迭代速度极快,很多自研流程或能力很快会被更成熟方案替代。真正长期有效、且形成组织差异化竞争力的,是部门级研发资产:规范、契约、知识、门禁、测试证据、历史经验的结构化沉淀和项目级基座。
本次分享聚焦:我们如何将 AI 从“个人效率工具”升级为“可复制的工程能力”——以 PRD→上线 SOP 为骨架,以工程资产化为底座,用“Work Item 最小交接包 + 单一事实源 + 门禁化流程”让人/Agent 可自由接力;并在小范围探索 DeepWiki 类的 Doc↔Code 双向联动与 git diff 驱动测试验证,让 AI 的价值可承接、可验证、可演进。
演讲提纲
- 从 Vibe 到交付:为什么“模型更强”依然不够
- AI Coding 的三类交付性问题:发散、漂移、不可验证
- 企业级落地的目标:可承接 / 可回滚 / 可度量 / 可规模化
- 真正卡点不是“会不会写”,而是“能不能接得住 + 换得动”(人/Agent 自由切换)
- PRD→上线 SOP:让 AI 进入“确定性交付”链路
- PRD 自然语言如何转化为可版本化的 Spec/契约输入
- 接口与约束前置:单一事实源(契约、口径、权限、验收点)
- 研发阶段:AI 参与边界与门禁化协作(模板/规范/结构化 PR)
- Review 与测试:从“看实现”到“核对契约 + 验证证据”
- 上线与治理:线上信号回收 → 反哺规范/测试/资产库
- Hybrid Execution Protocol(混合执行协议):同一迭代内按 Work Item 粒度“人/Agent 自由切换”
- 缺口门禁:Agent 先自检缺口→问题清单→补齐→再 plan→code→verify
- 工程资产:让 AI 稳定输出的“护城河”
- 项目级资产:Spec、接口契约、验收清单、埋点/稳定标识、回归策略
- 团队级资产:组件/模板、规范、风险模式库、测试资产
- 部门级资产:质量门禁、评测口径、历史缺陷与影响面知识
- 工具会快速迭代,资产决定长期复利
- Repo OnBoarding(存量冷启动):一次性生成 MVP 项目基座 + 后续“文档自然长出来”的增量机制
- Doc 与 Code 双向联动:从“文档同步”到“工程事实回流”
- 基于 DeepWiki / deepwiki-open 的代码库语义化入口
- 需求→代码:从 Spec 定位实现与风险点
- 代码→文档:从接口/测试/变更生成“证据摘要”,降低漂移与知识断层
- git diff 驱动测试验证(试点):变更触发的验证闭环
- diff → 结构化变更信号(接口/schema/权限/关键模块/SQL 等)
- 影响面映射 → 回归集推荐(必须跑/建议跑/可跳过)
- 验证证据产出:把“回归选择与结果”沉淀为可追溯资产
- 目标:把“靠经验选回归”升级为“可解释、可复算”的变更验证
- 未来一年:标准化、闭环化、基座化
- 资产标准化:面向新人/实习生/全栈初尝者的上手路径(模板、清单、示例库、门禁)
- Doc↔Code 闭环跑通:需求变更与工程事实的双向回流
- 部门级资产基座化:以资产驱动的 AI 全栈 Advisor(建议/风险/验证路径)
这样的技术在实践过程中有哪些痛点?
- PRD→Spec 的图片信息不稳定:当关键交互依赖截图/大图表达时,模型对状态/边界/异常分支抽取容易偏差,导致 spec 口径漂移;需要通过“关键交互文本化/状态机化/验收清单化”补齐。
- Repo 深度扫描的安全 vs 准确率两难:DeepWiki 类全量扫描在企业环境存在权限/数据出域等安全顾虑;deepwiki-open 等本地化方案在复杂仓库上准确率不足,短期难成为唯一事实入口,只能先走“迭代归档 + 基座增量生长”的渐进路线。
- Token 成本:复杂任务天然 token 大、优质模型单价高。 当进入“多轮补齐 + 结构化 Review/归档”这类重推理场景时,即使流程做得很规范,token 消耗仍会显著上升,带来直接费用压力。
演讲亮点
- Hybrid Execution:人 / Agent 自由切换:同一迭代按 Work Item 最小交接包推进,任何时刻都能把任务从人切给 Agent、或从 Agent 切回人而不中断。
- /implement 内置“缺口门禁”:不是人判断上下文够不够,而是 Agent 先做缺口扫描并输出问题清单;补齐到阀值后才进入 plan → code → verify。
- 补齐后自动回写,治理漂移:人补充信息后,Agent 自动判断是否需要同步更新 design / spec / 项目基座,用“回写”锁住一致性。
- Repo OnBoarding:老项目冷启动:先用初始化 Skills 扫目录/入口/依赖/公共模块/历史坑位,产出 项目级 MVP 基座文档;后续迭代增量回写,文档自然生长。
- 单一事实源:四类资产把输入面写死:spec(语义基线)+ design(Work Item/验收)+ 基座(宪法/约束)+ OpenAPI(接口事实源),让 AI 写代码不靠“聊天记忆”。
- 提测前 Review + 测试补充建议:Review 不止审代码:基于 diff + spec + 测试用例清单,输出技术问题清单 + 用例增量建议/必跑回归,降低漏测。
- 上线后迭代归档 + 基座回写:上线稳定后用 diff 生成版本归档:改了什么、影响什么;并自动判断是否需要更新项目基座。
听众收益
- 一套可复用的 PRD→上线 AI 交付 SOP(如何定义输入基准、过程约束、结果门禁);
- “工程资产驱动 AI”的方法论:哪些资产最关键、如何沉淀为组织能力;
- Hybrid Execution:人 / Agent 自由切换的落地方法;
- Doc↔Code 双向联动的落地思路:如何用 DeepWiki 类能力降低需求—实现漂移;
- Repo OnBoarding:老项目冷启动与“文档自然生长”机制;
- Doc↔Code + diff 驱动验证的闭环框架;
- 面向未来一年的演进路线:从团队能力到部门级资产基座,再到 AI 全栈 Advisor。
本专题下其他演讲
关注主办方(InfoQ)


联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手