金煜阳,工学博士,清华大学计算机系助理研究员。国家重点研发计划国际合作项目负责人。CCF高性能计算专委会执行委员。主要研究领域包括并行应用性能分析与优化、高性能人工智能系统。在并行计算与系统领域顶级会议和期刊SC、PPoPP、ATC、EuroSys、IEEE TPDS等发表论文16篇,出版专著2部,研究成果获IEEE TPDS 2022最佳论文Runner-up奖。主持或参与国家级项目4项、省部级项目1项。担任清华大学学生超算团队指导老师之一,指导团队3次获得世界冠军。获CCF体系结构优秀博士学位论文激励计划、清华大学优秀博士学位论文、博士后创新人才支持计划等。
讲师介绍
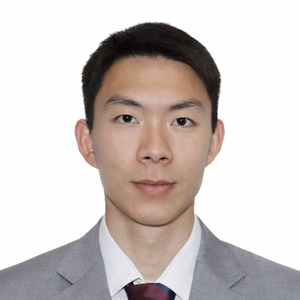
专题演讲嘉宾:金煜阳 博士
清华大学助理研究员
议题介绍
地点:富力2
所属专题:大模型算力优化
演讲:大模型推理加速全链路:内存管理、编译优化、量化与并行策略
大模型赋能千行百业,其推理系统作为支撑引擎,面临着推理成本高的挑战。本报告将从内存管理、编译优化、模型量化和并行策略四个关键维度,深入剖析大模型推理系统的关键技术。本次分享将探讨高效的内存管理方法、编译优化、模型压缩与量化,以及并行推理策略,为构建高效、低成本的大模型推理系统提供参考。同时,我们针对国产智能算力研制了“赤兔”大模型推理引擎,有效提升国产算力上大模型的推理效率。
- 人工智能产业背景与大模型推理现状
- 产业发展与中美对比
- 大模型推理核心痛点
- 推理过程与模型发展趋势
- 大模型推理系统的五大核心关键技术
- 大模型推理系统算子优化
- 算子优化的行业实践与硬件挑战
- 算子优化两大方向与实验室成果
- FlashTensor系统设计与实验效果
- 大模型推理内存管理技术
- 内存管理的核心重要性
- KV Cache现有优化思路
- 异构大模型内存管理挑战
- Jenga系统设计与实验效果
- 大模型推理模型量化技术
- 模型量化的核心意义
- 当前主流量化方法及优劣
- 混合精度量化的核心挑战
- MIXQ系统设计与多平台实验效果
- 大模型推理异构调度技术
- 推理负载的两类异构性
- 异构硬件资源的特性差异
- 异构调度核心解决方案
- FastDecode系统设计与实验效果
- 大模型推理并行优化技术
- 并行推理的必要性
- DeepSeek并行优化行业实践
- 并行优化面临的核心挑战
- 动态并行策略调优方案
- 国产大模型推理与训练系统研发
- 赤兔推理引擎研发背景与核心能力
- 赤兔引擎在多硬件平台的性能表现
- 八卦炉训练系统的组成与实验成果
- 研究总结与核心结论
- 降低推理成本对产业落地的重要性
- 推理加速需算法、软件、硬件协同优化
- 系统软件对释放硬件潜力的核心价值
- 系统创新打破算力依赖的产业范式
这样的技术在实践过程中有哪些痛点?
- 未发挥开源方案vLLM、SGLang等系统的性能优势。
演讲亮点
- 前沿场景的技术探索:长序列算子优化、混合注意力模型内存管理。
听众收益
- 前沿场景的技术探索;
- 国内开源推理系统的水平;
- 国产芯片与英伟达的水平对比。
关注主办方(InfoQ)


联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手