随着大模型和智能体系统进入规模化应用阶段,算力已从技术资源转变为核心生产成本。无... 展开 >
大模型算力优化
会议室:富力2出品人:汤雄超 博士
- Topic 1
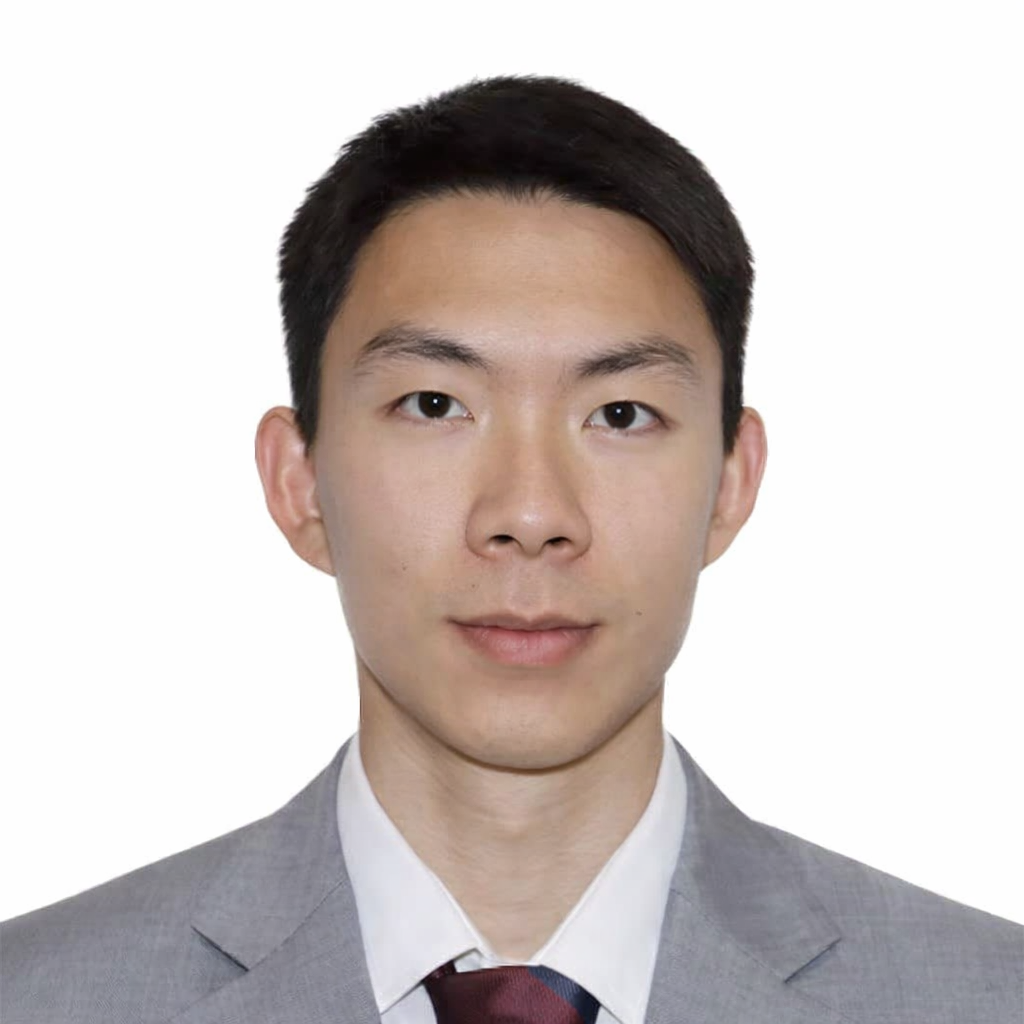
金煜阳 博士
清华大学 助理研究员 - Topic 2
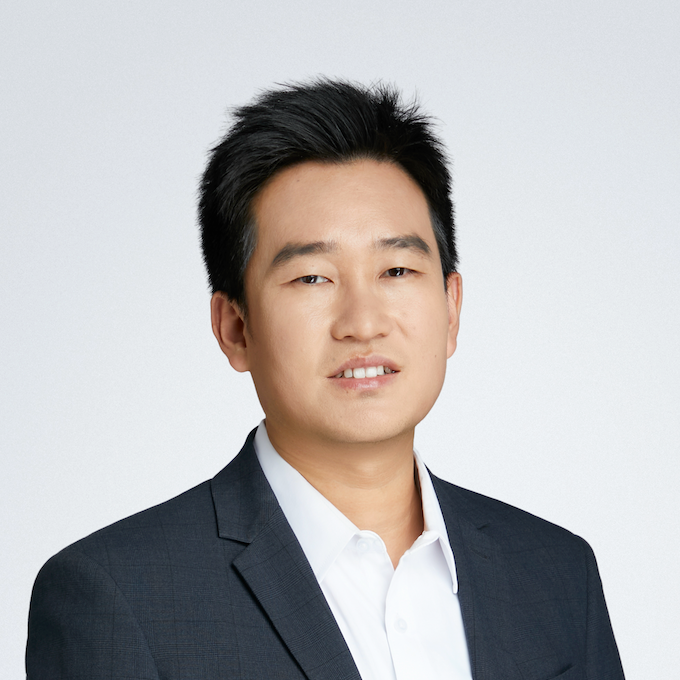
李秀红 博士
无问芯穹 技术副总裁 - Topic 3
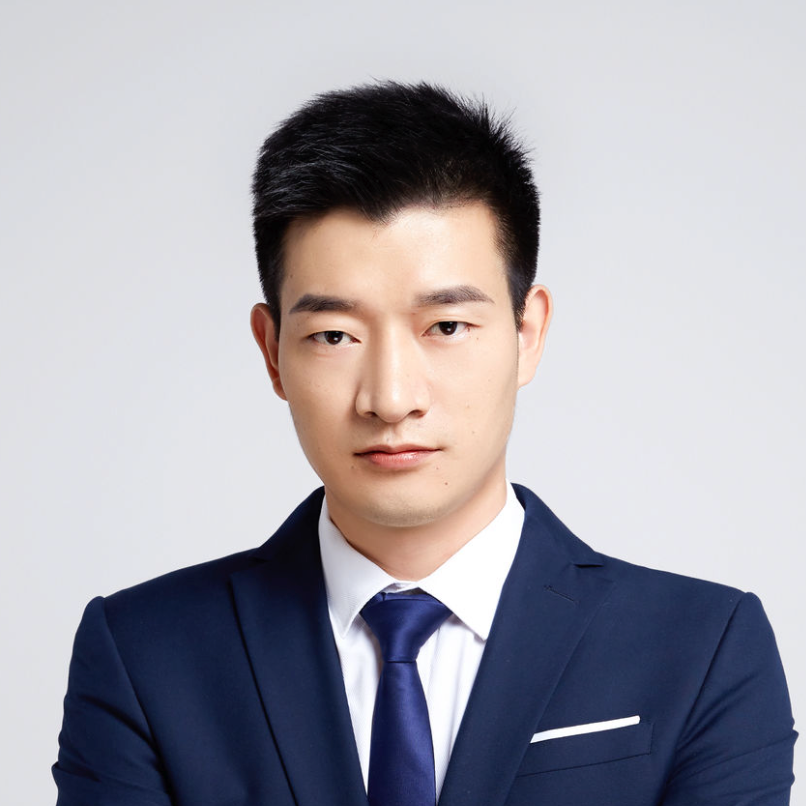
安江华
蓝耘科技 CTO - Topic 4
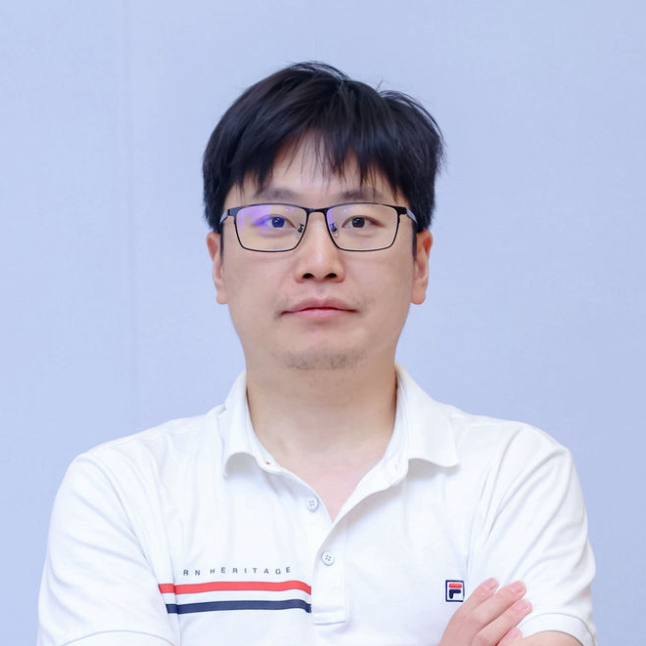
杨培军
京东 架构师
专题出品人:汤雄超 博士
清程极智 CEO
2019年博士毕业于清华计算机系。主要研究领域为性能分析及性能优化、并行计算、异构计算、集群资源调度等。发表CCF-A类论文十余篇,申请发明专利多项。现担任清程极智科技有限公司CEO。
地点:富力2
专题:大模型算力优化
随着大模型和智能体系统进入规模化应用阶段,算力已从技术资源转变为核心生产成本。无论是自建集群的大型公司,还是依赖云计算的中小团队,如何在保证算法效果的前提下降低算力消耗,正成为 AI 工程成败的关键因素。本专题聚焦模型训练与推理过程中的工程实践与效率问题,包括推理加速、低成本训练、在线/离线协同与资源优化。重点在于持续降低为获得满足业务需求的模型效果所需要消耗的算力成本。
by 金煜阳 博士
清华大学
助理研究员大模型赋能千行百业,其推理系统作为支撑引擎,面临着推理成本高的挑战。本报告将从内存管理、编译优化、模型量化和并行策略四个关键维度,深入剖析大模型推理系统的关键技术。本次分享将探讨高效的内存管理方法、编译优化、模型压缩与量化,以及并行推理策略,为构建高效、低成本的大模型推理系统提供参考。同时,我们针对国产智能算力研制了“赤兔”大模型推理引擎,有效提升国产算力上大模型的推理效率。
- 人工智能产业背景与大模型推理现状
- 产业发展与中美对比
- 大模型推理核心痛点
- 推理过程与模型发展趋势
- 大模型推理系统的五大核心关键技术
- 大模型推理系统算子优化
- 算子优化的行业实践与硬件挑战
- 算子优化两大方向与实验室成果
- FlashTensor系统设计与实验效果
- 大模型推理内存管理技术
- 内存管理的核心重要性
- KV Cache现有优化思路
- 异构大模型内存管理挑战
- Jenga系统设计与实验效果
- 大模型推理模型量化技术
- 模型量化的核心意义
- 当前主流量化方法及优劣
- 混合精度量化的核心挑战
- MIXQ系统设计与多平台实验效果
- 大模型推理异构调度技术
- 推理负载的两类异构性
- 异构硬件资源的特性差异
- 异构调度核心解决方案
- FastDecode系统设计与实验效果
- 大模型推理并行优化技术
- 并行推理的必要性
- DeepSeek并行优化行业实践
- 并行优化面临的核心挑战
- 动态并行策略调优方案
- 国产大模型推理与训练系统研发
- 赤兔推理引擎研发背景与核心能力
- 赤兔引擎在多硬件平台的性能表现
- 八卦炉训练系统的组成与实验成果
- 研究总结与核心结论
- 降低推理成本对产业落地的重要性
- 推理加速需算法、软件、硬件协同优化
- 系统软件对释放硬件潜力的核心价值
- 系统创新打破算力依赖的产业范式
这样的技术在实践过程中有哪些痛点?
- 未发挥开源方案vLLM、SGLang等系统的性能优势。
演讲亮点
- 前沿场景的技术探索:长序列算子优化、混合注意力模型内存管理。
听众收益
- 前沿场景的技术探索;
- 国内开源推理系统的水平;
- 国产芯片与英伟达的水平对比。
by 李秀红 博士
无问芯穹
技术副总裁Agent 技术的应用落地对 MaaS 提出了更高的要求和挑战,其中最突出的挑战就是上下文长度显著提升,因此如何提升 KV Cache 的承载能力成为高性能 MaaS 系统的重要方向。本次演讲将会介绍无问芯穹提出的无损 KV Cache 压缩技术,我们发现 KV Cache 存储中有显著的冗余存在,可以获得接近 1.5 倍无损压缩。KV Cache 压缩既可以在 Prefill 阶段提升等效 KV Cache 容量,也可以在 Decode 阶段提升系统并发能力,从而显著提升推理效率。
演讲提纲
- Agent时代下大模型推理的新挑战
- 大模型上下文更长,显存所限,Decode阶段并发低
- Agent更强调多轮调用,命中率变化导致长度变化差异大,显存所限Prefill阶段命中率有提升空间
- KV Cache部分输入的成本模型
- Cache部分输入的理想成本模型
- 请求长度、命中率、引入内存和存储、Decode阶段对理想成本模型的修正
- KV Cache压缩机制
- KV Cache无损压缩机制和系统设计
- KV Cache压缩对Prefill阶段Cache命中率的提升机制探讨
- KV Cache压缩在Decode阶段对系统并发的提升价值探讨
- KV Cache相关未来技术探讨
演讲亮点
- 我们的方案是国际上首次提出了无损KV Cache压缩机制并应用到大模型推理系统中。
听众收益
- 量化理解KV Cache对于大模型推理系统的重要性。
by 安江华
蓝耘科技
CTO蓝耘元生代从0开始做 MaaS,从单节点调度,到大规模多集群多数据中心,从硬抗 MaaS API 流量洪峰,到分时调用,智能调度。解决了工作时间流量洪峰,闲时流量断崖下滑导致资源使用率低等一系列问题。实现了单天千亿 tokens 的稳定高效调用实践。
演讲提纲
- MaaS 调用方式的演变
- 网页对话模式
- API 模式
- 应用集成
- 桌面终端
- IDE
- Agents
- MaaS 资源调用规模和架构的演变
- 单机
- 单一集群
- 多集群
- 多机房
- 多供应商
- 通过单日千亿调用量的深度实践,让 MaaS API 网关跟上 AIGC 的快速迭代步伐
- 通过统一网关模块化设计,快速兼容新协议
- 通过区分业务场景分时调用,解决流量不均衡问题
- 通过多供应商智能调度,迎接流量洪峰
- 通过智能感知调度,解决机器的弹性扩缩容
这样的技术在实践过程中有哪些痛点?
人工智能市场变化太快,一个新的技术热潮迭代只要几个月时间,API 网关的复杂设计虽然解决了调度效率,但是在适应市场变化的过程中也要跟着快速迭代,这很考验蓝耘 MaaS 产研团队的技术迭代速度。
演讲亮点
行业中的 MaaS API 网关调度多是规模小功能简单调度不智能,蓝耘 MaaS API 网关通过技术和业务的特性来智能调度,很好的适应了大规模多集群多机房,非线性流量调度的场景。
听众收益
了解当前 MaaS 市场的调度痛点,增加智能调度的新思路。
by 杨培军
京东
架构师生成式推荐实现了推荐系统的范式跃迁,却因需同时适配 TB 级稀疏嵌入与十亿级稠密参数架构、满足电商场景百毫秒级时延的严苛要求,面临着巨大的工程落地挑战。通用 LLM 推理框架与生成式推荐 Workload 特性不匹配,传统 Beam Search 在大波束宽度场景下的访存、拷贝、调度瓶颈,严重制约了其规模化应用。本次分享将结合京东工业级落地实践,详解 xGR 高性能推理系统的核心技术创新、电商场景落地成果,以及生成式推荐推理优化的前沿探索方向。
演讲提纲
- 行业背景与技术挑战
- 生成式推荐实现范式跃迁,验证了 Scaling Law 的效果潜力
- 推荐系统TB级稀疏嵌入参数与LLM百亿级稠密参数,对推理优化提出更高挑战
- 搜推广场景百毫秒级时延、高并发的严苛要求,成为生成式推荐规模化落地的核心门槛
- 行业方案
- 通用 LLM 推理框架与生成式推荐 Workload 特性不匹配,无法工业级生产部署
- 传统Beam Search存在重复访存、Block频繁拷贝、计算效率低等核心瓶颈
- 技术方案&创新
- xAttention 分段 KV Cache 优化、xBeam 高效束搜索、xSchedule 全链路流水线调度
- 基于分段 mask 的融合 Kernel 设计,实现计算与访存的深度协同优化
- 核心成果
- 核心性能指标突破,性能超业界 SOTA 方案
- 电商核心场景的规模化应用实践
- 未来展望
- 架构全链路升级:实现多模态、多目标、多场景的融合建模与统一推理,探索端到端生成式推荐架构全场景落地
- 极致性能攻坚:探索 MTP 并行解码、DSA 稀疏注意力等前沿技术,支撑超大规模模型的低时延、高吞吐推理
- 软硬深度协同:深化 GPU 与国产异构芯片的联合优化,深度挖掘通信、计算、存储的硬件极限性能
这样的技术在实践过程中有哪些痛点?
- 系统设计、模型结构与底层硬件优化紧密结合,加上真实业务场景中的打磨与验证,通用性、扩展性需要进一步优化。
演讲亮点
- 面向生成式推荐场景的 xGR 全栈推理优化方案,攻克通用 LLM 框架场景适配不足的行业共性难题,相关技术成果投稿系统领域顶级国际会议 OSDI 2026;
- 核心性能达到业界 SOTA 水准,相比 TensorRT-LLM 等主流开源框架,端到端推理性能提升 1 倍;
- 方案完成电商核心业务场景规模化落地,经受住业务峰值流量考验,实现业务效果与算力成本双重优化。
听众收益
- 工业级生成式推荐推理的前沿实践与核心挑战,包括在真实业务场景中面临的关键问题,以及如何通过系统化技术方案实现高效落地和业务收益等。
关注主办方(InfoQ)
联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手