无问芯穹技术副总裁,在无问芯穹负责大模型推理和MaaS相关技术研发,支撑日均千亿到万亿级别的MaaS业务。本科与博士毕业于北京大学,香港中文大学博士后,研究方向为深度学习系统,曾任职于北京大学、商汤科技,相关研发成果以第一作者或通信作者获得CCF A类会议ASPLOS 2024最佳论文,CCF A类会议PPoPP 2019最佳论文提名。
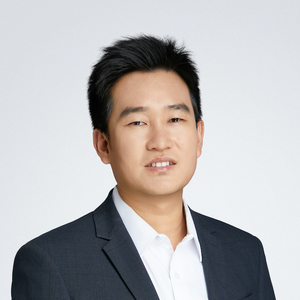
专题演讲嘉宾:李秀红 博士
无问芯穹技术副总裁
by 李秀红 博士
无问芯穹
技术副总裁Agent 技术的应用落地对 MaaS 提出了更高的要求和挑战,其中最突出的挑战就是上下文长度显著提升,因此如何提升 KV Cache 的承载能力成为高性能 MaaS 系统的重要方向。本次演讲将会介绍无问芯穹提出的无损 KV Cache 压缩技术,我们发现 KV Cache 存储中有显著的冗余存在,可以获得接近 1.5 倍无损压缩。KV Cache 压缩既可以在 Prefill 阶段提升等效 KV Cache 容量,也可以在 Decode 阶段提升系统并发能力,从而显著提升推理效率。
演讲提纲
- Agent时代下大模型推理的新挑战
- 大模型上下文更长,显存所限,Decode阶段并发低
- Agent更强调多轮调用,命中率变化导致长度变化差异大,显存所限Prefill阶段命中率有提升空间
- KV Cache部分输入的成本模型
- Cache部分输入的理想成本模型
- 请求长度、命中率、引入内存和存储、Decode阶段对理想成本模型的修正
- KV Cache压缩机制
- KV Cache无损压缩机制和系统设计
- KV Cache压缩对Prefill阶段Cache命中率的提升机制探讨
- KV Cache压缩在Decode阶段对系统并发的提升价值探讨
- KV Cache相关未来技术探讨
演讲亮点
- 我们的方案是国际上首次提出了无损KV Cache压缩机制并应用到大模型推理系统中。
听众收益
- 量化理解KV Cache对于大模型推理系统的重要性。
关注主办方(InfoQ)


联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手