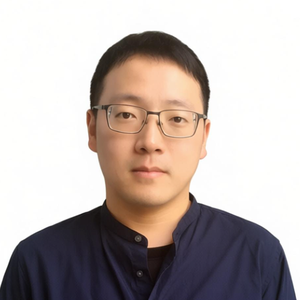
周祥,现任质变科技 MemoryLake首席架构师。曾任阿里云高级技术产品专家,负责数据库国际化战略与GTM,主导阿里云数据库 2020 首次跻身 Gartner 云数据库魔力象限全球领导者并持续蝉联。在IBM Db2和大数据、阿里云数据库任核心研发,超20年研发经验。已获及申请技术发明专利 50 余项。
讲师介绍
议题介绍
演讲:构建 AI 的“第二大脑”:大规模多模态记忆平台技术实践
企业AI正从“对话玩具”走向“业务决策者”,但一个根本性瓶颈日益凸显:大模型拥有强大的思考能力,却缺乏持续、可信的记忆能力。就像一个每次见面都忘记你是谁的天才,无法在企业复杂业务中真正扎根。
我们提出一个核心判断:LLM是AI的“第一大脑”,负责思考与创造;记忆平台是AI的“第二大脑”,负责精准存储与知识管理。二者协同,才能实现从“能对话”到“会决策”的质变。
本次演讲将首次公开大规模多模态记忆平台的核心架构设计,分享在超10万亿级记录、亿级文档生产环境中沉淀的“记忆工程技术”实战经验。重点剖析:多模态记忆理解与结构化提取、记忆引擎的动态组织与推理、超大规模记忆的持久化与低成本检索等关键难题的破局思路。同时,我们将对比现有RAG、向量数据库等方案的局限性,阐释“以记忆为中心”的架构范式如何将企业隐性知识转化为可迭代、可追溯的记忆资产,真正驱动AI从Demo走向生产系统。
演讲提纲
- 企业 AI 落地的“失忆”困境
- 从“能对话”到“会决策”的鸿沟
- 现有方案的局限性
- AI“第二大脑”的架构设计与核心技术
- 从“数据为中心”到“记忆为中心”的范式转变
- 大规模多模态记忆平台三层技术栈详解
- 核心技术突破点
- 多模态数据统一表征与跨模态关联对齐
- 亚秒级的多跳推理查询引擎设计
- 分布式记忆计算与Sandbox安全隔离
- 记忆血缘追踪与推理路径可解释性工程实现
- 生产级实践的痛与解
- 在超大规模客户场景中踩过的坑
这样的技术在实践过程中有哪些痛点?
- 痛点1:多模态数据理解“最后一公里”
- OCR+通用模型在复杂业务表格、手写批注、会议录音情绪识别上频繁失效
- 痛点2:记忆规模膨胀后的检索成本失控
- 10万亿级记录下,向量检索延迟与精度不可兼得
- 痛点3:企业客户“黑盒恐惧”
- 不接受不可解释的决策,不接受不可干预的系统
听众收益
- 理解AI“失忆”问题的技术本质,获得判断下一代AI基础设施的核心视角——记忆是智能体的关键瓶颈,而非模型能力。
- 带走一套经过10万亿级生产环境验证的“记忆工程”技术栈拆解,涵盖多模态理解、记忆组织、超大规模存储与检索等关键模块的设计思路与踩坑经验。
- 掌握企业级记忆平台的核心评估维度(记忆组织能力、推理能力、可解释性、生产规模验证),能够在RAG、向量库、仿生记忆系统与专业记忆平台之间做出理性技术决策。
- 了解企业隐性知识数字化的三个阶段——决策轨迹采集、记忆化工程、认知状态构建,并获取可在业务中复用的实践清单。
- 提前了解MemoryLake在多模态视频理解、具身智能记忆等方向的演进路线图,为企业技术规划提供前瞻输入。
关注主办方(InfoQ)


联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手