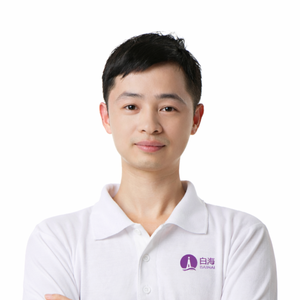
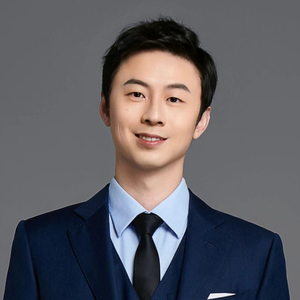
卢亿雷,白海科技创始人兼CEO。CCF大数据专委常务委员,CCF高性能专委委员,北航特聘教授,中国大数据技术大会主席,2017年中国大数据行业领军人物。拥有超过15年的大数据和AI计算平台领域经验,曾在在百度、联想、明略科技等公司负责高性能计算、AI基础平台等相关技术及产品。具有丰富的产品技术架构及管理经验,曾负责复杂且大型的系统架构和产品项目,服务过宝洁、百胜中国、建行、宝马等客户,赢得了客户的深度信任。
讲师介绍
议题介绍
地点:首府2
所属专题:Agentic Engineering
演讲:DeepResearch X OpenClaw:实现路径与 Token 成本控制
Deep Research(深度研究)智能体能够自主规划、检索、分析并生成结构化研究报告,但从原型到可服务真实用户的生产系统之间存在大量工程化挑战。本次分享将围绕我们在 Deep Research 智能体服务化过程中的实践经验,涵盖长时任务的通信架构选型、多阶段异步任务的进度追踪与增量输出、多格式报告生成与文件引用还原、多租户账户隔离与三层配置体系、以及多搜索引擎适配等核心技术问题。我们将坦诚分享每个环节中遇到的 tradeoff 与踩坑经验,帮助听众在构建类似长链路 AI Agent 服务时少走弯路。
演讲提纲
- 行业全景:Deep Research 的竞争格局与技术路线分化
- 2024–2025 年主流厂商密集发布deep research
- 成本差异驱动架构选择:从 $10/次到 $0.005/次,2000 倍的成本差距背后的技术取舍
- 开源生态的快速追赶与仍然存在的差距
- 一个关键判断:架构选择比模型选择更重要
- 被低估的工程化鸿沟
- 行业讨论充分的挑战:规划可靠性、幻觉控制、成本优化
- 被严重低估但决定用户体验的挑战:
- 长时任务的通信可靠性——当任务从秒级变为 20 分钟
- 模型输出到用户交付物之间的转换工程
- 从单一产品到多租户平台的服务化架构
- 长时 Agent 任务的通信架构
- 问题本质:MCP 解决了 Agent-工具通信,A2A 解决了 Agent-Agent 通信,但单个长时任务内如何可靠地向客户端传递增量状态,目前缺少成熟方案
- 流式推送 vs 轮询:各自的适用场景与局限性
- 增量输出与断点续传的设计思路
- 非确定性任务的进度反馈困境:业界主流的终止策略(固定上限、AI 自主判断 + 硬上限兜底、Depth×Breadth 可配、端到端 RL 自学)与我们的选择
- 多阶段任务编排与人机交互设计
- 设计哲学:在效率与控制之间给用户选择权
- 输入过滤:当用户在 Deep Research 模式下提出不适合深度研究的请求,C 端产品用"软引导",API 服务用"硬过滤 + 可开关"——同一问题的不同工程选择
- 需求澄清的形式化:自然语言 vs 结构化,不同场景的适配
- 研究规划的确认机制:跳过 vs 二次确认的灵活性设计
- 任务终止与资源释放:长时任务必须有的"紧急刹车"
- 报告生成与输出工程化
- 核心观点:模型输出 ≠ 用户交付物
- 多格式渲染管线(Markdown → PDF / Word / HTML)的工程挑战
- 纯文本 + 可视化报告的双模输出
- 引用来源还原:从模型占位符到标准化引用格式
- 文件持久化与按需获取——论文和博客中几乎不讨论,但生产中不可或缺
- 从产品到平台:多租户服务化架构
- 行业趋势:协议标准化(MCP/A2A)正在重塑 Agent 生态,但在标准完全成熟之前,生产团队需要自己解决服务化问题
- 多层配置体系:不同生命周期的配置需要不同的管理策略——系统级、账户级、调用级逐层覆盖
- 账户隔离与鉴权管理:多租户 Agent 服务的安全基线
- 数据监控:多维度交叉统计支撑运营决策
这样的技术在实践过程中有哪些痛点?
- 长时 Agent 任务的通信可靠性:SSE 在 20 分钟+ 场景下面临代理超时、连接断开等稳定性问题,但轮询引入了状态管理复杂性和延迟。
- 进度反馈的非确定性:用循环轮数比值表示进度,但模型可能提前结束或某一轮耗时远超其他轮次。所有非确定性 AI 任务都面临这个问题,当前没有完美解。
- 多格式报告的质量一致性。
演讲亮点
面向 20 分钟+ 长时 Agent 任务的通信架构实践:业界对 Agent 通信协议(MCP/A2A)讨论很多,但对"单个长时任务内的通信可靠性"讨论极少。我们分享了在轮询/SSE 混合方案中的增量输出、内容块编号、断线恢复等具体工程细节,这是生产环境中踩坑后沉淀的经验。
听众收益
- 获得长时 AI Agent 从原型到生产的完整工程参考:覆盖通信架构、多阶段编排、进度追踪、多格式输出、服务化的全链路方案,可直接借鉴。
- 理解实践与行业趋势(MCP/A2A 协议、Anthropic 多 Agent 架构、Agent 可观测性)的对应关系,形成自己的技术选型判断。
- 了解 Deep Research 类产品在生产环境中的真实 tradeoff 和踩坑经验,帮助在构建类似长链路 Agent 服务时少走弯路。
关注主办方(InfoQ)


联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手