依托 LangChain、AutoGPT 等框架及强大的 LLM API,构建基... 展开 >
Agentic Engineering
会议室:首府2出品人:柴思远
- Topic 1
桑梓森
阿里巴巴淘宝闪购 资深算法专家 - Topic 2
刘洋
去哪儿旅行 研发工程师 - Topic 3
何宇航
易点天下 中台研发总监 - Topic 4
陈彪
Zilliz 工程总监 - Topic 5
尹辰轩
北银金科 高级算法专家 - Topic 6
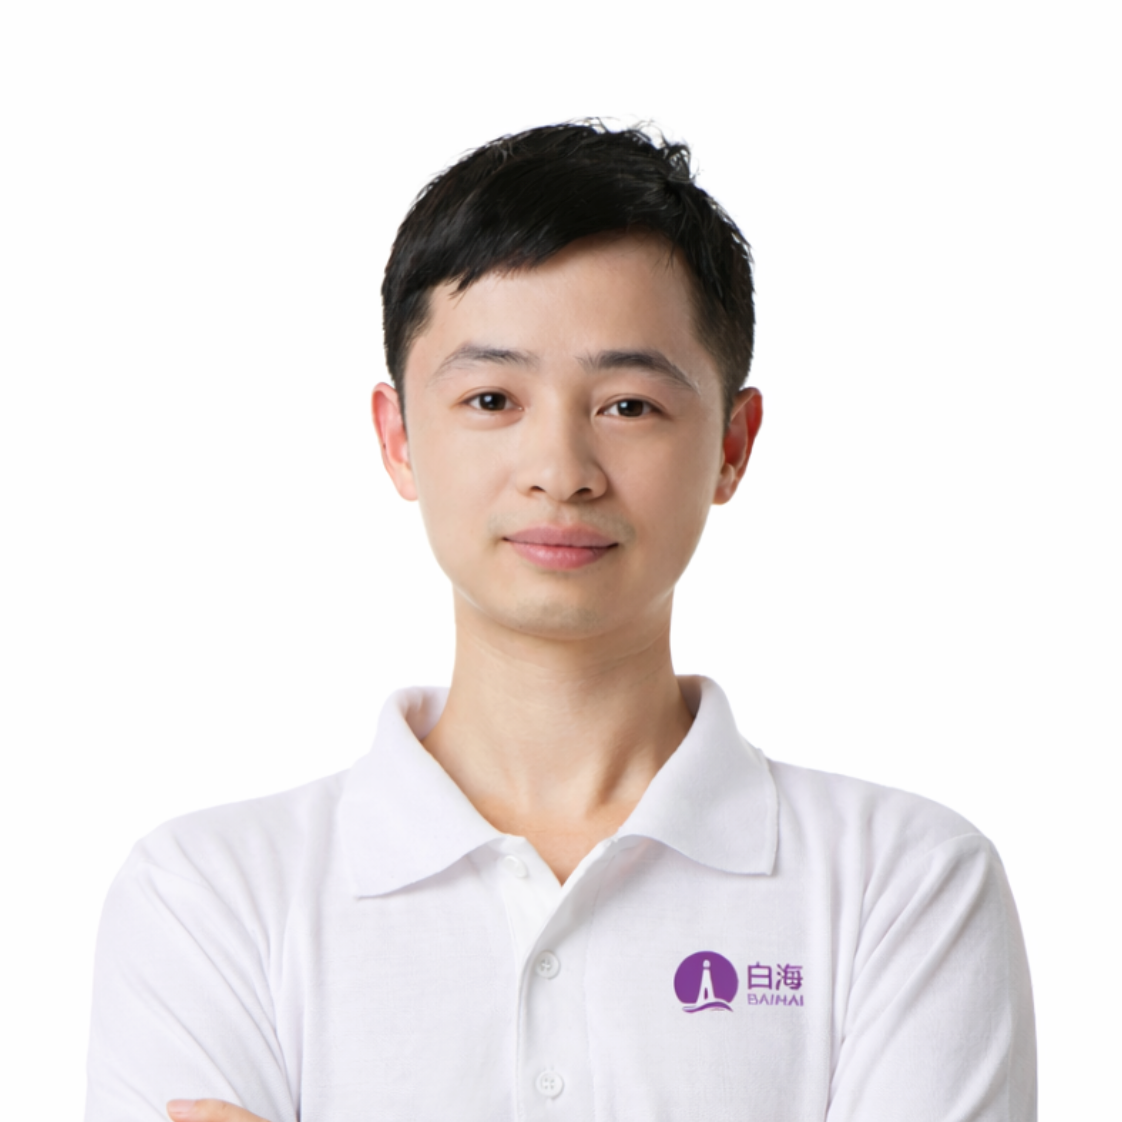
卢亿雷
白海科技 创始人&CEO - Topic 7
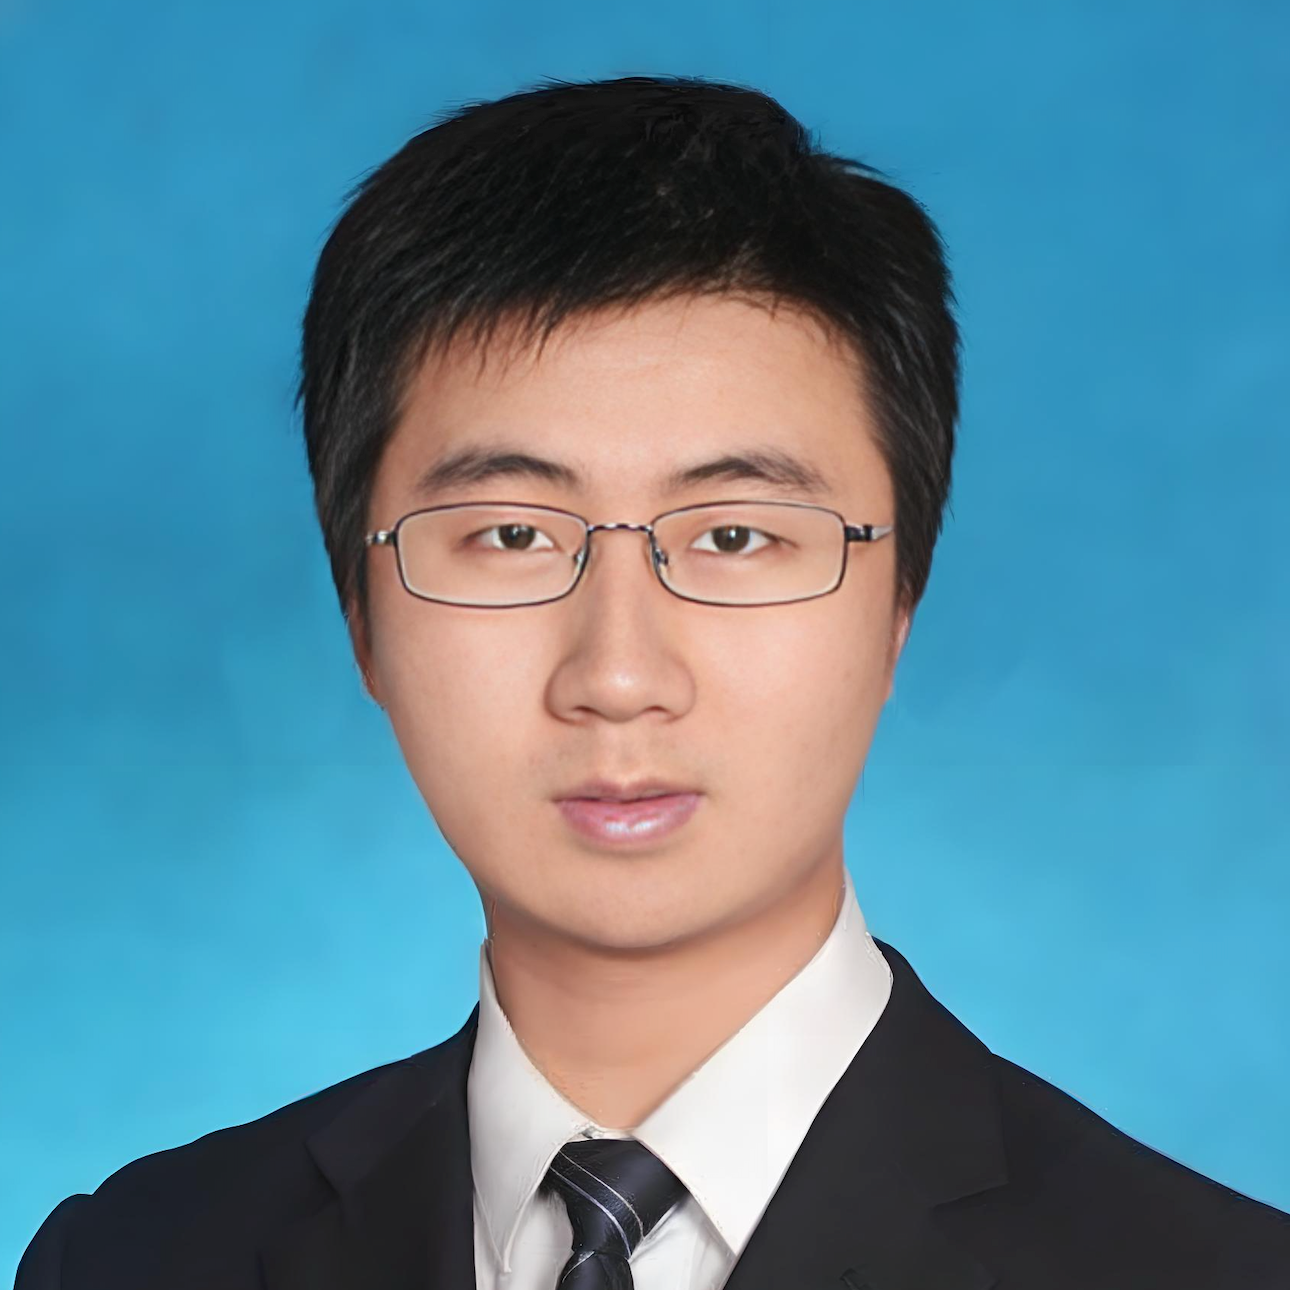
马云雷
阿里云 高级技术专家
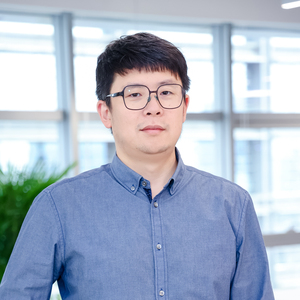
专题出品人:柴思远
智谱副总裁
柴思远,大数据算法技术专家,组建智谱解决方案团队,成功推动了大模型技术在多领域的突破性应用。深耕AI技术与企业智能化转型,带领团队与美团、360、金山、小米、小鹏、大众、荣耀等知名企业展开深度合作,为重点大模型项目落地提供强有力的技术解决方案,助力其实现智能化升级与业务创新。历任大搜车数据中台负责人,妙计旅行数据产品负责人,搜狗自然语言研究员等。
地点:首府2
专题:Agentic Engineering
依托 LangChain、AutoGPT 等框架及强大的 LLM API,构建基础智能体看似易如反掌,几行代码即可生成具备搜索、解析能力的 Demo。然而,一旦跨越实验室边界进入生产环境,这些“聪明的原型”往往面临严峻挑战。行业现状普遍陷入“PoC 满天飞,生产级系统寥寥无几”的尴尬。“上手容易”掩盖了“上线极难”的本质——即如何将概率性的大模型嵌入确定性极高的软件体系中。本专题聚焦平台工程,直面如下核心挑战:
- 复杂推理的稳定性构建:面对 LLM 幻觉与上下文限制,Agent 在长链任务中易“跑偏”或陷入死循环。如何通过工程手段高效构建与迭代 ReAct、ToT、Plan-and-Solve 等推理模式?
- 分层记忆与知识进化:智能体如何在长期任务中提取关键信息、遗忘噪音?如何实现从“静态知识库”到“动态经验库”的进化?结构化与非结构化数据如何实现高效融合检索?
- 工具调用的鲁棒性与风控:针对入参不稳定、格式幻觉、权限滥用及错误传播,如何设计高鲁棒性的 Tool Schema?API 调用失败时如何优雅降级?又该如何设计高效的“人类介入”流程?
- 可观测性与性能平衡:在非确定性输入下,如何科学评估 Agent 的生产力?如何可视化思维链以快速定位逻辑断裂点?如何在保证推理质量的同时,有效降低 Token 消耗与延迟?
专题受众
-
智能体开发工程师(前端/后端): 掌握从 Demo 到生产环境的系统架构设计能力。
-
智能体产品经理:深入理解当前大模型技术的边界与可行性。
-
智能体优化工程师(Prompt/算法): 突破单点调优的局限,获得复杂推理链路的优化方法论。
by 桑梓森
阿里巴巴淘宝闪购
资深算法专家淘宝闪购业务规模快速增长,对搜索推荐系统的效率与精准度提出了更高要求。传统搜推算法在特征工程、用户理解和商品表征上已逐步触及天花板。本次分享聚焦大模型时代下闪购搜推系统的技术演进,包括:
- LLM/VLM 等多模态大模型在 Query Processing(QP)、排序、召回、冷启动等搜推核心环节的落地实践;
- 在算力约束下,如何进行模型 Scaling Up 的工程策略优化及算法迭代;
- 生成式搜推新范式,包括基于 HSTU 的用户序列建模、RQ-VAE 的商品语义量化编码在召回与排序中的探索;
- 面向 AI 搜推场景,搜推核心链路的升级改造。
我们将结合真实业务场景,分享关键技术选型的决策过程、落地中的踩坑经验与效果数据。
演讲提纲
- 开场:闪购业务背景与搜推挑战
- 闪购业务特点、传统搜推瓶颈
- 大模型LLM/VLM 多模态在搜推全链路落地
- Query 理解与改写
- 商品理解与表征
- 召回与排序中的大模型特征注入
- 用户冷启动
- 算力 Scaling Up 策略
- 模型维度的 Scaling
- 训练与推理优化
- 算力 ROI 度量 torch 训推迭代
- 生成式搜推新范式探索
- HSTU 类在搜推探索落地
- RQ-VAE 生成式召回
- G-E生成式重混排落地
- 面向 AI 搜推的核心链路升级改造
- 总结与展望
这样的技术在实践过程中有哪些痛点?
- 搜推传统模型与大模型的对齐;
- 生成式范式落地中的坑点、工程以及算法之间的协同优化;
- AI 时代搜索的变化及解法。
演讲亮点
- 大模型与传统搜推深度结合:精排、召回、多模态训练等;
- 生成式技术演进与落地:RQ-VAE 等实践、G-E 生成式混排在搜推中的落地;
- AI 搜推面向千问场景的业务接入及迭代优化。
听众收益
1. 大模型能力在搜推全链路落地的算法与工程范式;
2. 生成式搜推(HSTU / RQ-VAE / G-E)从论文到生产的完整落地参考;
3. 面向 AI 时代,传统搜推与 AI 之间的结合。
by 刘洋
去哪儿旅行
研发工程师传统研发模式在运营场景下面临长尾需求多、开发成本高、ROI 不成立的问题。低代码形态的智能体平台有效降低了 AI 小软件的构建门槛,使非技术人员也能参与应用搭建。在智能体平台的搭建过程中,我们重点解决了性能与并发、稳定性与升级治理、Agent 可观测等平台级难题,并通过三个典型应用验证了智能体平台在规模化落地中的价值。
演讲提纲
- 为什么要重构运营
- 运营现状与痛点分析
- AI 小软件的价值与未来想象空间
- 支撑规模化落地的黄金组合:智能体平台 + 飞书
- 智能体平台建设
- 平台整体规划与架构设计
- 性能与并发优化策略
- 稳定性保障与升级治理方案
- Agent 可观测体系建设
- AI 小软件典型应用案例
- 成熟业务中的体系化落地实践
- 运营同学主导的工作流型应用搭建
- 产研同学构建的复杂 Agent 应用
- 落地效果与成果
- 年化提效超 1 万 PD,覆盖 100% 三级 Bu
- 产运团队独立维护 AI 小软件的能力培养
- 经验总结
- 在选场景、搭工具、提指标、拿价值这个过程中的一些可复用经验及踩坑指南
- 未来展望
这样的技术在实践过程中有哪些痛点?
- 智能体平台采用双系统架构:一方面是公司内部自研平台,具备高度稳定性和可控性,能够无缝集成内部组件;另一方面是开源平台,用于快速拥抱 AI 社区的最新能力。由于内部研发资源有限,开源系统作为补充,其低可控性带来了一定的维护和升级成本。
- 开源产品在技术选型和落地过程中,并非开箱即用的成熟系统,需结合业务实际进行深入调研和适配优化,可能涉及对开源代码的修改。我们坚持“最小化改码”原则,优先通过增量开发和外层封装,减少对原生代码的改动,降低升级风险和成本。
- 开源系统在高流量和复杂调用场景下,可能存在性能瓶颈,如页面卡顿等体验问题。为此,我们系统性梳理了平台调用链路,制定并实施多项性能优化策略,保障系统稳定和高效响应。
演讲亮点
- 双系统架构实践:结合公司自研平台与开源智能体平台,兼顾稳定性与快速迭代,解决复杂运营场景的技术挑战;
- 平台级性能与治理优化:针对高并发和复杂调用链路,设计并实施了性能提升、升级治理和系统稳定性保障方案;
- Agent 可观测体系建设:打造覆盖多平台的统一可观测方案,提升平台调试、监控和运维能力;
- 典型 AI 小软件应用落地:通过三个真实业务案例,展示智能体平台在不同角色和场景中的规模化应用与价值释放;
- 低代码赋能非技术人员:推动运营团队自主构建和维护 AI 小软件,提升整体运营效率,实现万级提效。
听众收益
- 运营团队:一种通用的 AI 提效方法及配套工具
- AI Infra 团队:了解智能体平台建设体系,及如何大规模落地
- 研发团队:了解一套提效 60% 的新研发模式,及 AI 落地场景挖掘思路
by 何宇航
易点天下
中台研发总监我们在 CI/CD 平台落地 AI Agent 处理构建分析与 K8s 运维,经历了两次架构重构。v1 ⽤低代码编排快速上线,三个⽉后问题集中暴露⸺相同的构建失败反复分析,Agent ⽆法积累经验;⼯具调⽤在多集群环境下幻觉频发;分类器边界误判不断,且错误会沿推理链放⼤。 v2 的核⼼⽬标是让 Agent 不再每次从零开始。记忆层⾯,我们设计了四层架构⸺从实时缓存、会话记录、⻓期模式库到经验学习层,通过主动注⼊⽽⾮被动检索让历史经验参与当前决策,⾼频修复模式可⾃动升级为可执⾏技能。⼯具层⾯,⽤配置驱动的 Guard 机制替代 Prompt 约束,从系统层保障⼯具调⽤的可控性。推理层⾯,前端路由⾃动解析为结构化上下⽂并动态收窄可⽤⼯具范围,让单 Agent 在多步任务中始终保持语境感知。
演讲提纲
- 平台化编排的能⼒边界与迁移时机
- 低代码编排的适⽤阶段与瓶颈复盘
- 迁移到⾃建编排的判断依据
- 四层记忆架构与经验进化
- 四层存储各⾃解决什么问题
- 主动注⼊ vs 被动检索的设计取舍
- 规则式提取与 LLM 深度分析的分⼯
- Pattern→Skill ⾃动升级链路
- 噪⾳控制与错误记忆的代价
- 配置驱动的⼯具调⽤治理
- Guard 机制:上下⽂绑定、重复检测、调⽤链校验
- MCP 主备降级策略
- ⼯具描述迭代⽅法论
- 上下⽂注⼊与推理链收敛
- 路由解析与动态⼯具过滤
- 多轮⼯具调⽤的收敛控制
- 落地效果与关键决策复盘
- v1→v2 的效果对⽐与核⼼指标变化
- 三个关键技术决策的选择逻辑与验证
演讲亮点
- 四层记忆架构的完整⼯程设计,含存储引擎、检索策略与性能约束
- 配置驱动的 Guard 机制:新⼯具只需配置元数据,⽆需改核⼼代码
- Pattern→Skill ⾃动进化闭环:从对话记录到可执⾏技能
- 两次重构的完整决策链:还原真实取舍过程⽽⾮只展⽰最终⽅案
听众收益
- 获得 Agent 记忆系统从存储到进化的可复⽤设计⽅案
- 掌握配置驱动的⼯具调⽤治理⽅法
- 理解上下⽂注⼊如何从架构层⾯保障多步推理稳定性
- 通过真实重构案例形成平台化编排 vs ⾃建的选型判断
by 陈彪
Zilliz
工程总监过去半年,Snowflake、Stripe、Sentry、Cloudflare、Google Workspace、飞书等多家主流软件厂商密集地给自己的产品加上了 CLI、MCP 或 Skills 接口——不是给人用的新界面,是给 Agent 用的。Sentry 的 MCP 月请求量已达 3000 万。软件的流量入口正在从浏览器迁移到 Agent。
OpenClaw 335K Stars 不是偶然。所有 Coding Agent 都解决了效率距离——Agent 帮你操作电脑。但 OpenClaw 通过 IM 接入解决了物理距离——人不再被困在电脑前,手机上发条消息就能指挥 Agent。这是它在 Claude Code 和 Cursor 之后还能爆火的关键。
我们在 Zilliz 内部做了 ZillizTown——选择 Claude Code 作为 Agent Runtime,在它周围构建企业接入层。本次演讲不讲"怎么用 Agent",讲"Agent 内部怎么工作"。我们会剖析 Agent 的 6 个关键工程点:上下文窗口的预算管理与 Context Engine、渐进式披露的分层设计、基于 memsearch + Milvus 的长期语义记忆、Skills 工程化与领域知识数字化、MCP 到 CLI+Skills 的演进趋势、Cron 定时调度与 A2A 多 Agent 协作。每个点都结合 ZillizTown 的真实架构和踩坑经验。
演讲提纲
- 入口在迁移,软件在改变
- 9 家厂商 12 个月集中适配 Agent 的行业证据与时间线
- OpenClaw 多做了哪一步:效率距离 vs 物理距离
- Skills 是新的 App:模型=CPU,Agent=OS,Skills=App
- 我们的选择:架构与技术选型
- ZillizTown 三层架构:Infra(飞书+Hub+Connector)/ Runtime(Claude Code)/ Personalization
- 飞书展示层:话题=Session,卡片=动态输出,Training 在飞书里,从终端到手机
- Agent 框架全景:编排派 vs 极简派,为什么选 Claude Code
- Claude Code 是 Runtime,ZillizTown 是企业接入层:50 万行代码封装工程复杂性,我们专注业务
- ZillizTown 的剖析:6 个关键工程点
- 上下文窗口:1M token 的物理本质、预算分配、Context Engine 四步循环、200K 到 1M 的问题变迁
- 渐进式披露:6 层暴露级别、Skills/MCP/Milvus 三种实现同一哲学
- memsearch + Milvus:解决 Claude Code 原生记忆三个短板,4 个生命周期 Hooks、混合搜索 dense+BM25+RRF、三层渐进式召回
- Skills 工程化:大模型是概率游戏,Skills 是缰绳。SKILL.md 的 description/allowed-tools/model 设计,78 个 Skills 的 Git 工程化管理
- MCP 的历史功劳与 CLI+Skills 的替代趋势:飞书出了 Lark CLI 但没出 MCP 的行业信号
- Cron 定时调度:传统 Cron 唤醒代码,Agent Cron 唤醒大脑
- A2A 协作:Skills=个人数字资产,通过 Hub 路由让别人的 Skills 为我所用
- 实战效果与总结
实践痛点
- Agent 的上下文窗口是有限预算,不是无限空间——怎么在有限空间里分层管理信息?
- 对话结束就遗忘,长对话被压缩丢细节——怎么做长期记忆?
- Agent 框架太多(LangGraph/CrewAI/OpenAI SDK/Claude Code...),怎么选?选了之后怎么做企业级落地?
- 大模型给很多方案但不知道哪个最优——怎么把人的领域经验注入 Agent?
- MCP 工具多了模型乱选——工具扩展的趋势在往哪走?
听众收益
- 理解 Agent 上下文窗口的物理本质和预算分配,掌握渐进式披露的分层设计方法
- 了解 2026 年 Agent 框架全景(编排派 vs 极简派),理解"不重造 Runtime,在 Runtime 上做企业扩展"的选型逻辑
- 带走一套基于 memsearch + Milvus 的 Agent 长期记忆方案(4 Hooks + 混合搜索 + 三层召回)
- 理解 Skills 工程化的方法(description 触发/allowed-tools 白名单/Git 管理),以及 MCP 到 CLI+Skills 的演进趋势
- 获得 ZillizTown 的真实架构设计(三层 + 飞书展示层 + Cron + A2A)和踩坑经验,回去就能借鉴
by 尹辰轩
北银金科
高级算法专家将多模态模型接入Agent中会有很多场景创新,比如将各类教材或培训材料,通过大模型解读,然后形成PPT和带数字人的演讲视频;再比如利用AI模仿真人与客服或销售对练,提高销售服务技巧。基于多智能体协同和大小模型协同,AI能够应用的场景范围脱离了聊天。当然,这个过程中,性能也会是相当重要的技术难点。
演讲提纲
- 多模态模型的快速进化推动AI应用场景扩充
- AI课程和AI陪练领域的一些应用
- AI课程实现逻辑
- AI陪练实现逻辑
- 技术上需要注意的点
- 流程编排中的模型引用要适当,不要追求大参数模型
- 知识库要慎用,会影响性能
- 多Agent协同和工作流要善用并行
- 在多模态接入过程中,尽量少用后端
演讲亮点
- 对多模态模型的优化(如PPT排版,数字人生成,性能优化)
- 技术架构的优化,尽量减少调用次数以提高性能
听众收益
- 应用场景的启发
- Agent在实际业务中的应用架构
- 关于多模态+Agent中性能的考量
by 卢亿雷
白海科技
创始人&CEODeep Research(深度研究)智能体能够自主规划、检索、分析并生成结构化研究报告,但从原型到可服务真实用户的生产系统之间存在大量工程化挑战。本次分享将围绕我们在 Deep Research 智能体服务化过程中的实践经验,涵盖长时任务的通信架构选型、多阶段异步任务的进度追踪与增量输出、多格式报告生成与文件引用还原、多租户账户隔离与三层配置体系、以及多搜索引擎适配等核心技术问题。我们将坦诚分享每个环节中遇到的 tradeoff 与踩坑经验,帮助听众在构建类似长链路 AI Agent 服务时少走弯路。
演讲提纲
- 行业全景:Deep Research 的竞争格局与技术路线分化
- 2024–2025 年主流厂商密集发布deep research
- 成本差异驱动架构选择:从 $10/次到 $0.005/次,2000 倍的成本差距背后的技术取舍
- 开源生态的快速追赶与仍然存在的差距
- 一个关键判断:架构选择比模型选择更重要
- 被低估的工程化鸿沟
- 行业讨论充分的挑战:规划可靠性、幻觉控制、成本优化
- 被严重低估但决定用户体验的挑战:
- 长时任务的通信可靠性——当任务从秒级变为 20 分钟
- 模型输出到用户交付物之间的转换工程
- 从单一产品到多租户平台的服务化架构
- 长时 Agent 任务的通信架构
- 问题本质:MCP 解决了 Agent-工具通信,A2A 解决了 Agent-Agent 通信,但单个长时任务内如何可靠地向客户端传递增量状态,目前缺少成熟方案
- 流式推送 vs 轮询:各自的适用场景与局限性
- 增量输出与断点续传的设计思路
- 非确定性任务的进度反馈困境:业界主流的终止策略(固定上限、AI 自主判断 + 硬上限兜底、Depth×Breadth 可配、端到端 RL 自学)与我们的选择
- 多阶段任务编排与人机交互设计
- 设计哲学:在效率与控制之间给用户选择权
- 输入过滤:当用户在 Deep Research 模式下提出不适合深度研究的请求,C 端产品用"软引导",API 服务用"硬过滤 + 可开关"——同一问题的不同工程选择
- 需求澄清的形式化:自然语言 vs 结构化,不同场景的适配
- 研究规划的确认机制:跳过 vs 二次确认的灵活性设计
- 任务终止与资源释放:长时任务必须有的"紧急刹车"
- 报告生成与输出工程化
- 核心观点:模型输出 ≠ 用户交付物
- 多格式渲染管线(Markdown → PDF / Word / HTML)的工程挑战
- 纯文本 + 可视化报告的双模输出
- 引用来源还原:从模型占位符到标准化引用格式
- 文件持久化与按需获取——论文和博客中几乎不讨论,但生产中不可或缺
- 从产品到平台:多租户服务化架构
- 行业趋势:协议标准化(MCP/A2A)正在重塑 Agent 生态,但在标准完全成熟之前,生产团队需要自己解决服务化问题
- 多层配置体系:不同生命周期的配置需要不同的管理策略——系统级、账户级、调用级逐层覆盖
- 账户隔离与鉴权管理:多租户 Agent 服务的安全基线
- 数据监控:多维度交叉统计支撑运营决策
这样的技术在实践过程中有哪些痛点?
- 长时 Agent 任务的通信可靠性:SSE 在 20 分钟+ 场景下面临代理超时、连接断开等稳定性问题,但轮询引入了状态管理复杂性和延迟。
- 进度反馈的非确定性:用循环轮数比值表示进度,但模型可能提前结束或某一轮耗时远超其他轮次。所有非确定性 AI 任务都面临这个问题,当前没有完美解。
- 多格式报告的质量一致性。
演讲亮点
面向 20 分钟+ 长时 Agent 任务的通信架构实践:业界对 Agent 通信协议(MCP/A2A)讨论很多,但对"单个长时任务内的通信可靠性"讨论极少。我们分享了在轮询/SSE 混合方案中的增量输出、内容块编号、断线恢复等具体工程细节,这是生产环境中踩坑后沉淀的经验。
听众收益
- 获得长时 AI Agent 从原型到生产的完整工程参考:覆盖通信架构、多阶段编排、进度追踪、多格式输出、服务化的全链路方案,可直接借鉴。
- 理解实践与行业趋势(MCP/A2A 协议、Anthropic 多 Agent 架构、Agent 可观测性)的对应关系,形成自己的技术选型判断。
- 了解 Deep Research 类产品在生产环境中的真实 tradeoff 和踩坑经验,帮助在构建类似长链路 Agent 服务时少走弯路。
by 马云雷
阿里云
高级技术专家当前,Agent 已成为企业执行复杂任务的核心载体。但在运维等深水区,开发者常面临“Demo 惊艳,落地乏力”的困境:面对海量异构的日志、指标与动态拓扑,Agent 极易产生幻觉,且性能与成本难以平衡。
本次分享将以云原生基础设施智能运维 Agent的研发过程为核心案例,深入探讨如何打破传统研发模式,构建以统一语义层UModel为底座、以数据飞轮为驱动的 Agent Engineering 新范式。我们将分享如何通过构建统一语义层UModel解决数据碎片化问题,以及如何通过在线运行时产生的实时数据,持续性的迭代提升Agent的质量,包括打造Agent的观测体系深入了解Agent的运行过程辅助debug,持续沉淀高质量数据集、通过高质量数据集持续做回归评估、模型训练,以及通过语义洞察能力、深入理解Agent的上下文演变过程,以及通过上下文context知识的沉淀,持续沉淀和用户的交互记忆,提升理解用户问题的准确率。
演讲提纲
- AIOps Agent 落地微服务场景的深水区挑战
- 复杂云原生架构下的故障模式:为何传统 RAG 无法处理动态拓扑与海量日志?
- Agent 规模化落地的核心障碍:语义断裂、不可度量、成本失控。
- 构建行业知识的本体:基于统一语义层UModel的世界模型
- 解决LLM对数字世界的理解鸿沟:如何将异构运维数据抽象为统一语义表述。
- 算子下推与大小模型协同:如何降低 90% 以上的 Token 消耗并提升响应时延。
- 案例展示:Agent 如何在统一地图上实现有方向的根因分析。
- 数据进化:从在线运行时数据到 Agent 可靠性飞轮
- 构建全链路观测体系: 如何通过高质量、无侵入的探针采集 Agent 运行时数据,实现对 Agent 执行路径的深度 Debug。
- 高质量数据集的持续沉淀: 从海量生产 Trace 中自动化提取、清洗出具有高置信度的数据集用于评估和RL。
- 自动化回归与评估: 建立基于实时数据的回归评估机制,确保 Agent 的每一次版本迭代、Prompt 修改或模型升级都“有据可依”。
- 记忆增强:基于 Context 知识沉淀的长程交互优化
- 从短期机器挖掘长期价值: 如何将 Agent 的上下文知识转化为长期记忆,沉淀用户交互习惯与专业运维经验。
- 提升理解准确率: 记忆系统如何辅助 Agent 更好地理解用户意图,解决语义理解的gap,减少重复问询,提升复杂问题的首轮解决率。
- 总结:Agent Engineering 的未来范式
- DevOps流程的变化:从Dev/Ops分离,到DevOps一体化。注重挖掘运行时数据的价值,持续性迭代Agent应用的质量。
这样的技术在实践过程中有哪些痛点?
- Agent 评测难: 解决基于 LLM 的评估系统置信度不高、End-to-End 指标过粗无法指导优化的问题。
- 数据利用率低: 解决线上运行的大量 Trace/Log 无法有效转化为模型进化资产的痛点。
- 落地门槛高: 提供一套从碎片化数据到结构化 Agent 决策的标准化路径。
演讲亮点
- UModel 统一语义层,解决LLM语义世界和数字世界的理解鸿沟;
- 在线数据飞轮,基于 Runtime Trace 持续迭代Agent的质量。
听众收益
- 深水区实战: 深入分享 AIOps 这一最复杂 Agent 场景的真实踩坑经验。
- 工程化范式: 完整介绍一套可复用的 Agent Engineering 方法论,涵盖从语义观测、分层评测到数据回流的全链路。
- 技术前瞻: 探讨统一语义层解决Agent幻觉和不可靠的问题,通过数据飞轮持续迭代提升Agent的质量。
关注主办方(InfoQ)
联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手