14年可观测行业经验,先后参与日志采集、查询、计算、向量搜索、大模型可观测等多个模块的建设,从0到1参与可观测体系的建设。阿里云可观测日处理百PB级数据,秒级别查询百亿数据。目前专注于结合Data + AI,探索Data for AI和AI for Data两个方向。基于多模态存储和检索、数据飞轮、Agent记忆等场景,赋能Agent的持续迭代、强化训练。在AI for Data领域,基于Agent的模式的NL2SQL获得了98%的可执行率,在AIOps Agent上持续迭代研发,在Agent的dev、ops上积累了实践经验,帮助打造更好的Agent数据基座。
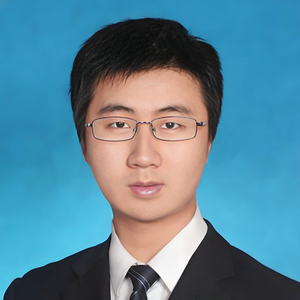
专题演讲嘉宾:马云雷
阿里云高级技术专家
by 马云雷
阿里云
高级技术专家当前,Agent 已成为企业执行复杂任务的核心载体。但在运维等深水区,开发者常面临“Demo 惊艳,落地乏力”的困境:面对海量异构的日志、指标与动态拓扑,Agent 极易产生幻觉,且性能与成本难以平衡。
本次分享将以云原生基础设施智能运维 Agent的研发过程为核心案例,深入探讨如何打破传统研发模式,构建以统一语义层UModel为底座、以数据飞轮为驱动的 Agent Engineering 新范式。我们将分享如何通过构建统一语义层UModel解决数据碎片化问题,以及如何通过在线运行时产生的实时数据,持续性的迭代提升Agent的质量,包括打造Agent的观测体系深入了解Agent的运行过程辅助debug,持续沉淀高质量数据集、通过高质量数据集持续做回归评估、模型训练,以及通过语义洞察能力、深入理解Agent的上下文演变过程,以及通过上下文context知识的沉淀,持续沉淀和用户的交互记忆,提升理解用户问题的准确率。
演讲提纲
- AIOps Agent 落地微服务场景的深水区挑战
- 复杂云原生架构下的故障模式:为何传统 RAG 无法处理动态拓扑与海量日志?
- Agent 规模化落地的核心障碍:语义断裂、不可度量、成本失控。
- 构建行业知识的本体:基于统一语义层UModel的世界模型
- 解决LLM对数字世界的理解鸿沟:如何将异构运维数据抽象为统一语义表述。
- 算子下推与大小模型协同:如何降低 90% 以上的 Token 消耗并提升响应时延。
- 案例展示:Agent 如何在统一地图上实现有方向的根因分析。
- 数据进化:从在线运行时数据到 Agent 可靠性飞轮
- 构建全链路观测体系: 如何通过高质量、无侵入的探针采集 Agent 运行时数据,实现对 Agent 执行路径的深度 Debug。
- 高质量数据集的持续沉淀: 从海量生产 Trace 中自动化提取、清洗出具有高置信度的数据集用于评估和RL。
- 自动化回归与评估: 建立基于实时数据的回归评估机制,确保 Agent 的每一次版本迭代、Prompt 修改或模型升级都“有据可依”。
- 记忆增强:基于 Context 知识沉淀的长程交互优化
- 从短期机器挖掘长期价值: 如何将 Agent 的上下文知识转化为长期记忆,沉淀用户交互习惯与专业运维经验。
- 提升理解准确率: 记忆系统如何辅助 Agent 更好地理解用户意图,解决语义理解的gap,减少重复问询,提升复杂问题的首轮解决率。
- 总结:Agent Engineering 的未来范式
- DevOps流程的变化:从Dev/Ops分离,到DevOps一体化。注重挖掘运行时数据的价值,持续性迭代Agent应用的质量。
这样的技术在实践过程中有哪些痛点?
- Agent 评测难: 解决基于 LLM 的评估系统置信度不高、End-to-End 指标过粗无法指导优化的问题。
- 数据利用率低: 解决线上运行的大量 Trace/Log 无法有效转化为模型进化资产的痛点。
- 落地门槛高: 提供一套从碎片化数据到结构化 Agent 决策的标准化路径。
演讲亮点
- UModel 统一语义层,解决LLM语义世界和数字世界的理解鸿沟;
- 在线数据飞轮,基于 Runtime Trace 持续迭代Agent的质量。
听众收益
- 深水区实战: 深入分享 AIOps 这一最复杂 Agent 场景的真实踩坑经验。
- 工程化范式: 完整介绍一套可复用的 Agent Engineering 方法论,涵盖从语义观测、分层评测到数据回流的全链路。
- 技术前瞻: 探讨统一语义层解决Agent幻觉和不可靠的问题,通过数据飞轮持续迭代提升Agent的质量。
关注主办方(InfoQ)


联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手