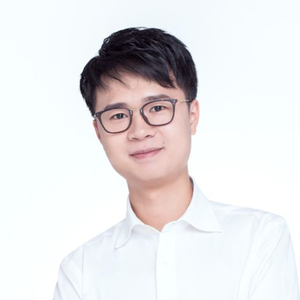
12 年软件工程从业经验,先后就职于钉钉、蚂蚁集团、美团,现任小红书质效技术部 GUI Agent 方向负责人。曾深度参与支付宝研发平台、钉钉文档等核心产品的质量与效能体系建设,在研发效能、自动化测试、前端工程化等领域有丰富的实战积累。当前聚焦于多模态大模型驱动的 GUI 自动化测试 Agent 技术,致力于探索从"脚本驱动"向"模型驱动"的测试范式转型,推动 UI 自动化测试从工具走向自主智能体。
讲师介绍
议题介绍
地点:富力1
所属专题:智能化测试与质量内建
演讲:小红书 GUI Agent 在智能化测试中的工程落地实践
传统 UI 自动化测试严重依赖预定义脚本和硬编码规则,维护成本随用例规模线性增长,且在业务快速迭代中极易失效。小红书电商业务高速增长,回归用例量持续膨胀,传统方案已难以为继。我们提出 UIRobot —— 一个基于多模态大模型的 GUI 自动化测试 Agent,实现了从"脚本驱动"到"模型驱动"的范式转型。核心方案采用 Code-as-Action 架构,Agent 生成可复用的测试代码而非逐步调用工具,结合分层知识库(经验级/产品级/需求级)与自我成长的记忆机制,实现用例的自动生成、自动执行和自动自愈。脚本固化后执行零 Token 成本,兼顾智能与降本。本次演讲将详细拆解这一架构的设计决策、关键技术卡点(环境准备、用例泛化、错误诊断)及真实落地中的踩坑经验。
演讲提纲
1. 行业趋势与小红书现状
- GUI 自动化从"脚本驱动"走向"模型驱动"的行业趋势
- 小红书电商场景的自动化测试挑战:用例膨胀、维护成本高、QA 人力紧张
- UIRobot 初期探索的三个核心瓶颈:缺乏自主理解、环境依赖人工、无法自愈
2. 技术选型与架构设计
- 竞品分析:美团 KuiTest、阿里 Assistant Agent、字节 MidScene 的优劣对比
- Code-as-Action 架构选型:为什么选择代码生成而非 ToolCall,如何兼顾可调试性与执行确定性
- 单 Agent vs 多 Agent 的权衡:默认单 Agent,能力不足时切换 SubAgent
- 执行引擎设计:抽象语义粒度操作函数,向上解决可读性,向下解决泛化能力
3. 分层知识库与记忆机制
- 三层上下文设计:经验级(通用测试经验)、产品级(操作图谱与历史记录)、需求级(PRD / Code Diff /接口协议)
- 分层记忆框架:L0 摘要层 → L1 概览层 → L2 详情层,按需逐层检索
- 记忆的自主沉淀:成功用例自动提取、失败修复方案自动存储、人工标注直接写入
- 记忆风险控制:置信度阈值、长期记忆上限 200 行、低价值内容自动淘汰
4. 用例泛化与自愈机制
- 泛化挑战:需求理解泛化、执行环境泛化、执行过程歧义处理
- 错误分类诊断:环境错误 / 执行错误 / 用例错误的自动区分与分级处理
- 自愈流程:自动修复→人工介入→修复方案沉淀为记忆的闭环
- 脚本固化降本:调优阶段消耗 Token,验证通过后固化为脚本,后续执行零成本
5. 落地实践与踩坑经验
- 最大工程卡点:造数与 Mock 环境的自动构造挑战
- "人的经验 "如何系统化为 Agent 可学习知识
- 质量同学看不懂生成代码的应对策略
- 核心指标与验收标准:执行成功率、自愈成功率、人工介入率、Token 消耗量
您认为,这样的技术在实践过程中有哪些痛点?
- 泛化能力与确定性的根本冲突:让模型自由发挥可获得更强的泛化能力,但会牺牲执行的确定性和可复现性。我们通过 Code-as-Action + 脚本固化的方式缓解,但生成阶段仍需反复调试
- 环境准备是最大的工程卡点:造数和 Mock 本身是反复探索的过程,目前只有资深专家才能准确构造测试环境,如何让 Agent 自主完成仍未完全解决
- 用例泛化的脆弱性:在一台机器上执行成功的用例,换台机器可能失败;产品稍有调整用例就失效。Agent 缺乏跨设备、跨版本的泛化能力
- 记忆管理的两难:记忆太少导致重复踩坑,记忆太多导致幻觉和错误决策,如何平衡沉淀与遗忘是持续挑战
演讲亮点
- 业界首个将 Code-as-Action 模式与分层记忆体系结合的 GUI 测试 Agent 方案:区别于美团 KuiTest 的平台化路线和字节 MidScene 的场景泛化路线,我们的方案同时解决了"可调试性"和"自我成长"两个关键问题——Agent 生成的代码可版本控制、可 CR、可复用,同时具备从失败中学习和自我迭代的能力
- 脚本固化实现零 Token 执行成本的工程创新:在生成和调优阶段充分利用大模型能力,验证通过后自动固化为确定性脚本,后续回归执行完全不消耗 Token,实现了智能化与成本可控的平衡,这是业界 GUI Agent 方案中少见的务实降本策略
听众收益
- 掌握 GUI Agent 从"概念验证"到"工程落地"的完整路径:了解如何在真实业务场景中构建具备自主学习、自动自愈能力的 UI 测试 Agent,避免停留在 Demo 阶段
- 获得 Code-as-Action + 分层记忆的架构设计方法论:可直接借鉴的技术选型思路(单 Agent vs 多 Agent、代码生成 vs ToolCall、分层检索 vs RAG),以及各决策背后的 tradeoff 分析
- 了解大模型驱动测试自动化中的真实痛点与应对策略:包括环境准备、用例泛化、错误诊断、记忆管理等关键卡点的实战经验,帮助团队少走弯路
关注主办方(InfoQ)


联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手