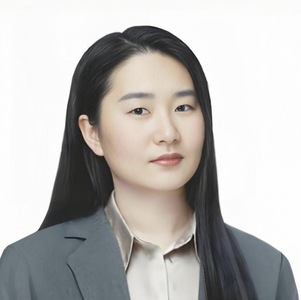
Sunny Duan,京东集团信息安全部 AI 安全实验室负责人,10 年以上信息安全相关经验,在京东主要负责大模型安全、大模型在安全场景的落地以及TEE能力建设推广工作。主导开源JoySafety大模型安全框架和JoySafeter安全Agent平台两个项目。
讲师介绍
议题介绍
地点:首府5
所属专题:智能体安全实践:可控与可靠
演讲:智能体安全:基于AI Native的防御架构和实践
智能体正在成为AI应用的核心形态,但其自主性、工具调用和多步推理能力也带来了独特安全挑战。相比传统应用安全,智能体面临Prompt注入、工具滥用、目标劫持、记忆投毒、执行失控等新型威胁。
本议题将从企业级Agent平台的安全实践出发,剖析智能体的五层攻击面模型,介绍京东安全基于JoySafety框架和JoySafeter平台构建的可控安全架构。重点分享:输入防火墙、Skills沙箱隔离、执行链管控、可观测性审计等核心能力的工程实现,以及如何实现安全左移和防御前置的智能体安全体系。
演讲提纲
- 智能体安全新挑战
- 从应用安全到Agent安全:核心差异分析
- 智能体安全三大特征:自主性风险、工具调用风险、多步推理风险
- OpenClaw真实安全事件剖析
- 五层攻击面模型
- L5 输入层:Prompt注入的100种变体与检测方法
- L4 记忆层:对话历史劫持与RAG知识库投毒
- L3 规划层:目标劫持
- L2 工具层:Skills参数注入与 MCP工具诱导
- L1 执行层:恶意操作识别与数据泄露防护
- 攻击链还原:端到端的攻击案例演示
- AI Native防御架构
- 防御理念:用AI防御AI,以智能对抗智能
- 五层防御体系:
- 输入层:Prompt Firewall + 对抗样本检测
- 记忆层:上下文完整性校验 + 知识库安全
- 规划层:目标一致性验证
- 工具层:Skills沙箱 + MCP-Scan
- 执行层:输出过滤 + 敏感数据脱敏
- OpenClaw 安全基因植入+安全能力构建新范式
- JoySafeter平台:安全Agent编排与自动化响应
- JoySafeter项目介绍:定位、架构与核心能力
- 安全Agent详解:
- Guardian - 全链路7×24小时Agent实时监控与威胁拦截
- 落地案例:京东内部智能体平台的安全实践2-3
- 开源Roadmap:社区共建计划与未来演进
- 总结与展望
- 核心观点:以安全为底座,塑造可信AI;以AI为引擎,重塑新安全
- 开源发布:JoySafety & JoySafeter Roadmap
- 技术趋势:Agent安全的发展方向
这样的技术在实践过程中有哪些痛点?
因为Skills、MCP等调用成功率无法确保完全准确,所以基于AI Native构建的方案也许持续探索,并确保有相应的兜底方案。
演讲亮点
- 首次系统性提出智能体五层攻击面,从输入到执行完整揭示安全风险;
- 基于OpenClaw的安全事件复盘,不是纸上谈兵;
- JoySafety框架+JoySafeter平台,会后可立即使用。
听众收益
- 理解智能体安全与传统安全的本质区别,掌握Agent安全的完整知识体系;
- 掌握Skills沙箱、行为监控、异常检测等核心安全能力的代码实现方法。
关注主办方(InfoQ)


联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手