Agent具备自主行动能力后,安全边界需前移,智能体可靠性是核心保障。本专题融合... 展开 >
智能体安全实践:可控与可靠
会议室:首府5出品人:韦韬 博士
- Topic 1
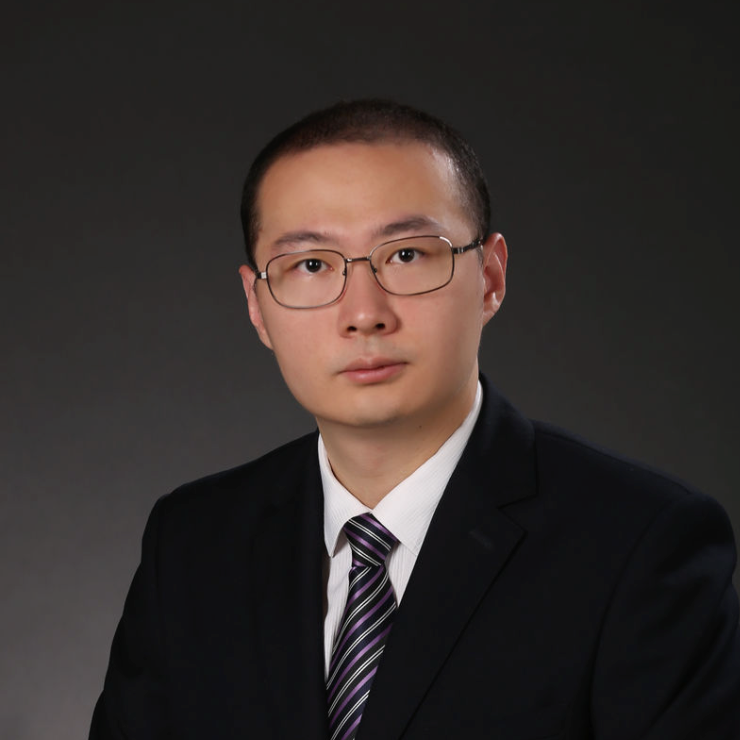
邱寒 博士
清华大学 副教授 - Topic 2
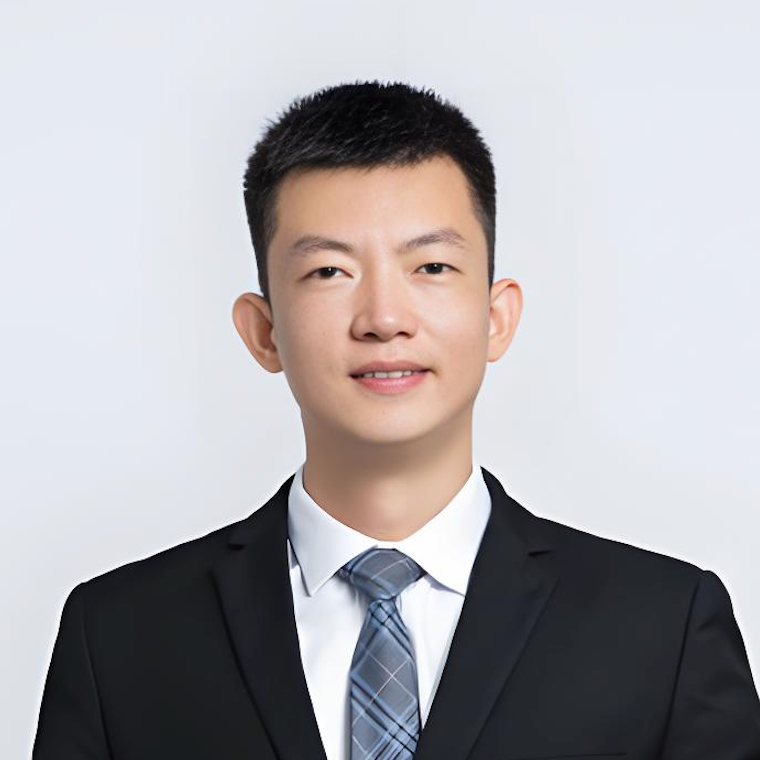
张栋
vivo AI 安全工程师 - Topic 3
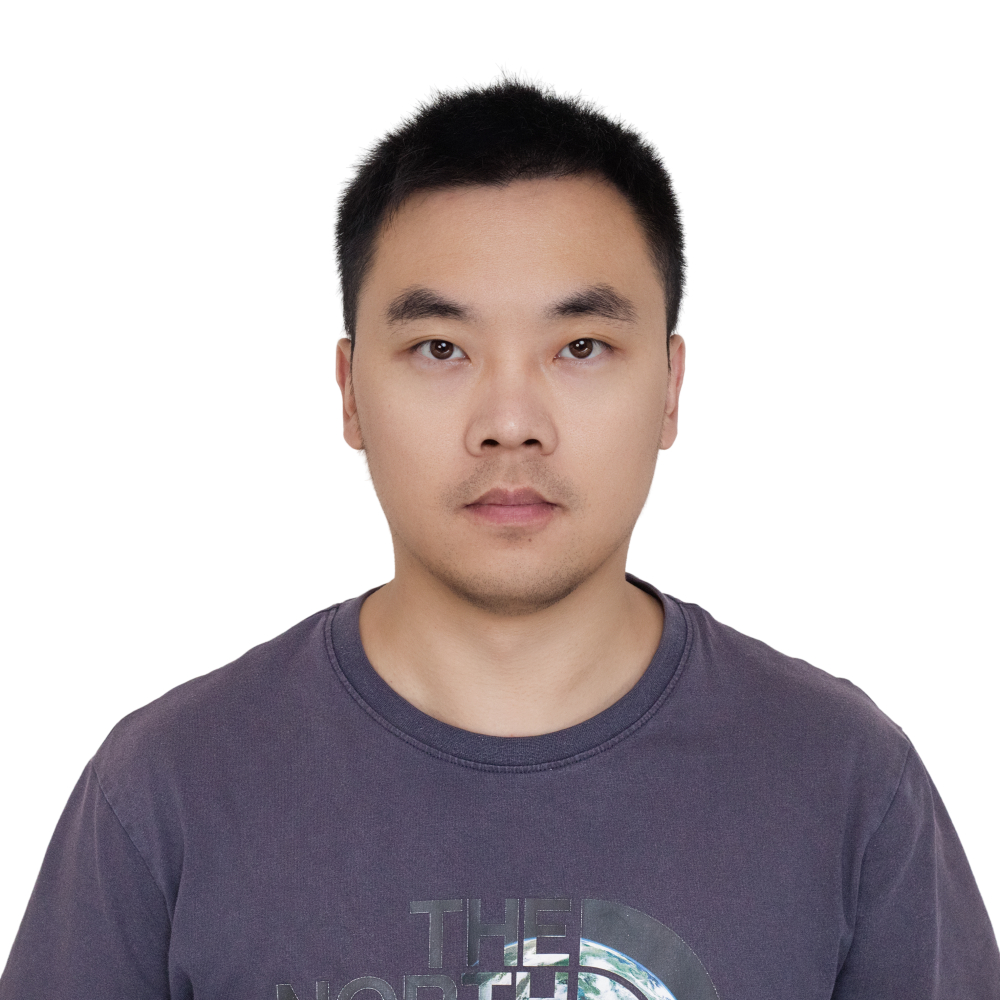
陈文波(闻计)
蚂蚁集团 支付宝终端技术安全团队负责人 - Topic 4
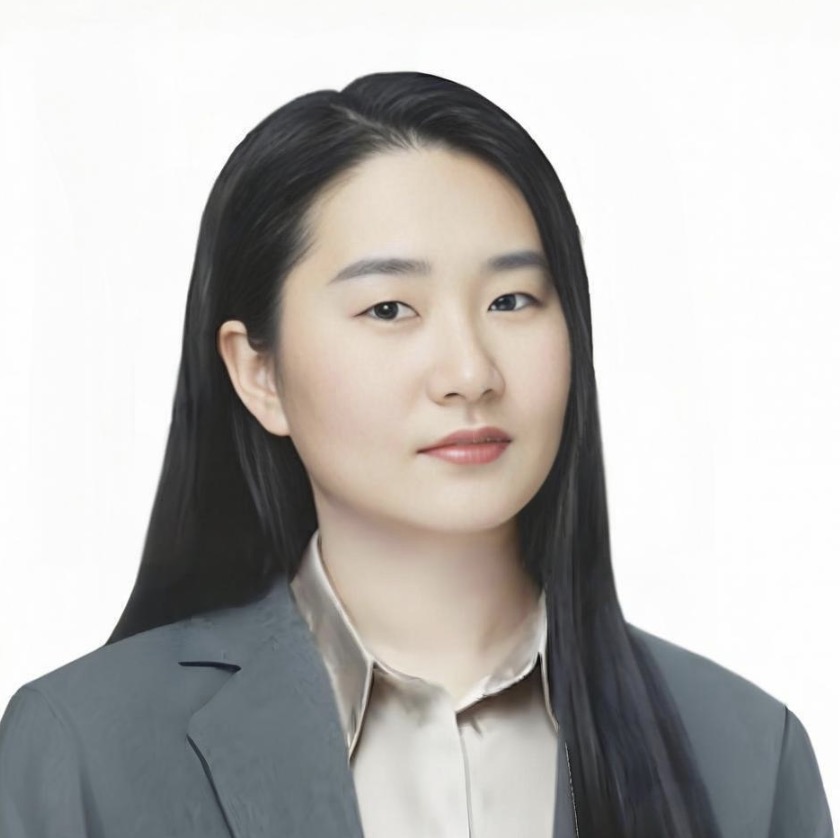
Sunny Duan
京东集团 信息安全部 AI 安全实验室负责人
专题出品人:韦韬 博士
蚂蚁集团副总裁兼首席技术安全官
韦韬,蚂蚁集团副总裁兼首席技术安全官,蚂蚁密算科技有限公司董事长,北京大学客座教授,九三学社浙江省委会数字经济专委会副主任,国家数据专家咨询委员会委员,全国数据标准化技术委员会委员,中国密码学会理事。发表学术论文近百篇,引用超过6300,获得授权专利四十余项,领导和推动了“隐语”、“星绽”等多项著名开源安全软件的研发。韦韬博士首创并率队实现了安全平行切面防御体系、密态计算技术体系、大模型高阶程序体系等,在网络安全、数据要素与人工智能应用等领域做出了重要贡献。韦韬博士因其杰出贡献获“2021年度数据智能新势力领军人物”、2022数字中国建设峰会“十大数字硬核科技奖”等奖项,蚂蚁密算也获评2025年世界互联网大会杰出贡献奖。
地点:首府5
专题:智能体安全实践:可控与可靠
Agent具备自主行动能力后,安全边界需前移,智能体可靠性是核心保障。本专题融合可靠性建设,聚焦权限控制、行为约束等要点,探索在不压制能力的前提下,实现智能体可控、可靠、可审计、可追责的路径,平衡技术价值与安全合规。
内容顾问:刘焱(兜哥),蚂蚁集团基础安全部副总经理,资深安全专家
by 邱寒 博士
清华大学
副教授人工智能技术正从以大语言模型为代表的对话模型,加速向能自主规划、调用工具、执行复杂任务的智能体,以及能够理解物理世界、进行预测和规划的“具身智能”演进。近期,OpenClaw这类可直接接入邮件、日程、文件和终端环境的智能体产品快速走热,但安全问题成为约束其落地的关键因素。本次演讲我将介绍针对智能体安全体系的思考和技术实践,包括针对智能体安全的评测、针对智能体行为的解释技术、以及针对智能体风险的防范方法。
演讲提纲
- 背景:从语言模型到智能体技术演进的必然性
- 从安全视角看待语言模型和智能体的本质区别
- Safety v.s. Security的分类机制
- 智能体安全评测的挑战与规划
- 如何解释智能体大脑(大语言模型)的行为
- 保障智能体安全落地的技术和预期
这样的技术在实践过程中有哪些痛点?
- 今天智能体演进速度很快,无论是什么安全方案必然存在滞后性。
演讲亮点
- 面向智能体安全的技术体系构建方法。
听众收益
- 获取构建智能体安全系统的落地路径;
- 针对大模型/智能体的可解释性技术与实践。
by 张栋
vivo
AI 安全工程师随着智能终端行业从“执行式智能”向“自主式智能(Agentic AI)”演进,AI系统的自主性、跨域规划能力及环境感知能力大幅提升,但也带来了前所未有的安全挑战。信任成为了AI治理的核心目标。面对神经网络的“黑盒”特性及复杂的供应链风险,传统的安全设计(Design)思路已难以为继,必须转向以发现(Discovery)为核心的治理模式。
本议题将分享vivo在AI业务安全治理中的实战经验,深度解析如何构建覆盖6大领域、103项风险条目的AI安全治理框架。重点阐述Red Team(红队)在业务全流程中的定位与实践,包括基于“思维偏误理论”的新型攻击探索、针对Agentic AI的威胁建模,以及在Deep Research、Code Agent及多模态推理等场景下的真实攻防案例,为行业提供一套可落地的端侧AI安全治理范式。
演讲提纲
- 演进与挑战:智能终端AI的安全新局
- 行业趋势:从执行式智能到Agentic AI(自主式智能)的跨越。
- 核心矛盾:AI能力的指数级增长 vs 信任链的脆弱性。
- 治理目标:建立以“用户信任”为核心的平衡体系。
- 治理框架:从理论到落地的“vivo模式”
- 利益相关方分析:针对用户、监管、供应商及内部的差异化策略。
- 全景防御:覆盖6大领域(如数据隐私、模型鲁棒性、Agent安全等)的103项风险条目。
- 思维转折:从工程设计的“Design”转向复杂系统的“Discovery”(3R治理思路:Regulate, Reveal, Respond)。
- 关键实践:Agentic AI Red Team体系构建
- 定位:Red Team在AI全生命周期中的“最后一道主动防线”。
- 方法论:融合MITRE ATLAS、OWASP LLM Top 10与NIST AI RMF的实战框架。
- 情报驱动:基于2024-2025全球高危AI安全事件的攻击链分析。
- 攻防实录:新型攻击方法与案例演示
- 威胁建模:针对Agentic AI系统架构(用户层到模型层)的威胁图谱。
- 攻击探索:基于“认知偏误”与“引导习得化倾向”的对抗样本构造。
- 实战案例:
- 案例一:跨应用自动化中绕过用户交互确认(UI伪造与指令注入)。
- 案例二:三方Deep Research能力的越狱与内部工具链泄露。
- 案例三:针对Code Agent的元数据投毒攻击。
- 案例四:多模态推理场景下的视觉指令注入。
- 展望:AI Red Team的未来趋势
- 行业共识与差异化发展。
- 趋势预测:Red Team的标准化、持续化及“AI辅助Red Team”的演进。
您认为,这样的技术在实践过程中有哪些痛点?
- Agentic AI Red Team自动化环境的“易碎性”
- 痛点: Agentic Red Teaming 高度依赖 APP UI 交互,但第三方 APP 版本更新极快,UI 微调都会导致自动化攻击脚本失效,维护成本极高。
- Trade-off: 我们放弃了全量覆盖。目前仅能保障 Top 50 高频应用的核心路径测试,对于长尾应用只能依赖通用的兜底策略,客观上存在覆盖盲区。
演讲亮点
- 端侧视角独特性:不同于通用的云端大模型安全,本议题聚焦于智能终端(手机)场景,深入探讨了Agentic AI在本地化部署、跨应用协作及多模态交互中的特有安全问题。
- “Design vs Discovery”的深度思考:引入复杂系统理论,提出了AI安全治理需从传统的工程设计思维转向适应性探索思维(3R治理思路),具有较高的理论高度。展示了vivo内部极其细致的风险评估体系(6大领域、26个二级类别、103项三级条目),为企业级落地提供了详实的参考坐标。
- 实战案例:披露了多个高价值的Red Team攻击实例(如Deep Research工具链泄露、Code Agent投毒),展示了真实的攻防对抗细节。
听众收益
- 获得一套可落地的框架:听众可以参考vivo的AI安全治理架构和风险评估体系,快速构建或完善自身企业的AI安全流程。
- 掌握Agentic AI威胁建模方法:了解针对自主智能体的全栈威胁点(从用户交互到底层模型),并学习如何开展针对性的Red Team演练。
- 洞察新型攻击技术:学习基于认知心理学(思维偏误)的对抗样本构造方法,以及针对多模态、工具调用等新场景的攻击技巧,提升防御视野。
- 前瞻行业合规趋势:了解全球AI法规对Red Team的具体要求,帮助企业在未来的合规竞争中提前布局。
by 陈文波(闻计)
蚂蚁集团
支付宝终端技术安全团队负责人我们正在从移动互联网时代迈进到AI时代,数字服务技术生态也正在从超级APP+小程序的模式向着智能体互联模式演进,AI技术的突破正在重构原有的技术生态。作为生活服务生态的超大型平台,支付宝在此背景下提出了“智能体互联”解决方案——AHA(Agent Hub Access),旨在连接手机、车机、眼镜等多端智能体,实现跨终端、跨生态的“所想即所得”服务革命。
支付宝AHA作为一个生态性的方案,在不增加方案复杂度、确保使用体验的前提下,如何通过优雅的安全架构设计实现其技术方案、互联协议、数据隐私的安全可信,将成为成败的关键。
基于此,我们对AHA方案进行了安全架构设计、安全流程保障和纵深防御体系建设,从协议安全、应用安全到数据隐私安全层面的全链路安全保障,为AHA生态打造了坚实的安全基础。
演讲提纲
- 支付宝AHA方案介绍
- AHA全链路安全体系思考
- 高质量安全架构定义
- AHA的安全保障原则
- AHA安全架构设计和落地
- 基于OVTP和NbSP安全范式的风险分析
- 安全方案设计落地
- AHA安全流程设计和运营
- AHA研发安全保障AI4SDL流程体系
- 智能体开放安全流程
- AHA纵深防御体系
- 总结思考和未来展望
演讲亮点
- 对智能体安全风险的深度理解;
- 智能体安全设计的原则;
- 智能体安全的流程机制。
听众收益
- 可以参考落地的智能体安全风险建模方法论;
- 可以直接服用的智能体安全保障流程。
by Sunny Duan
京东集团
信息安全部 AI 安全实验室负责人智能体正在成为AI应用的核心形态,但其自主性、工具调用和多步推理能力也带来了独特安全挑战。相比传统应用安全,智能体面临Prompt注入、工具滥用、目标劫持、记忆投毒、执行失控等新型威胁。
本议题将从企业级Agent平台的安全实践出发,剖析智能体的五层攻击面模型,介绍京东安全基于JoySafety框架和JoySafeter平台构建的可控安全架构。重点分享:输入防火墙、Skills沙箱隔离、执行链管控、可观测性审计等核心能力的工程实现,以及如何实现安全左移和防御前置的智能体安全体系。
演讲提纲
- 智能体安全新挑战
- 从应用安全到Agent安全:核心差异分析
- 智能体安全三大特征:自主性风险、工具调用风险、多步推理风险
- OpenClaw真实安全事件剖析
- 五层攻击面模型
- L5 输入层:Prompt注入的100种变体与检测方法
- L4 记忆层:对话历史劫持与RAG知识库投毒
- L3 规划层:目标劫持
- L2 工具层:Skills参数注入与 MCP工具诱导
- L1 执行层:恶意操作识别与数据泄露防护
- 攻击链还原:端到端的攻击案例演示
- AI Native防御架构
- 防御理念:用AI防御AI,以智能对抗智能
- 五层防御体系:
- 输入层:Prompt Firewall + 对抗样本检测
- 记忆层:上下文完整性校验 + 知识库安全
- 规划层:目标一致性验证
- 工具层:Skills沙箱 + MCP-Scan
- 执行层:输出过滤 + 敏感数据脱敏
- OpenClaw 安全基因植入+安全能力构建新范式
- JoySafeter平台:安全Agent编排与自动化响应
- JoySafeter项目介绍:定位、架构与核心能力
- 安全Agent详解:
- Guardian - 全链路7×24小时Agent实时监控与威胁拦截
- 落地案例:京东内部智能体平台的安全实践2-3
- 开源Roadmap:社区共建计划与未来演进
- 总结与展望
- 核心观点:以安全为底座,塑造可信AI;以AI为引擎,重塑新安全
- 开源发布:JoySafety & JoySafeter Roadmap
- 技术趋势:Agent安全的发展方向
这样的技术在实践过程中有哪些痛点?
因为Skills、MCP等调用成功率无法确保完全准确,所以基于AI Native构建的方案也许持续探索,并确保有相应的兜底方案。
演讲亮点
- 首次系统性提出智能体五层攻击面,从输入到执行完整揭示安全风险;
- 基于OpenClaw的安全事件复盘,不是纸上谈兵;
- JoySafety框架+JoySafeter平台,会后可立即使用。
听众收益
- 理解智能体安全与传统安全的本质区别,掌握Agent安全的完整知识体系;
- 掌握Skills沙箱、行为监控、异常检测等核心安全能力的代码实现方法。
关注主办方(InfoQ)
联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手