系统软件架构师,目前负责 AI 分布式系统软件方向技术研究工作。先后从事网络协议、Linux 内核、容器 & 微服务平台、Serverless 计算平台的技术研发工作,22 年开始聚焦 AI 分布式系统软件方向。擅长云原生、AI 系统软件、Linux 内核,负责过多项创新技术从研发到产品商业落地工作,并在国内外发表多篇专利。SIGCOMM 2024《YuanRong: A Production General-purpose Serverless System for Distributed Applications in the Cloud》联合作者。
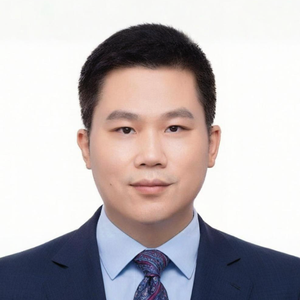
专题演讲嘉宾:吴杰
华为系统软件架构师
by 吴杰
华为
系统软件架构师大模型分离式推理、强化学习、AI Agent 等各类 AI 负载对分布式系统软件带来了各种诉求,例如大模型推理服务的快速伸缩/ EPD 分离/历史缓存加速,强化学习的多模型任务高效调度/训推参数异步更新/异步数据流,AI Agent 的快速弹性等。在企业落地实施时,通常一方面对现有的各种系统比如微服务系统进行扩展,另一方面针对具体场景构建各种新的分布式系统软件,最终平台需要构建和维护多个独立的软件,增加了整体方案的复杂度和维护工作量。
本次演讲我将分享 openYuanrong 解决思路,以分层架构构建 AI Infra 分布式基础设施,剖析各类 AI 负载对分布式系统软件的共性功能诉求,并在底层 openYuanrong 统一提供这些功能的高性能实现,上层面向各个场景适配扩展,从而简化了整体系统复杂度,也提升了资源的整体使用效率,在企业落地过程中取得良好的实践效果。
演讲提纲
1. 背景
- 微服务扩展与新系统并建成为常态
- 多软件并存,架构复杂度持续膨胀
2. openYuanrong 整体架构设计
3. 大模型推理实践
- 弹性伸缩
- 分布式 KV Cache
- 分离式推理
- 基于KV Cache 在线迁移的动态负载均衡
3. 强化学习实践
- 分离式异步训推
- 训推参数异步更新
- 样本数据系统
- 多 Agent 异构资源动态调度
- Agentic RL函数/容器统一编排
4. AI Agent 实践
- 快速启动
- 会话弹性
5. 分布式训练实践
- 分片 Checkpoint 的快速保存与恢复
6. 经验总结与 Q&A
您认为,这样的技术在实践过程中有哪些痛点?
- openYuanrong 采用了新的架构方法,需要迁移存量系统,有一定的迁移工作量
演讲亮点
- 业界现有方案是烟囱式架构,需要集成和维护多套中间件系统,openYuanrong 是分层的积木式架构,基础功能完全复用,减少了构建和维护成本,并提升了资源的整体使用效率
听众收益
- 可以深入了解 AI 场景各类负载对分布式系统软件的关键功能需求,以及可参考的解决方法
- 借鉴 openYuanrong 系统架构思路,有助于构建更简单高效的 AI Infra 分布式基础设施
关注主办方(InfoQ)


联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手