百度资深工程师,极客时间专栏作家,智能体框架 langgraphgo 负责人,智能体研究社主理人。
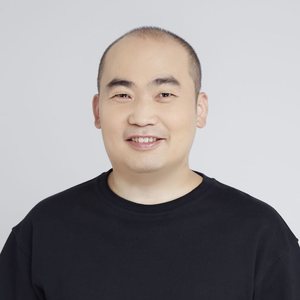
专题演讲嘉宾:晁岳攀 (鸟窝)
百度资深工程师
by 晁岳攀 (鸟窝)
百度
资深工程师随着智能体在舆情分析、深度研究、知识生产等场景中的广泛应用,越来越多团队发现:“架构图看起来很美,但一上线就开始幻觉、偏题、失控。”
本次分享我将从工程实践视角出发,系统梳理 18 种常见智能体架构模式,并重点讨论这些模式在真实业务场景中的失效方式与边界条件。最后,将结合微舆与 DeepResearch(DeerFlow/Insight 类似项目)的实践经验,深入分享:
1. 为什么某些看似合理的智能体架构,在信息不完整、目标不清晰的场景下会系统性失败;
2. 团队在实践中如何通过模式应用、信息补全、护栏机制,一步步修补这些设计缺陷;
3. 以及这些工程取舍,对未来智能体系统设计带来的关键启示。
这不是一场“架构大全”的介绍,而是一份智能体工程落地的踩坑与反思记录。
演讲提纲
1. 背景:从“降龙十八掌”说起:为什么有那么多智能体架构?
- 智能体常见架构模式速览:5种常见架构不就好了?
- 从工程视角拆解 3 类高频模式:
- 信息不全导致的推理漂移
- LLM不可避免的幻觉
- 永动机:跳不出去的怪圈
2. 案例一:微舆智能体——热点跟踪中的"以偏概全"是怎么产生的?
- AI 驱动的全域监控:MindSpider 爬虫集群 7x24 小时不间断作业,覆盖微博、小红书、抖音、快手、B 站、知乎、贴吧等 7 大关键社媒,下钻至海量用户评论,获取最新最全数据
- 强大的多模态能力:MediaEngine 深度解析抖音、快手等短视频内容,精准提取天气、日历、股票等结构化多模态信息卡片,确保信息的全面性
- Agent"论坛"协作机制:ForumEngine 实时监控其他 Agent 日志,利用主持人引导,通过"论坛"机制进行链式思维碰撞与辩论,避免单一模型思维局限
- 聚类采样防偏斜:InsightEngine 使用 KMeans(SentenceTransformer模型)对搜索结果聚类后采样代表性结果,避免高热度内容主导导致的观点偏斜
- 超越 LLM 的复合分析引擎:5 类专业 Agent(QueryEngine广度搜索 + MediaEngine多模态 + InsightEngine数据挖掘 + ForumEngine论坛协作 + ReportEngine报告生成),融合关键词优化中间件、情感分析模型、KMeans 聚类采样等统计模型
3. 案例二:DeepResearch(Insight)——深度研究型智能体如何对抗"信息不全 + 幻觉"
- 多 Agent 协作与有向图编排:9个智能体基于 langgraphgo 协同工作(query_agent→structure_planner→planner→researcher→content_writer→reflector→reviser→reporter→podcast),通过有向图状态传递确保流程可追踪、可恢复
- 意图澄清机制对抗模糊请求:QueryAgentNode 分析用户意图,提取实体信息(领域、时间范围、目标),将模糊的自然语言转换为结构化的研究请求,避免后续推理偏差
- 分类制定不同的报表内容通:分别为金融投资、技术开发、商业分析、政策解读、通用行业制定不同的报表内容,确保每篇报告精准且全面
- Human-in-the-loop 人机协同机制:当用户请求模糊或意图不明确时,系统暂停执行并请求用户澄清;结合用户反馈重构查询,人工干预确保研究方向的准确性,避免"无头苍蝇"式的错误推理
- 多源搜索对抗信息不全:集成微信、知乎、GitHub、Google Scholar、Tavily 等5种搜索源,针对不同领域使用最合适的搜索工具,避免单一信息源导致的盲区
- 反思-修订闭环机制对抗幻觉:每个章节完成内容撰写后,ReflectorNode 自动评估完整性,识别缺失信息;ReviserNode 最多执行5次补充搜索,修订直到"内容合格"或达到次数上限
- 报表内容增加索引资料链接:关键性的报表内容后面增加相关搜索链接,方便用户获取原始资料进行深度研究,避免『幻听』
演讲亮点
- 不止讲“有哪些架构”,而是讲哪些架构会在哪些真实场景下更适用
- 通过两个真实产品,系统拆解智能体落地中的工程设计
- 从幻觉与信息不全问题出发,总结可复用的架构设计原则
听众收益
- 理解主流智能体架构在真实业务中的适用边界
- 学会从工程视角,设计更可控、可演进的智能体系统
传统软件架构有几个默认前提:
-
行为是确定的
-
调用链是可控的
-
上下文是有限的
这些前提,让我们可以设计稳定、可预测的系统。但 Agent 出现之后,这三件事都开始失效:
-
行为变成概率性的
-
执行路径不再完全可控
-
上下文开始跨越请求持续存在
所以今天我们想讨论的不是“怎么做 Agent”,而是:为了让 Agent 能在生产环境运行,我们到底被迫重写了哪些“架构前提”?以及——这些重写背后的代价是什么?
关注主办方(InfoQ)


联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手