赵晗,现任地瓜机器人数据闭环平台和 Infra 基建负责人。资深 AI Infra 架构师,深耕具身智能与自动驾驶领域多年,主导构建了支撑 PB 级多模态数据管理的分布式存储架构。作为横跨业务与底层的复合型架构师,将百 PB 级自动驾驶基建经验迁移至具身智能领域,通过架构创新实现存储成本降低 30%。在算力层,基于 Kubernetes 与 Volcano 构建了数百张 GPU 规模的混合云调度系统,将资源利用率提升 20%。完整跑通了从数据采集、挖掘、标注到模型训练、推理、量化、板端部署及数据回灌的全生命周期机器人数据闭环,致力于通过软硬件重构驱动“智能涌现”。
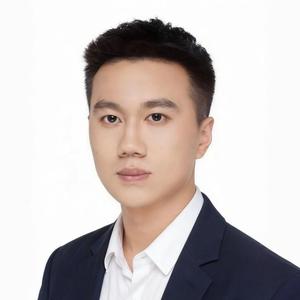
专题演讲嘉宾:赵晗
地瓜机器人数据闭环平台和 Infra 基建负责人
by 赵晗
地瓜机器人
数据闭环平台和 Infra 基建负责人具身智能与自动驾驶的智能涌现高度依赖高质量数据闭环的转动。本次演讲我将深度剖析一套复用自百 PB 级自动驾驶经验、现已主导落地于具身智能场景的 AI 原生基础设施架构。
问题背景
- 存储挑战:海量小文件对存储元数据的极限压力:自动驾驶和具身智能应用产生的海量数据中,大量为小文件,这对存储系统的元数据管理提出了极高的要求。传统的存储架构在处理海量小文件时容易遇到性能瓶颈,导致数据存取延迟和存储资源浪费。
- 真机数据采集难度:在具身智能应用中,数据的采集通常面临困难,特别是高质量、真实环境下的数据采集(即“真机数据”)。这使得模型训练无法依赖足够多的真实场景数据,进而影响了模型的泛化能力和准确性。
- 调度挑战:
- 算力资源碎片化:在分布式环境,尤其是多GPU和混合云环境中,算力资源常常出现碎片化,导致任务无法高效利用现有的计算资源。例如,GPU资源可能无法根据任务需求被充分调度,造成算力资源的浪费。
- 任务抢占与死锁问题:在高并发、复杂的任务调度场景中,任务之间由于资源竞争可能导致抢占死锁现象,影响整体系统的稳定性和计算效率。
- 混合云资源调度问题:在混合云环境中,不同云平台之间的资源调度和管理变得更加复杂,如何实现算力的高效调度、负载均衡和弹性扩展,成为确保高效计算和成本优化的难点。
- 闭环支柱挑战:
- 数据回灌中的版本一致性问题:在闭环系统中,数据回灌的过程中常常会面临版本不一致性的问题,尤其是涉及到多个数据源和多个模型版本时,这种不一致性会影响数据的质量和模型的准确性。
- 生成式仿真与数据补充挑战:在数据采集困难的情况下,**生成式仿真(World Models)**技术被用来弥补数据缺口,但这种仿真数据的质量、有效性和与真实数据的一致性问题仍然是一个亟待解决的挑战。
- 模型量化与精度损失问题:在具身智能系统中,模型量化用于提升计算效率,但这种技术可能带来精度损失。如何平衡模型的计算效率与精度,以及如何保证模型的稳定性,是在量化部署过程中必须解决的问题。
演讲提纲
1. 背景:AI 原生基座的“第一性原理”
- 自动驾驶与具身智能的数据悖论:Corner Case 挖掘 vs. 真机数采瓶颈
- 基础设施如何驱动模型 Scaling Law 的跃迁
2. 存储支柱——PB 级多模态数据的存储演进
- JuiceFS 生产级实践
- 降本增效: 多级缓存策略与内核优化,突破海量小文件管理的性能瓶颈
3. 调度支柱——数百张 GPU 卡的混合云精细治理
- Volcano 调度增强:解决分布式训练中的资源碎片与任务抢占死锁
- 基于 KServe 的推理服务优化:实现板端部署与云端服务的弹性扩缩容
4. 闭环支柱——差异化路径下的全链路数据治理
- 业务赋能:利用生成式仿真(World Models)补齐具身智能的真机数据缺口
- 避坑指南: 模型量化部署的精度损失与数据回灌中的版本一致性挑战
5. 小结:反思——如何做一个“懂业务”的 Infra 架构师?
- 从“管理算力”到“驱动闭环”:以产品思维对齐模型交付周期
您认为,这样的技术在实践过程中有哪些痛点?
- 技术迁移有适配壁垒:JuiceFS 引擎迁移、Volcano 调度定制化等核心组件升级,面临数据兼容、系统对接冲突、业务无感知割接等落地风险,且需大量定制化调试,试错成本高。
- 跨模块 / 团队协同:存储、调度、训推等模块技术标准不统一、接口不兼容,且基建与业务团队认知偏差大(基建重技术稳定性,业务重实际指标提升),跨领域沟通与适配成本高。
- 资源成本短期矛盾:方案虽以降本提效为目标,但落地初期需投入大量采购、开发、重构成本,且算力精细化管控、在离线混部的实际效果难达设计预期,短期投入与长期价值实现存在矛盾。
- 场景化落地难度:生成式仿真与真机数据融合无通用模板、模型量化需适配不同端侧硬件与业务精度要求、数据回灌版本管控需对接多套系统,均需结合业务做定制化开发,无成熟方法论可复用。
演讲亮点
- 跨领域基建迁移实战: 展示如何将 100PB 级的自动驾驶成熟架构降维打击应用到具身智能领域,论证了标准化基建的长期价值
- 硬核存储演进历程: 详细拆解 JuiceFS 在真实生产环境下实践和挑战,以及 30% 成本削减的底层逻辑
- 全链路自动化闭环: 不仅限于存和调,更涵盖了针对“真机数据难采”所构建的生成式仿真与自动化回灌体系,具有极强的行业参考性
听众收益
- 实战模版: 获得一套支撑百卡规模、PB 级数据的具身智能标准 AI 基建参考架构
- 避坑经验: 掌握在混合云环境下处理多模态 AI 任务时,关于存储引擎迁移、Volcano 任务编排及推理扩缩容的真实失败案例
- 思维升维: 学习 Infra 架构师如何主动介入数据挖掘与仿真生成等业务层,从底层直接驱动业务迭代
关注主办方(InfoQ)


联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手