谈鉴锋,蚂蚁集团操作系统研发经理,清华大学计算机硕士,前 DPDK Maintainer,长期从事操作系统与系统基础设施研发。在蚂蚁主导打造 DeepSYS和 DeepXPU技术体系,特别基于 gVisor 演进实现NanoVisor。加入蚂蚁前曾就职于 VMware 与 Intel,在 DPDK 高性能网络领域推动容器化、virtio-user、加速虚拟交换与热迁移等。曾在 OSDI、SIGCOMM、EuroSys、USENIX ATC 等会议发表论文,并在 LinuxCon、DPDK Summit 等大会分享。
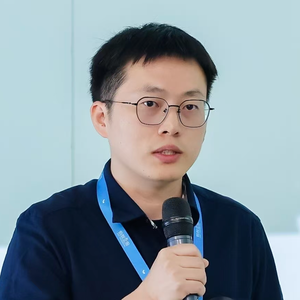
专题演讲嘉宾:谈鉴锋
蚂蚁集团操作系统研发经理
AI 时代,开发者面临一个悖论:模型能力日趋强大,但基础设施的使用门槛却居高不下。无论是个人开发者想在单机上快速验证 Agent 应用,还是企业团队需要在私有 K8s 集群或公有云上部署生产环境,都不可避免陷入"Build Your Own Cluster"的泥潭——依赖冲突、部署复杂、运维繁重。
AKernel 是一个面向 AI 原生开发者的 Datacenter-Use 框架,核心理念是"像调用本地函数一样使用整个数据中心"。我们采用大库(monorepo)架构,300 万行代码统一维护,通过 AI 辅助开发实现 <=3 人全栈团队的高效协作。AKernel 提供一站式部署方案:无论面对单机、私有 K8s 集群,还是多云环境,均可在 10 分钟内完成部署。
技术层面,AKernel 融合了三大核心能力:基于 openYuanrong 的分布式数据系统,实现跨实例、跨节点的高性能数据共享;AFaaS fork 技术,实现 10ms 级节点侧启动、40ms 端到端延迟的极致弹性;基于 gVisor/Firecracker 的 Checkpoint/Restore 机制,赋能 Agent 的暂停恢复与克隆。在 Agent 长会话、RL 训练任务、Spark 数据处理等场景中,AKernel 显著降低了资源碎片率,提升了任务响应速度与资源利用效率。
本演讲将我将围绕 AKernel 的架构设计、关键技术决策与踩坑经验展开,分享如何在有限人力下构建可扩展、易维护的 AI 原生基础设施。
演讲提纲
1. 引言:AI 开发者正在被基础设施"劝退"
- 现状剖析:个人开发者配置环境耗时数天,小团队陷入重复建设,大企业维护成本高昂
- 核心矛盾:模型能力快速演进 vs 基础设施使用体验停滞不前
- 提出观点:AI 原生基础设施必须回归"开发者友好"本质,实现一键部署、随处运行
2. AKernel 架构:大库治理与 AI 辅助的工程实践
- 统一代码库架构与依赖治理
- 采用大库(Monorepo)模式,300 万行代码集中管理,通过 submodule 机制实现外部依赖的版本锁定与按需集成
- 端到端组件自主可控:从 SDK/API 层、控制面到运行时,完整掌控技术栈演进节奏
- 消除分布式版本管理的依赖冲突问题,实现跨模块原子化变更与一致性构建
- AI 辅助开发模式
- 5-10 人全栈团队,无需求/研发/测试/运维分工,80% 代码工作由 AI 辅助完成
- 从代码生成、测试用例生成到运维决策的全链路 AI 赋能
- 工程效率提升背后的组织变革与技术债管理
- 开发者 API 与 CLI 设计
- Remote Function 调用接口:采用 Ray-like 的 Python 装饰器设计,开发者通过简单注解即可将本地函数转换为可跨节点调用的远程函数,屏蔽底层资源类型与位置
- CLI 工具链:支持集群和实例管理,包含一键部署、实例查询、任务提交、日志追踪的完整运维闭环
- 监控与日志自助化:无需手动配置,自动生成监控仪表盘和日志网站,用户可直接访问网址查看任务状态、资源使用与日志输出
3. 一站式部署:从单机到多云
- 部署场景全覆盖
- 单机模式:个人开发者在 server 上一键启动完整环境
- 私有集群:对接现有 K8s,10 分钟完成资源接入与组件部署
- 公有云:支持阿里云、AWS、Google Cloud 的标准化部署
- 极简部署机制
- 单命令启动:自动探测环境、完成组件初始化、建立控制面
- 从资源就绪到集群可用:10 分钟内完成,无需手动配置依赖
- 统一认证、监控、日志服务开箱即用
4. Agent 时代的三大技术支柱
- 高性能数据共享:openYuanrong 分布式数据系统
- 痛点:传统方案跨节点数据拷贝延迟高、带宽利用率低
- 方案:参数传输面优化,支持跨节点、跨资源类型的零拷贝数据流动
- 踩坑经验:早期过度依赖 BaaS 导致接入成本高,后统一为 openYuanrong 数据系统
- 极致冷启动:AFaaS 安全沙箱
- 性能指标:10ms 节点侧启动(AFaaS 纯节点方案),40ms 端到端延迟
- 技术实现:基于 gVisor/Firecracker 的轻量虚拟化,细粒度网络控制
- 应用场景:Agent Sandbox 快速创建、RL Reward 任务高并发执行、自定义镜像 Lazy Load
- 状态持久化:Checkpoint/Restore 全链路支持
- 架构设计:从 SDK、调度器到节点端的全栈实现
- 核心价值:Agent 长期待机资源释放、特定节点状态恢复执行、任务故障自愈
- 踩坑经验:固定资源规格阻碍空闲资源利用,通过 DaemonSet 动态上报解决
5. 实践验证与典型场景
- Agent 多智能体协作
- 每个 Agent 运行在独立沙箱,秒级启动与销毁
- Checkpoint/Restore 支持长会话状态迁移与资源弹性
- RL 训练与 SWE 任务
- 高并发实例快速创建,数据在 openYuanrong 系统内高效流通
- 避免中间落盘,端到端延迟降低 60%+
- Spark/Flink 大数据处理
- 精准识别空闲资源,避免离线任务与在线任务互相压制
- 资源利用率显著提升
6. 总结与展望
- 核心价值:让 AI 开发者专注于模型与应用,而非基础设施搭建
- 未来演进:更细粒度 XPU 支持(NPU/TPU)、强化学习驱动的自主调度
您认为,这样的技术在实践过程中有哪些痛点?
- "Build Your Own Cluster" 门槛过高
- 从资源接入、调度器构建到监控体系,需要大量工程投入
- 小团队难以独立完成,大团队易陷入重复建设陷阱
- 跨团队依赖管理灾难
- 多仓库架构下版本冲突、接口不兼容频发
- 开发者 30%+ 时间消耗在环境配置与依赖解决
- 数据与计算的绑定难以优化
- 缺乏跨任务类型的数据共享机制
- Agent 会话间重复加载相同数据,造成算力浪费
- Agent 状态管理缺失
- 长生命周期 Agent 长期占用资源但大部分时间空闲
- 任务中断后无法从特定节点恢复执行,只能重启
- 多环境部署碎片化
- 单机、私有云、公有云需要维护多套部署脚本
- 配置漂移导致"在我机器上能跑"问题频发
演讲亮点
- 大库治理 + AI 辅助的工程模式创新
- 300 万行代码、<=3 人全栈团队、80% AI 辅助开发,展示了一种可持续的基础设施维护范式
- 打破"基础设施必须大团队维护"的固有认知,为中小团队提供可借鉴路径
- 从 10ms 启动到 Checkpoint/Restore 的全链路 Serverless 能力
- AFaaS 实现 10ms 节点侧启动、40ms 端到端延迟,相较传统容器方案(秒级启动)提升 2 个数量级
- Checkpoint/Restore 与调度系统深度集成,实现 Agent 状态的真正可迁移、可恢复
听众收益
- 掌握 AI 原生基础设施的轻量化构建方法
- 学习如何通过大库架构与 AI 辅助开发,以有限人力维护大规模代码库
- 获得从单机到十万节点集群的统一部署实践经验,可直接应用于团队基础设施建设
- 理解 Serverless AI 运行的关键技术决策
- 深入理解极速冷启动(10ms 级)、Checkpoint/Restore、高性能数据共享的设计取舍
- 避免在自建 Agent 运行环境时重复踩坑
- 获取可复用的开发者体验优化策略
- 了解如何通过"一键部署"理念降低 AI 应用开发门槛
- 学习在组织内推动 AI 辅助开发落地的方法与组织模式
关注主办方(InfoQ)


联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手