深耕机器学习与分布式计算,致力于构建高效可扩展的大规模 AI 与数据基础设施,擅长攻克高并发资源调度难题,主导过千卡集群的性能调优与稳定性保障。持续推动 AI 与大数据生态融合,助力企业实现算力最大化。作为 Ray、Kueue、K8s、Spark 及 Hadoop 等开源项目的维护者/贡献者,长期主导社区治理与代码演进,推动关键调度特性落地工业界。
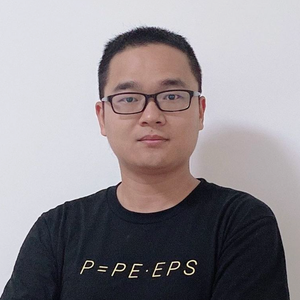
专题演讲嘉宾:季万强
京东零售高级技术专家
by 季万强
京东零售
高级技术专家AI 领域的三大核心负载——模型训练、批量推理与模型服务,均面临相似的弹性调度挑战。尽管业界已针对在线和离线场景分别推出了开源解决方案,但这些方案往往各自为战,仅能覆盖单一负载类型。为此,我们联合 openFuyao 社区共同设计并研发了面向 AI 原生工作负载的弹性调度框架 Aether。从业务落地效果来看,训练的 ETTR 达到 97%,千卡级离线推理任务端到端任务处理时间缩短 10%,部署 PD 分离模型服务的端到端效率提升 5%。
本次演讲我将围绕 Aether 的架构设计、关键技术决策与踩坑经验进行展开,分享如何构建一个高性能、高弹性的基础设施用于支撑 AI 原生工作负载。
演讲提纲
1. 背景与挑战生态趋势
- 算力规模指数级增长,但系统稳定性未能同步跟进
- 为了解决“资源永远不够用”与“资源利用率低”并存的矛盾,传统调度缺乏弹性,硬件故障频发导致训练中断、成果归零( ETTR 低下)的问题,我们构建了一套统一、高效、可靠的弹性调度框架
2. 整体架构设计
3. 关键技术实践
- 动态资源优化与调度
- 动态组网与拓扑自愈
- 自动故障检测与隔离
4. 落地实践
- 模型训练:有效训练时间占比(ETTR)提升至 97%
- 批量推理:端到端任务处理时间缩短 10%,资源成本降低 30%
- 模型服务:部署 PD 分离服务的端到端效率提升 5%
5. 总结与展望
- Aether 将 AI 资源的“不可用”、“不可靠”转变为高效、弹性、可保障的生产力。未来,我们将会持续探索更智能的资源调度策略,并拓展至更广泛的 AI 工程化场景
您认为,这样的技术在实践过程中有哪些痛点?
- “动态组网”与“状态重建”的时间窗口矛盾:当某个节点故障被剔除,新节点加入时,整个通信域必须完全重建。这个过程中,所有其他正常节点必须暂停计算等待重连,如果重建时间过长(分钟级),频繁的微故障会导致系统大部分时间在“重建”而非“训练”
- 故障判定的“误报”与“震荡”:在大规模集群中,偶尔的网络抖动或 GC 停顿是正常的。如果健康探针过于敏感,会将这些“慢节点”误判为“死节点”并强制重启。这不仅浪费了已完成的计算,还可能因为频繁重启导致任务永远无法完成(Live Lock)
演讲亮点
- 分享如何构建一个真正适应AI原生负载的弹性调度系统
- 深入剖析 Aether 框架的核心设计理念与技术实现细节
- 分享在京东零售大规模生产环境中的落地实践
听众收益
- 了解如何设计一个高效、可靠的弹性调度框架来支撑大规模 AI 原生工作负载
- 学习如何设计自适应故障探针、细粒度隔离机制,将运维工作从“ 7x24 小时救火”转变为“自动化防御”
- 获取在大规模生产环境中构建弹性调度系统的实战经验与教训,避免常见的设计陷阱和误区
关注主办方(InfoQ)


联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手