王新波,Shopee 技术专家,深耕大数据引擎及平台领域多年。曾先后就职于阿里巴巴、快手、滴滴等公司,在 SQL 引擎开发、数据中台建设、数据治理等方向积累了丰富的技术经验与业务洞察。现专注于 Shopee 数据 Agent 的研发与探索,主导了智能取数、智能洞察、业务场景化分析等多个 AI 应用的设计与落地,致力于借助 Agent 技术重塑数据交互方式,让业务人员能够通过自然语言便捷地获取和理解数据,降低数据使用门槛,释放数据驱动决策的价值。
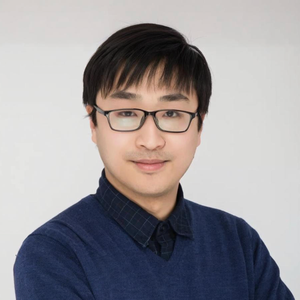
专题演讲嘉宾:王新波
Shopee技术专家
by 王新波
Shopee
技术专家本次演讲以 Shopee Data Agent的实战演进为主线,完整呈现企业级数据 Agent 从取数到智能分析的技术路径。内容涵盖五次关键跃迁:从单链路 RAG 到基于渐进式披露的 Multi-Agent 架构,引入用户画像与记忆体系实现个性化交互,通过语义模型突破 Text2SQL 准确性天花板,构建 File-as-Context 与 Sandbox 基础设施支撑复杂分析场景,以及基于 Skill 机制将专家分析经验沉淀为标准化流程。演讲还将分享元数据治理、全自动化评测 Pipeline 和运营闭环的工程实践,为听众提供一套覆盖数据 Agent 全链路的可落地方法论。
演讲提纲
1. 为什么数据消费需要 AI 重塑
- BI 演进的三个阶段:Excel 时代 → 自助式 BI → AI 驱动的增强分析
- 企业数据消费的核心痛点:高门槛、响应慢、数据资产利用率低、认知断层
- 我们的判断:仅降低取数门槛不够,还要让 AI 具备分析能力
2. 从 RAG + LLM 到 Multi-Agent 架构演进
第一版基于 LLM 的 RAG 架构上线后,真实用户反馈暴露了找表不准、业务知识缺失、SQL 准确率低等核心问题。为此架构从单链路 RAG 升级为 ReAct Multi-Agent,核心思路是分层检索、任务拆解与 Human-in-the-Loop,由 Supervisor Agent 统一编排意图识别、数据域定位、表发现、SQL 生成到可视化洞察的完整链路
关键技术决策:
- 找数与知识召回:渐进式披露(Progressive Disclosure)
- SQL 生成:多路生成选优 + Generate-Reflection + 方言适配与自动修复
- 知识体系:从 Hive 元数据到 Topic 运营知识的完整知识工程
3. 用户画像与记忆
- 画像 + 记忆与 Agent 架构的协同
- 用户画像作为 Supervisor Agent 的"预加载上下文",每次会话自动挂载
- 用户记忆纳入 File-as-Context 体系,作为可按需检索的个性化知识库
- 与运营闭环的打通:记忆数据经脱敏后回流,辅助发现共性问题和优化方向
4. 语义模型
纯 Text2SQL 让 LLM 直接面对物理表,复杂度高且业务语义丢失,存在准确性天花板。为此引入语义模型作为数据抽象层,采用 Text-to-DSL 与 Text-to-SQL 的混合路径来突破这一瓶颈。同时通过辅助语义建模 Agent,基于元数据和 SQL 日志自动推荐指标与维度定义,形成 AI 建模、语义查询、反馈优化的正向循环
5. 基础设施:File-as-Context + Sandbox
数据 Agent 涉及的上下文种类繁多,远超 LLM 上下文窗口。解决思路是将所有上下文组织为虚拟文件系统(File-as-Context),以渐进式披露为核心调度原则进行按需加载与卸载,大幅降低 Token 消耗。同时提供 Sandbox 沙箱作为安全隔离的代码执行环境,支持中间状态持久化,为多步分析流程提供工程底座
6. Skill 场景化分析
取数不是终点,用户真正需要的是理解数据背后的原因和趋势。通过 Skill 机制,将专家分析经验(如归因分析、KPI 解读)沉淀为标准化流程模板,由 Agent 在 Sandbox 中逐步执行。Skill 具备可复用、可信赖、可扩展的特点,在流程刚性与分析灵活性之间取得平衡
7. 元数据治理、评测与运营
- 元数据质量是 Agent 效果的隐形天花板,通过 AI 辅助生成表描述配合业务方 Review,大幅提升治理效率与找表准确率
- 全自动评测 Pipeline构建
- 运营侧搭建了效果 Review、知识补充与用户行为反馈挖掘的闭环后台,标注数据回流辅助自研模型持续优化
8. 效果总结与展望
- 打造 Agent-first 的数据基础设施,推动数据 Agent 从"AI 工具"走向"AI 员工"
您认为,这样的技术在实践过程中有哪些痛点?
1. 学术 benchmark 与企业实际场景的巨大鸿沟
- 开源数据集(Spider / WikiSQL)上的高分在真实企业环境中几乎不可复用——百万级 Hive 表、元数据质量参差不齐、业务术语高度私域化,传统 RAG + LLM 一步到位的方案在生产环境中准确率极低
2. 纯 Text2SQL 路线的准确性天花板
- LLM 直接面对物理表生成 SQL,需要同时理解业务语义、表关联关系和 SQL 方言差异,复杂度过高。引入语义模型作为抽象层是突破天花板的关键,但语义模型本身的构建成本又成为新的瓶颈——需要用 AI Agent 来加速建模过程
3. Agent 上下文管理的工程复杂度
- 数据 Agent 涉及的上下文种类繁多(元数据、业务规则、样例 SQL、查询结果、用户画像、用户记忆、分析中间产物),远超一般对话 Agent。渐进式披露的"层级划分"需反复调优——每层暴露多少信息,不同 Mart/Topic 的最优披露粒度也不尽相同,需要结合评测数据持续调整
4. 代码执行的安全性与隔离性
- 数据 Agent 需要动态执行 SQL 和 Python 分析脚本,生产环境中的安全隔离、资源限制、权限管控是必须解决的工程问题。Sandbox 机制在保障安全的同时,还需要支持中间状态持久化以服务于多步分析流程
演讲亮点
- 覆盖数据 Agent 完整技术栈的演进实录
- 渐进式披露在数据 Agent 中的系统性应用
- 语义模型 + Agent 的双向驱动
- 文件系统即上下文 + Sandbox 的基础设施设计
- Skill 机制:让 AI 分析"有章可循"
听众收益
- 了解企业级数据 Agent 从取数到分析的完整技术路径和每个阶段的关键架构决策
- 获得渐进式披露、File-as-Context、Skill 机制等可迁移的 Agent 设计原则
- 理解如何通过用户画像和记忆体系构建个性化数据 Agent
- 掌握语义模型 + Agent 协同提升 ChatBI 准确性的实践方法
- 借鉴 Agent 效果评测体系和自动化评测 Pipeline 的建设方案
- 了解元数据治理、运营闭环对 Agent 效果的关键影响及量化方法论
关注主办方(InfoQ)


联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手