陈自欣,腾讯 IEG SRE 资深工程师 ,前可观测平台创业者, 多年运维平台产品及运营经验, 专注企业级可观测平台与监控体系建设和运营, 目前兼任 SRE 精英联盟秘书, 负责 SRE 经营联盟的日常事宜。
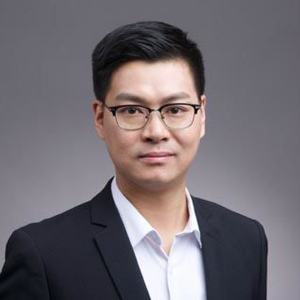
专题演讲嘉宾:陈自欣
腾讯SRE 资深工程师
by 陈自欣
腾讯
SRE 资深工程师目前可观测实践多停留在运行态(指标/日志/链路)层面,能发现异常,却难以快速回答“为什么发生、回滚哪个变更、改哪段代码”。本演讲以腾讯 IEG 的蓝鲸可观测平台实践为背景,提出并落地“Code + Change + Runtime”的全链路可观测实践:打通 CI/CD、PR/Commit 与运行态信号;在同一份数据流之上,分别为运维、运营、管理者构建差异化SaaS 应用;并引入 AI 的代码理解能力,将定位与代码及变更进行关联,实现真正的根因定位,并利用平台实现更多的 AI 提效场景。
演讲提纲
1. 为什么观测平台要做 PaaS 化, 如何打通从研发过程到代码,再到最后的生产环境
- 公司里面不同的角色,对观测数据和企业微信的消费需求是不一样的
- 传统“只做运行态”可观测的天花板:只能更快发现异常,难以定位到变更与代码
- 要进行 PaaS 化 打通从研发过程到代码,才能获得线上环境到 Commet id 的逻辑映射关系
2. 如何在 PaaS 化平台上构建面向 SRE、运营与管理者三大场景
- 运维视角(SRE):告警降噪、定位提速、止血与回滚决策、复盘沉淀
- 运营视角:影响面量化(用户/订单/转化/核心旅程)、对外口径与运营策略
- 管理者视角:SLO/错误预算、发布风险、稳定性与效率驾驶舱、治理成效
3. 从日志告警到代码级根因分析的解决方案
- 实践方案
- 蓝鲸监控告警:检测日志异常并触发告警
- 蓝盾流水线:作为编排引擎联动告警处理,打通线上日志与线下代码仓库
- Agent(Gemini CLI internal / CodeBuddy):结合错误日志做代码理解与根因分析,并将结果推送到企业微信
- 核心难点:线上日志如何关联到正确的代码版本?
- 容器场景的多层关联链:线上日志(Pod/时间)→ Pod 信息 → 镜像版本(app_version)→ Git Commit(commit_id)→ 代码仓库(git_repo)
- 通过观测平台元数据管理与 CI/CD 构建上报实现自动化版本定位,避免人工维护版本映射
- AI 如何落到流水线里(非交互式、可规模化)
- 在流水线构建机中使用 Gemini-cli-internal 非交互模式,通过注入 prompt 生成 Markdown 分析报告
- 输出结构:原始错误日志、可能原因(Top3,带源码片段说明)、总结;并将报告落地为构建产物供推送/留存
- 效果对比(从“10+ 步人工”到“4 步自动化”)
- 处理步骤:10+ 步 → 4 步(减少 60%+)
- 人工介入:全程参与 → 仅查看结果
- 版本切换与代码定位:手动 → 自动关联 + 智能分析
- 平均耗时:30 分钟~数小时 → 分钟级(提升 10x+)
4. 其他 AI + 观测提效场景
- Coredump 解析与关联代码
- OpneClaw 在 SRE 场景的应用落地
您认为,这样的技术在实践过程中有哪些痛点?
- 目前主要的卡点是在信息安全部分,优秀模型均为公网海外的模型,效果的上限取决于模型的上限
演讲亮点
- 大部分的可观测平台不能够实现全链路的打通(这里的全链路不是指从后端到前端,而是指从代码的提交到代码的发布,再到代码运行的全链路。而 AI 最擅长处理的是代码,如果不进行这样打通,AI 的威力其实没有办法很好地发挥。)
- 一条观测数据流统一运维/运营/管理者三大场景(视图不同,底座一致)
- Openclaw 的实践案例, 能帮助到用户实现数字员工的自动化执行
听众收益
- 可复用的全链路方法:Code × Change × Runtime
- 三类角色的落地路径与衡量指标:MTTR、影响面、错误预算/发布风险
- 可以看到大厂在数字员工 OpenClaw 上面的最新实践
关注主办方(InfoQ)


联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手