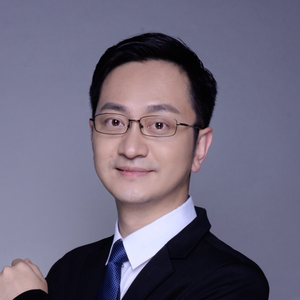
专题演讲嘉宾:熊飞宇 博士

记忆张量MemTensor创始人& CEO

熊飞宇,华中科技大学学士、美国 Drexel University 博士,现任记忆张量(上海)科技有限公司创始人兼CEO、上海算法创新研究院大模型中心负责人。曾任阿里巴巴集团业务中台数据智能负责人及淘宝天猫数据平台负责人,主导构建了国内首个千亿级数字商业知识图谱和零售行业知识交互大模型,相关成果荣获浙江省科技进步奖等多项荣誉,并在多个顶级AI会议与期刊发表多篇论文。

2024年11月,创立记忆张量(上海)科技有限公司,长期致力于人工智能基础理论与系统性创新。带领公司率先提出并落地具有中国特色的大模型发展路径(PlanB),成功构建“低成本、低幻觉、高性能”的大模型核心技术体系。


by 熊飞宇 博士

记忆张量MemTensor
创始人& CEO

OpenClaw 的爆发把一个被长期低估的工程问题推到了前台:Agent 的瓶颈不只是模型能力,更是长期状态如何被写入、组织、检索、更新和共享。
在真实生产环境中,拉长 context window 或者接一个向量库,并不能解决长任务中的连续性和稳定性问题。相反,它们往往引入新的工程债:token 消耗随会话轮次线性膨胀、历史信息与当前任务上下文互相污染、跨 Session 状态丢失、多 Agent 之间无法复用经验、用户记忆缺乏版本控制和权限治理。这些问题在单轮对话中不显眼,但在多 Session、多 Agent、长周期任务场景下会急剧放大。
本次分享从 OpenClaw 这一轮 memory 需求切入,系统讨论 Agent 为什么需要一层独立于模型的记忆系统,以及这层系统如何从"存对话日志"进化为"沉淀可复用的经验资产"。内容覆盖 Memory as File System 的抽象模型、三类记忆(参数记忆 / 激活记忆 / 明文记忆)的工程定位、写入-组织-检索-更新的全链路设计、任务经验到 Skill 的闭环沉淀机制,以及单 Agent 到多 Agent 团队知识中枢的差异化架构。

演讲提纲

  1. 为什么 Agent 时代,记忆从加分项变成基础设施
    • OpenClaw 热潮背后被真正验证的需求:不是"记得更多",而是"在正确的时机召回正确的经验"
    • Context window ≠ 长期记忆:上下文拉长带来的 token 膨胀、时序错配和召回噪声
    • 从单轮对话到多 Session / 多 Agent / 长周期任务,状态管理的复杂度为什么呈非线性增长
  2. Memory 到底是什么:内存、记忆,还是一层独立的系统能力
    • “把内容塞进上下文”与“把经验抽取为结构化记忆”的工程差异
    • Memory as File System:以文件系统为抽象,实现记忆的可见、可控、可组织——目录结构对应任务层级,文件对应记忆单元,元数据对应版本、权限与生命周期
    • 三类记忆的工程定位:明文记忆(Explicit)处理事实与偏好的文本存储;激活记忆(Activation)处理推理过程中的 KV Cache 等中间状态;参数记忆(Parametric)处理沉淀在模型权重或 LoRA 适配器中的深层知识
  3. 一套可落地的记忆系统全链路设计
    • 写入层:语义分块、去重、摘要生成、任务边界识别——解决“什么值得记”
    • 组织层:结构化目录、用户画像、事件时间线、任务-子任务层级映射——解决“怎么存才能找到”
    • 检索层:关键词匹配、语义检索、文件导航、重排策略与 token 预算控制——解决“召回准且省”
    • 更新层:版本链(V1 → V2 → V3)、冲突消解、过期归档而非删除、权限管控与审计——解决“记忆如何跟着用户演化”
  4. 从“记住对话”到“积累经验资产”
    • 完整闭环:对话 → 记忆抽取 → 任务总结 → Skill 沉淀 → 反哺后续对话
    • Skill Memory 与历史检索的本质差异:前者是经过验证的可复用方法,后者只是原始记录的相似度匹配
    • 记忆如何让 Agent 具备"越用越强"的工程基础:团队记忆池自动识别可共享经验,新 Agent 加入即继承已有 Skill
  5. 真实落地案例与工程取舍
    • OpenClaw 场景实测:从"全量灌上下文"改造为"按任务精确召回"后,模型调用次数降低 59.5%,token 消耗降低 72%+
    • 四种部署形态的架构差异:单 Agent 本地、Cloud 插件、团队知识中枢(Team Hub)、多 Agent 协作——隔离粒度、共享边界、一致性保证各不相同
    • 工程取舍的真实权衡:token 预算 vs 召回覆盖率、版本保留深度 vs 存储成本、记忆共享范围 vs 权限隔离强度
  6. 总结
    • 记忆不是外挂组件,而是 Agent 的长期工作状态层
    • 未来的竞争维度不只是模型强弱,更是谁能系统化地沉淀和复用经验

这样的技术在实践过程中有哪些痛点?

  • 写入层的信噪比问题。 对话日志、工具调用输出、中间推理链、错误结论、用户闲聊混在同一个流里。没有语义分块、去重和任务边界识别,记忆库会持续膨胀但信息密度持续下降——存得越多,检索越不准。
  • 检索层的效率-精度权衡。 全量灌上下文在工程上最简单,但 token 成本线性增长、时序信息错配、无关记忆污染当前任务上下文。而一旦引入检索、重排、过滤管线,延迟和系统复杂度会迅速上升,检索预算(每次召回允许消耗多少 token)成为必须显式管理的工程参数。
  • 多 Agent 共享的治理难题。 协作场景下,记忆共享太少则 Agent 之间无法形成协同(同一个团队的 Agent A 和 Agent B 对用户偏好的认知不一致);共享太多则导致角色串扰、上下文污染、权限泄露。更棘手的是,共享出去的记忆如何做到可撤回、可审计、可按角色裁剪——这不是一个算法问题,而是一个系统治理问题。

演讲亮点

  • 不把 memory 讲成"向量库 + RAG"的变体。 从 OpenClaw 的真实工程问题出发,解释为什么 Agent 时代需要一层独立的、有完整生命周期管理的记忆系统,而不是在 prompt 里多塞几段历史。
  • 把两条技术路线放到同一个架构图里。 Memory as File System 解决可见性、可控性和组织性;记忆操作系统解决调度、版本演化、协同共享和规模化治理。两者不是替代关系,而是不同层次的工程抽象。
  • 重点展示"经验资产化"的完整工程链路。 从对话记录到结构化记忆,从任务总结到 Skill 沉淀,从单个 Agent 私有到团队级记忆池共享——每一步的输入输出、触发条件和工程实现都会具体展开。
  • 用真实数据和取舍决策替代概念宣讲。 包括 token 消耗对比、检索预算设计、版本冲突消解策略、多 Agent 记忆隔离与共享的边界划分等工程细节。

听众收益

  • 建立一套完整的 Agent Memory 工程心智模型:明确哪些问题靠扩大 context window 可以缓解,哪些问题必须交给独立的 memory layer,避免在错误的层次上投入工程资源。
  • 带走一条可按模块拆解的落地路径:写入、组织、检索、更新、共享、治理——每个环节的核心设计决策和常见踩坑点。
  • 理解从单机本地 Agent 到 Cloud 插件、团队知识中枢、多 Agent 协作四种部署形态的架构差异,能够根据自身场景选择合适的起步点。
  • 掌握将"用户对话记忆"升级为"任务经验"和"可复用 Skill"的工程方法,让 Agent 在持续使用中积累真正的组织级知识资产。

交通指南

北京富力万丽酒店

Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号
  • 微信咨询

  • 电话咨询

    联系电话:+86 18514549229

微信联系我们

如您在购票过程中遇到问题,请扫码咨询票务小助手

