数据仓库(Data WareHouse)和数据湖(Data Lake)存在已有一... 展开 >
现代数据架构选型
会议室:白云宴会厅2出品人:李潇
- Topic 1
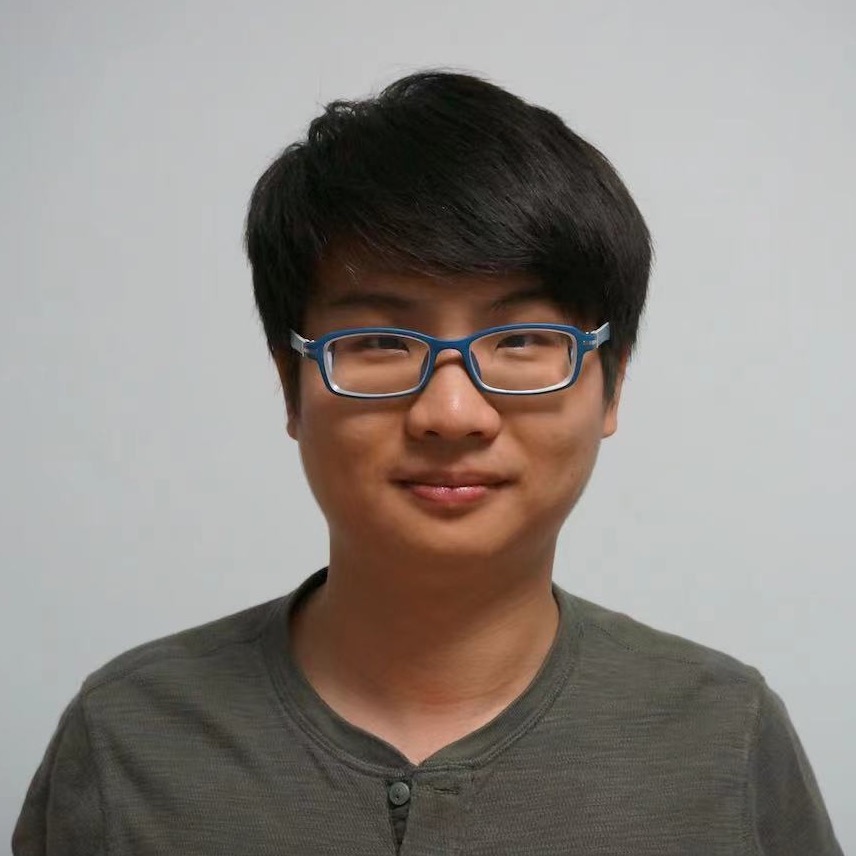
朱诗雄
Databricks 资深软件工程师 - Topic 2
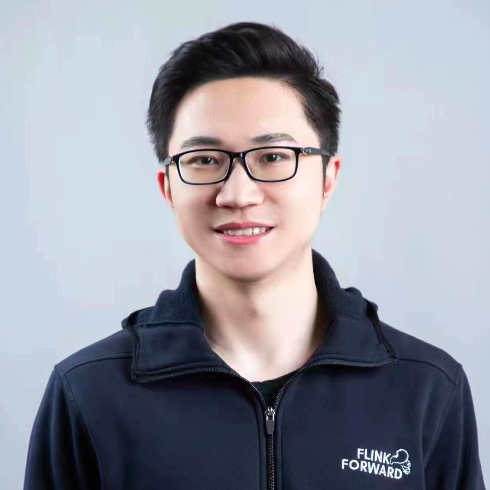
李劲松
阿里云 技术专家 & Flink PMC - Topic 3
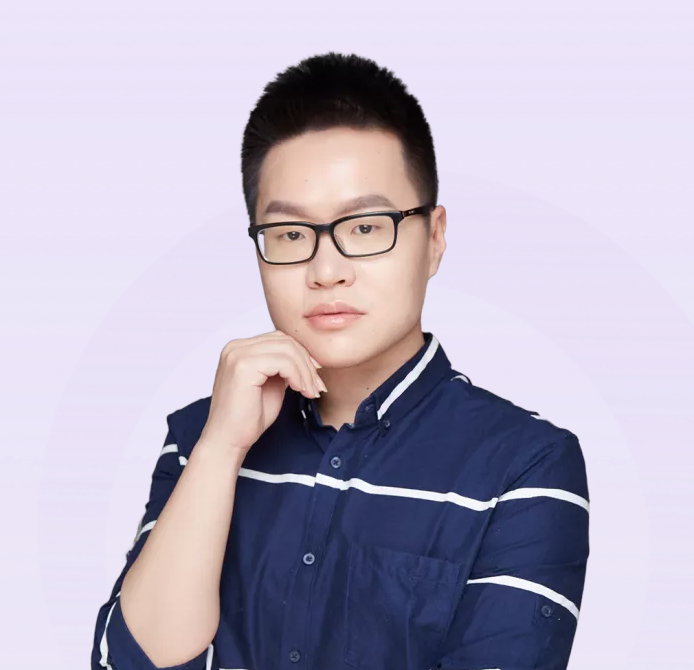
郭忆
网易 网易数帆 有数产品负责人 - Topic 4
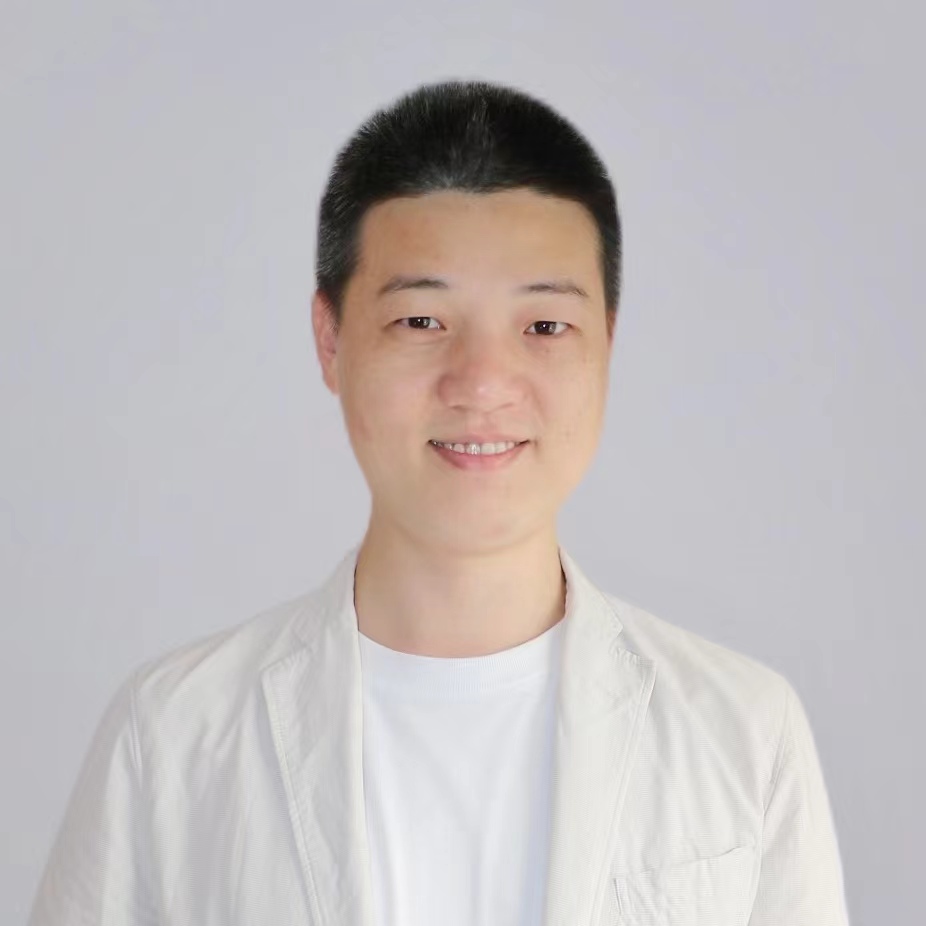
许汝全
趣丸科技(TT语音) 数据治理负责人 & 技术委员会委员 - Topic 5
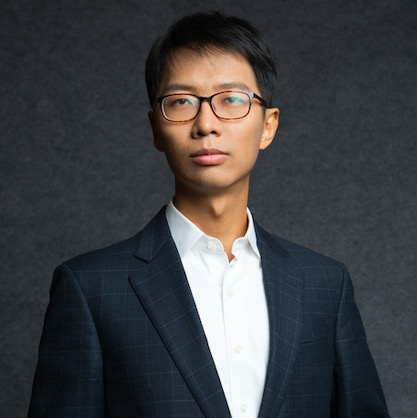
苏锐
Juicedata Inc. 合伙人
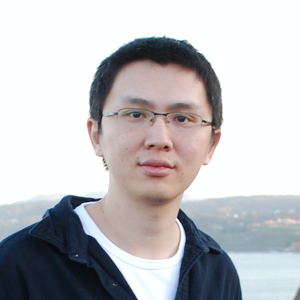
专题出品人:李潇
DatabricksEngineering Lead
Xiao Li is an engineering lead, Apache Spark committer and PMC member at Databricks. He is leading and managing five teams for development of Apache Spark, Databricks Runtime and DB SQL. His main interests are on data lakehouse, data replication and data integration. Previously, he was an IBM master inventor and an expert on asynchronous database replication and consistency verification. He received his Ph.D. from University of Florida in 2011.
Xiao Li 是 Databricks 的工程主管、Apache Spark 贡献者和 PMC 成员。他领导和管理五个团队,负责开发 Apache Spark、Databricks Runtime 和 DB SQL。他的主要兴趣是数据湖、数据复制和数据集成。此前,他是 IBM Master Inventor 荣誉的获得者,也是数据库异步复制和一致性验证方面的专家。他于 2011 年在佛罗里达大学获得博士学位。
地点:白云宴会厅2
专题:现代数据架构选型
数据仓库(Data WareHouse)和数据湖(Data Lake)存在已有一段时间,各有千秋,又各有不足,在大多数情况下,二者可以很好地共存和互补。但如今,湖仓一体(Data LakeHouse)的概念横空出世。这是一种全新的架构,它将二者结合,用作数据仓库和数据湖的单一平台。但它是否真的能带来两全其美的效果?本专题希望能探讨围绕数据仓库、数据湖、湖仓一体所做的技术选型。
by 朱诗雄
Databricks
资深软件工程师by 李劲松
阿里云
技术专家 & Flink PMCFlink Table Store 是一个流批统一的存储,用于在 Flink 中为流批处理建立动态表,支持实时流消费和实时 OLAP 查询。Flink Table Store 已经发布了第一个前瞻版本,但是缺少了生态和稳定性的不少工作。目前我们已经开始研发第二个版本,我们希望第二个版本能够带来更多的生产能力,通过此次分享你可以了解到我们通过加强哪些方面来提高存储的可靠性和生态。另外,我也会分享后续的架构,以及如何达成统一的流仓的存储。
演讲提纲:
- 实时存储现状及问题
- 流批存储概念不统一
- 流批存储复杂度太高
- Flink Table Store 0.1 实践
- 统一的 API 和易用性
- 流批统一的架构
- 实时的流消费和 OLAP 查询
- Flink Table Store 0.2 前瞻
- 目前的问题和需求
- 核心能力增强
- 加强生态
- Service 模式
- Service 的架构设计
- 实时离线一套存储
- 总结和展望
你将获得:
- 了解分布式流批一体存储相关的设计和取舍
- 了解一些技术细节
by 郭忆
网易
网易数帆 有数产品负责人Connect Not Collect 是 DataFabric 的内涵,DataFabric 也被全球数据分析领域最顶级的权威机构 Gartner 评选为 2021 年十大技术趋势之一。为什么 DataFabric 被誉为下一代的数据架构?其实作为一个企业,经常会面临不同的数据分散在不同的计算存储引擎中,包括 Oracle、SQL Server 为主的关系型数据库,Greenplum、DorisDB、Clickhouse 为主的分析型数据库,当然还有以 CDH、HDP 为主的数据湖。因为数据的实时性要求不同,规模不同,数据结构不同,最终我们需要用不同的计算存储引擎去满足不同场景的需要。但是这些对业务有分析价值的数据,都是企业的数据资产,我们需要去进行统一的管理,统一的开发和统一的分析。所以网易在 2021 年就提出了“逻辑数据湖”的概念,希望基于元数据,形成一个“逻辑统一,物理分散”的逻辑数据湖。
演讲提纲:
1. DataFabric
2. 网易逻辑数据湖
3. 基于逻辑数据湖的实践
你将获得:
- 面对不同的计算、存储引擎,如何选择一个统一的架构,提高分析人员的效率
- 对不同的计算、存储引擎的数据,如何构建企业的数据资产,进行统一的管理
by 许汝全
趣丸科技(TT语音)
数据治理负责人 & 技术委员会委员趣丸科技的数据架构从数据仓库逐步演进到数据平台,但数据架构并没有脱离某种形式的中心化系统,数据通过汇集、清洗和加工,统一到某个中心,通过数据分析和算法实现数据价值。随着大数据建设的持续推进,汇集的大量数据并没能真正发挥作用。数据生产者、数据处理者和数据使用者之间缺乏统一语言,造成难以将数据真正转化为商业竞争力。如何有效地利用数据赋能业务仍然是一个困局。为此,趣丸科技的数据架构做出了进一步的探索,引入了 Data Mesh 数据架构理论作为指导,一方面通过去中心化的数据治理,降低数据的使用门槛;另一方面通过构建统一数据底座,降低数据的认知负荷。最后形成了有别于传统以数仓/数据湖为主体的数据架构体系。
演讲提纲:
1. 趣丸数据架构的演进回顾和面临的挑战
2. Data Mesh 架构理论和实践历程
- Data Mesh 架构理论的启示
- 数据治理平台的初步构建
- 从数据技术到数据工程
- 统一数据底座的技术实现
- 从数据工程到数据中台
3. 总结
听众收益:
- Data Mesh 架构理论的应用
- 两个学术理论的实际应用
- 如何识别和破除布雷斯悖论
- 木桶效应在数据工程中的体现及解决思路
by 苏锐
Juicedata Inc.
合伙人关注主办方(InfoQ)
联系我们
交通指南
广州万富希尔顿酒店
Hilton Guangzhou Baiyun
地址:广州市白云区云城东路515-517号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 15600537884

领取往期热门演讲视频

票务经理