目前担任 OpenMLDB PMC 以及第四范式平台架构师,曾担任小米云深度学习平台架构师以及优思德云计算公司存储和容器团队负责人。活跃于分布式系统、机器学习相关的开源社区,也是 HBase、OpenStack、TensorFlow、TVM 等开源项目贡献者。
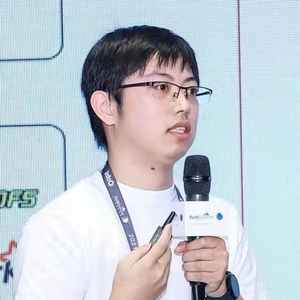
专题演讲嘉宾:陈迪豪
第四范式平台架构师
by 陈迪豪
第四范式
平台架构师AI 已经成为计算机基础架构中不可或缺的一环,而针对 AI 场景优化的数据库也应运而生。AI 数据库不仅功能上要满足特征工程以及机器学习模型的上线需求,在离线和在线性能上也有更高的要求。数据库的内存优化不仅可以让线上服务器存储更多在线数据,在离线分布式计算上也可以让每个分区占用资源更少,计算性能也有大幅提升。OpenMLDB 是针对 AI 场景深度优化的数据库,为了实现以上内存优化目标,设计并落地了一套内存优化方案,希望通过精巧的内存布局设计以及跨语言指针传递来实现极致的性能优化。但在实际做的过程中,我们也遇到了内存格式不匹配、跨语言数据传递等问题,最终通过统一编解码优化方案解决了这些问题,可以实现特定场景下数倍甚至数十倍的性能提升,本次将给你分享我们的经验。
演讲提纲:
1. AI 数据库与内存性能优化
2. OpenMLDB 与 Spark 内存方案
3. OpenMLDB 统一编码优化实现
4. 内存优化在 AI 场景的应用实践
你将获得:
- 了解前沿的 AI 数据库架构设计
- 了解数据库内存优化思路以及实现细节
- 了解 OpenMLDB 内存优化在 AI 场景的实践
关注主办方(InfoQ)


联系我们
交通指南
北京·四季酒店
Beijing International Convention Center
地址:北京市朝阳区亮马桥路48号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 15600537884

微信联系我们
小姐姐