毕业于哈尔滨工业大学,百度智能云异构计算团队加速方向技术负责人,专注于面向 AI 的云上基础设施建设工作,有近 10 年分布式及 AI 优化经验。推动了万卡规模异构大集群建设和落地,支撑百度文心等超大模型的训练和发布。
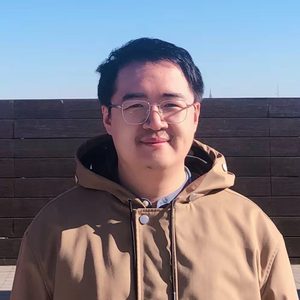
专题演讲嘉宾:孙鹏
百度资深研发工程师
by 孙鹏
百度
资深研发工程师千亿、万亿、十万亿……超大规模预训练模型是目前AI行业最火热的方向之一,百度近年也分别在 NLP、VIS 等领域发布多个效果领先的超大规模预训练模型。模型参数短时间内的爆炸式增长,搭配海量训练数据,一方面为业务带来很大的生产价值,另外一方面也对基础设施的建设提出了前所未有的挑战。 本次演讲站在基础设施的视角,从超大模型训练需求出发,结合训练过程中实际遇到的生产问题,分析基础设施各环节(如单机、网络、通信、调度、框架等)的问题与优化空间,介绍相关优化技术方案、选型及最佳实践。
演讲提纲:
1. 自顶向下——超大模型训练对基础设施提出新的需求
2. 逐层拆解——从单机硬件到大规模集群各层次的问题与优化空间分析
3. 系统优化——AI工程化中软硬结合联合优化方案与案例分享
4. 未来展望——异构算力发展为大模型训练带来新的机会
听众收益:
- 了解大模型训练全过程对基础设施带来的问题和挑战
- 学习业界前沿的大模型训练软硬结合联合优化方案与效果
- 了解百度智能云从基础设施视角看未来大模型训练的观点
关注主办方(InfoQ)


联系我们
交通指南
北京·四季酒店
Beijing International Convention Center
地址:北京市朝阳区亮马桥路48号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 15600537884

微信联系我们
小姐姐