毕业于新加坡国立大学,曾就职于 PayPal AI Infra,从事大数据数据湖、ML 特征工程等相关工作 8 年,取得过十余份该领域的专利。目前是字节跳动基础架构 Iceberg 数据湖、Feature Store 样本存储的主要负责人。
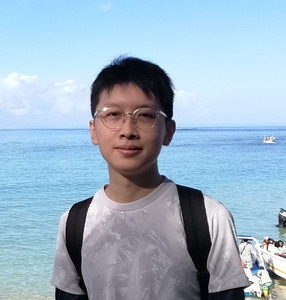
专题演讲嘉宾:谢凯
字节跳动基础架构研发工程师
by 谢凯
字节跳动
基础架构研发工程师深度学习的模型规模越来越庞大,其训练数据量级也成倍增长,这对海量训练数据的存储方案提出了更高的要求:怎么样更高性能地读取训练样本、不让数据读取成为模型训练瓶颈,怎么样更高效的支持特征工程、能够更便捷地增删和回填特征。传统的数仓方案和直接使用 Hadoop 或对象存储来存放样本都不能很理想的满足以上业务需求。 本次演讲将介绍字节跳动如何通过 Iceberg 数据湖支持 EB 级机器学习样本存储,实现高性能特征读取和高效特征调研、特征工程加速模型迭代。
演讲提纲:
1. 背景与趋势
- 机器学习与训练样本
- 传统数仓、Hadoop 或对象存储在机器学习样本存储场景上的不足
- 数据湖
- 业界数据湖方案调研
- 优势、不足与挑战
2. 字节跳动自研强化版 Iceberg
- 设计目标和系统分层
3. 机器学习样本存储实践
- 极致高效的特征调研与特征工程
- 高性能读时合并引擎
- 更多 EB 级样本存储的最佳实践
4. 总结与展望
- 对 LLM 和特征工程的思考
你将获得:
- 了解字节跳动数据湖方向的前沿技术与成果
- 了解 EB 级机器学习样本存储的最佳实践
关注主办方(InfoQ)


联系我们
交通指南
广州·粤海喜来登酒店
Hilton Guangzhou Baiyun
地址:广东省广州市天河区天河南街道天河路208号粤海天河城商业F3

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
在报名过程中如有任何问题,欢迎微信扫描二维码联系我们的票务经理