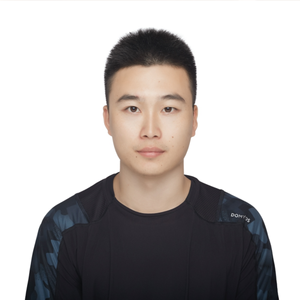
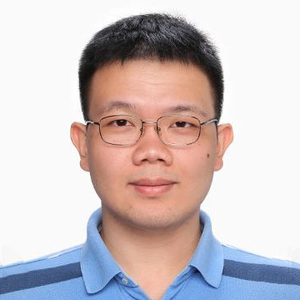
目前就职于百度,目前负责百度智能云百舸 AIAK 训练加速套件研发,专注于模型训练的加速探索与实践工作;在过去几年一直负责百度内部大规模 GPU 训练集群研发工作,对于集群调度、分布式训练、资源效能提升等有深入的实践经验。
讲师介绍
议题介绍
地点:富力 1
所属专题:异构计算
演讲:大模型分布式训练性能优化与实践
这次演讲主要探讨大模型分布式训练的基本原理与优化方案。首先,我们将介绍百度百舸AIAK 在模型训练领域的工作成果,以及针对大模型训练的解决方案。随后我们将聚焦大模型训练性能优化的关键技术原理,分析常见的分布式并行策略,拆解性能优化的主要技术,以及百度智能云的具体工程实践方法等。此外,我们还将讨论面向未来的一些探索工作,如针对算力、模型、规模等不断变化的需求,如何进行自适应的分布式训练,使模型训练门槛更低,效率更高。
演讲大纲:
1. 大模型训练性能优化原理与实践
2. 百舸 AIAK 在模型训练方向的工作介绍
3. 大模型分布式训练的基本原理与优化实践
4. 面向未来的工作——自适应训练技术
你将获得:
- 了解百度百舸 AIAK 在模型训练领域的实践和积累
- 了解大模型训练领域的主要技术挑战和性能优化思路
关注主办方(InfoQ)
联系我们
交通指南
北京·富力万丽酒店
Renaissance Beijing Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小姐姐