为了更好的表征信息和特征,生成式 AI、图计算、推荐系统等 AI 业务的模型规模... 展开 >
异构计算
会议室:富力 1出品人:黎世勇
- Topic 1
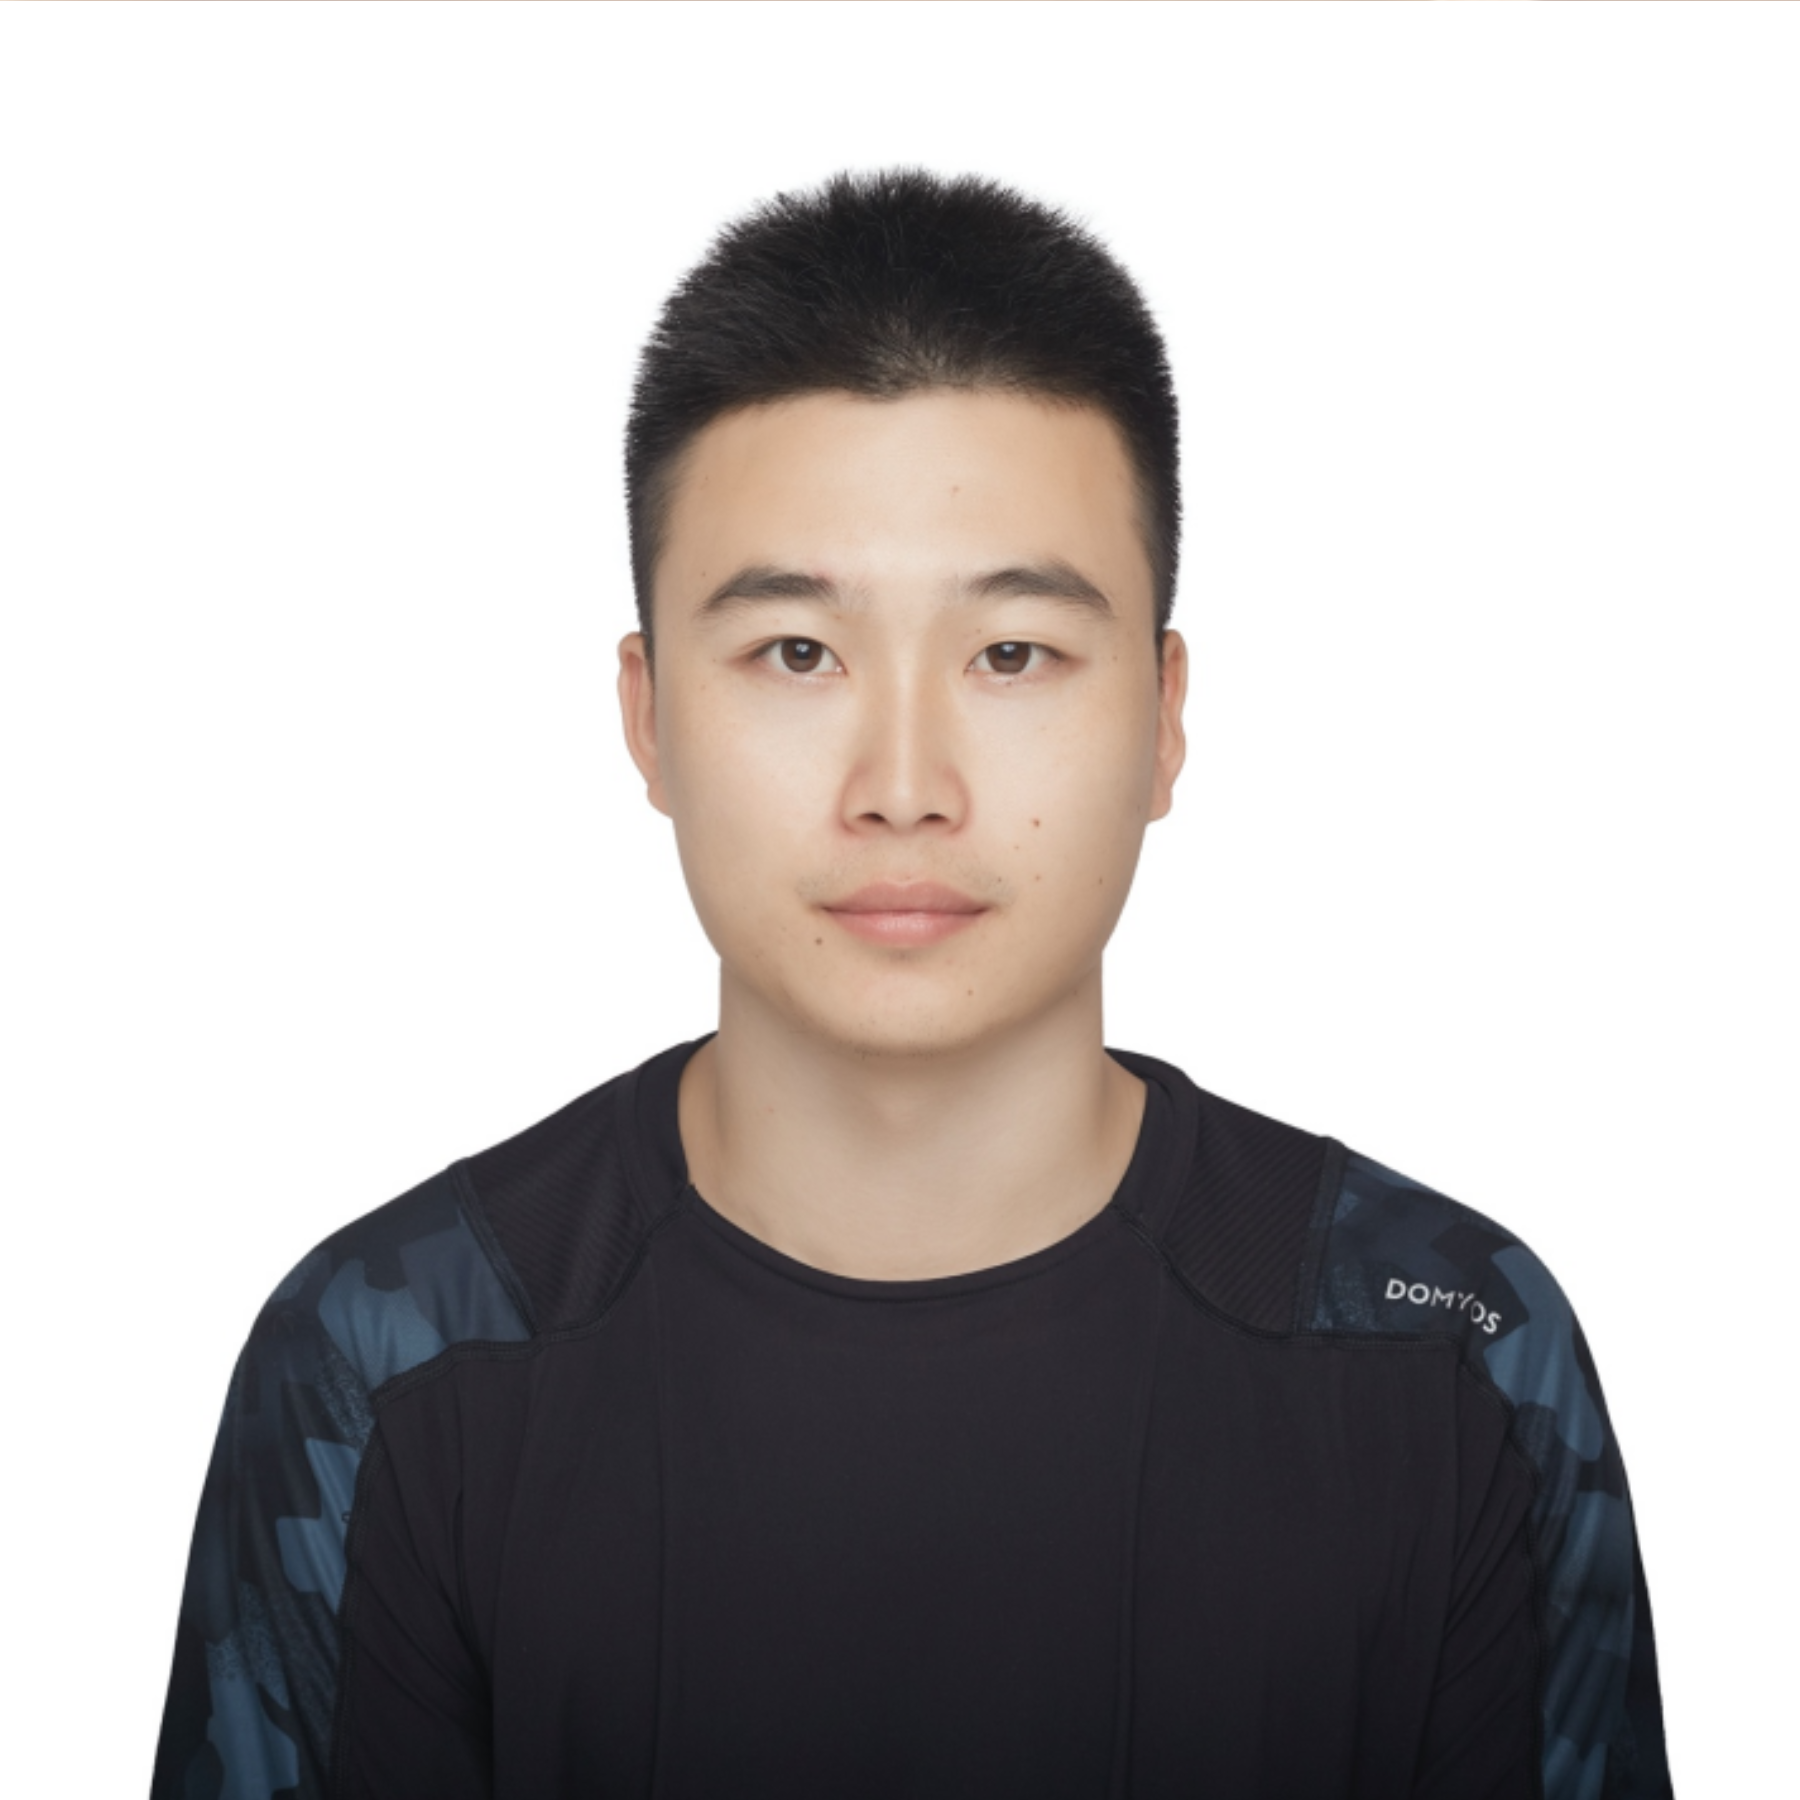
张恒华
百度智能云 资深研发工程师 - Topic 2
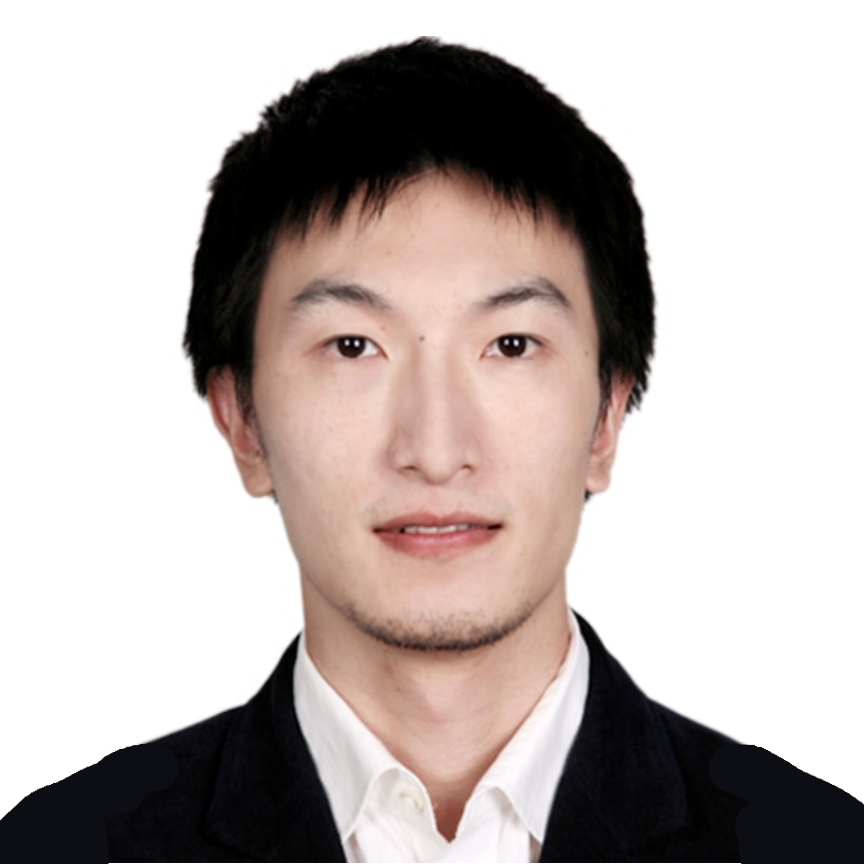
钟永根
华为昇腾 高级工程师 - Topic 3
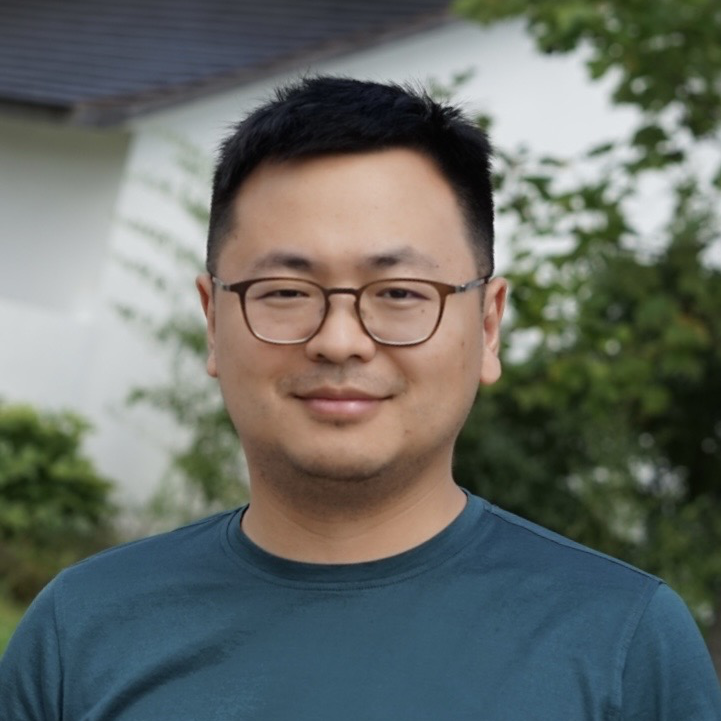
苏立
阿里巴巴 达摩院技术专家 - Topic 4
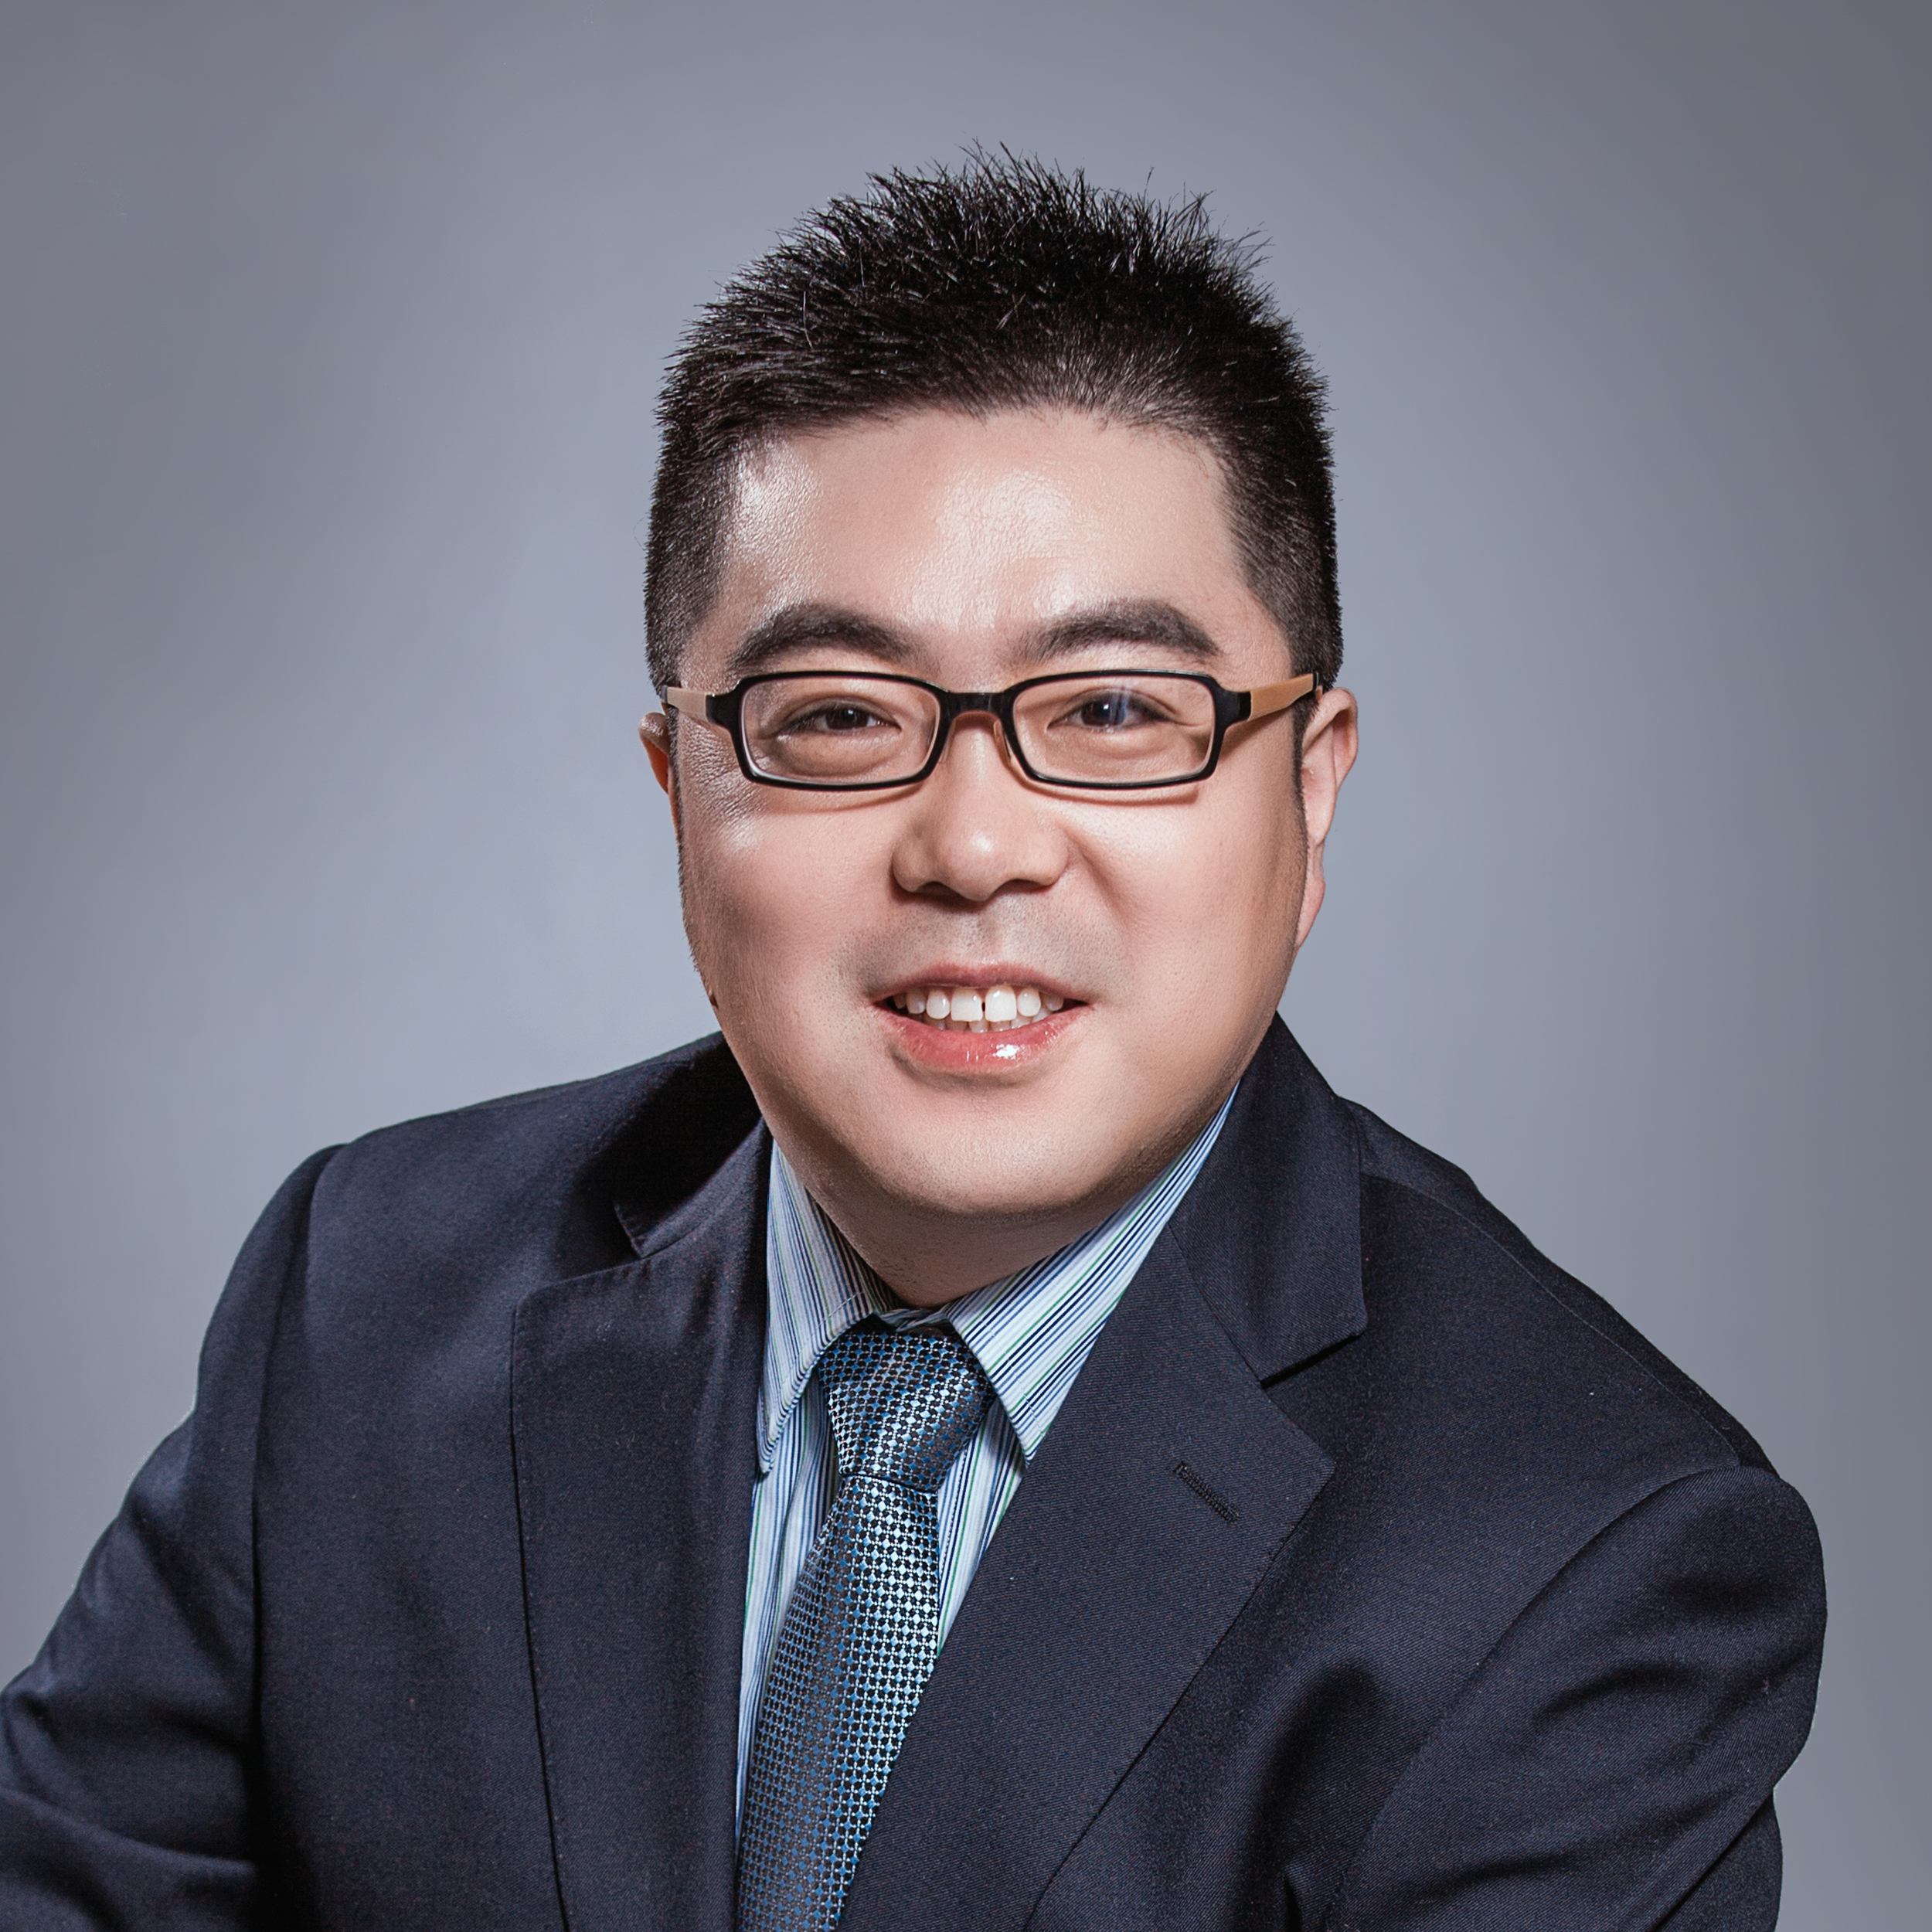
王璞 博士
达坦科技(DatenLord) 联合创始人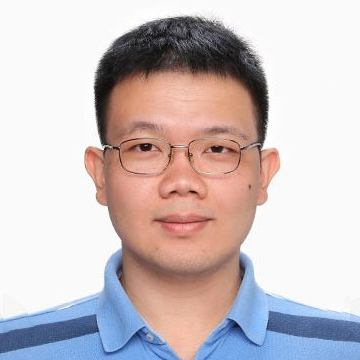
白巍 博士
微软研究院 资深研究员
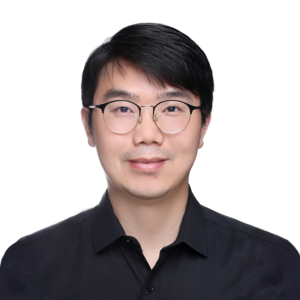
专题出品人:黎世勇
百度智能云异构计算技术负责人
地点:富力 1
专题:异构计算
为了更好的表征信息和特征,生成式 AI、图计算、推荐系统等 AI 业务的模型规模越来越大。随之而来的,无论是模型的训练还是推理部署所需要的算力规模也越来越大,成本越来越高 (GPT 的训练成本上亿元)。怎样为各种场景构建高效的算力系统,是各个企业密切关注的问题,这需要从芯片、网络、系统软件多个方面来解决相关的瓶颈和技术问题。本主题会分享各种场景下 (特别是生成式大模型下),不同技术方向为构建高效的算力系统所做出的努力和成果。
by 张恒华
百度智能云
资深研发工程师这次演讲主要探讨大模型分布式训练的基本原理与优化方案。首先,我们将介绍百度百舸AIAK 在模型训练领域的工作成果,以及针对大模型训练的解决方案。随后我们将聚焦大模型训练性能优化的关键技术原理,分析常见的分布式并行策略,拆解性能优化的主要技术,以及百度智能云的具体工程实践方法等。此外,我们还将讨论面向未来的一些探索工作,如针对算力、模型、规模等不断变化的需求,如何进行自适应的分布式训练,使模型训练门槛更低,效率更高。
演讲大纲:
1. 大模型训练性能优化原理与实践
2. 百舸 AIAK 在模型训练方向的工作介绍
3. 大模型分布式训练的基本原理与优化实践
4. 面向未来的工作——自适应训练技术
你将获得:
- 了解百度百舸 AIAK 在模型训练领域的实践和积累
- 了解大模型训练领域的主要技术挑战和性能优化思路
by 钟永根
华为昇腾
高级工程师生成式 AI 能为各个业务场景带来交互、生成、理解等各方面能力的提升,为大家带来体验上的变革。但大模型的部署会带来算力需求的急剧膨胀,成本问题会非常严重。此外大模型的巨大计算量也会给业务请求带来延迟上的增加,影响 AI 产品的业务体验。本主题主要介绍基于华为昇腾软硬件平台构建大模型推理场景下低成本、低延迟的解决方案,期望软硬结合的解决大模型部署过程的效率和时延问题。
演讲提纲:
1. 昇腾全场景 AI 平台介绍
2. 典型大模型场景部署方案和整体架构
3. 基于 PyTorch 的在线推理模式
4. 基于 IR 的离线部署模式
你将获得:
- 了解大模型推理部署下的关键问题
- 了解华为昇腾在大模型推理场景下的技术能力
by 苏立
阿里巴巴
达摩院技术专家图神经网络在推荐系统、网络安全、金融风控等诸多领域有着广泛的应用。工业场景中的图具有大规模(百亿到千亿级别边)、异构(点边类型多)、属性丰富等特点。工业级大图往往超出单机系统的处理能力,而以 CPU 采样为主的开源分布式训练系统在性能上难以满足业务的实际迭代需求,且存在 GPU 利用率低等,CPU 和 GPU 资源比例分配不合理等问题。本次演讲将基于开源分布式 GPU 加速图训练框架 GraphLearn-for-Pytorch(GLTorch) 和一站式图计算平台 GraphScope,介绍达摩院图计算团队和阿里云机器学习 PAI 团队在合作打造 GLTorch 过程中的技术思考和系统设计理念,并分享在一站式图计算领域的实践积累和技术探索。
演讲提纲:
1. 背景与趋势
- 图神经网络原理和应用
2. 工业级大图在训练过程中的挑战
- 工业级大图的特性
- 现有系统架构在解决上述挑战是的问题和不足
3. 图神经网络训练过程中的性能瓶颈分析
- 典型图神经网络训练流程介绍
- 结合数据和硬件特性分析训练过程中的性能瓶颈
- 介绍 Legion,GNNLab 等研究工作在解决 GPU 加速训练上的探索
4. 工业级 GPU 加速分布式图神经网络训练的系统实践
- GLTorch 整体系统架构设计的思考
- 存储层设计、NVLink 缓存加速和分布式全异步采样技术实践
- 贴合实际应用场景的灵活部署
- 开源生态兼容
5. 图神经网络和一站式图计算应用实践
- 图数据 ETL,推理 / 训练不同负载的图计算需求
- 图计算算法的应用和对图神经网络训练效果的增益
6. 一站式图计算:场景、挑战和方案
- 实际应用中的图计算 Workflow
- 用户使用多种图计算 / 图神经网络系统时面临的挑战和困难
- GraphScope Flex 产品思路和技术框架
- GraphScope Interactive/Analytics/Learning 引擎
- 一站式图计算对图存储的技术挑战和实践
- 跨引擎数据访问接口和标准化图数据文件格式
7. 总结和展望
你将获得:
- 了解分布式图神经网络训练和一站式图计算领域的前沿技术趋势
- 了解大规模分布式图神经网络和图计算系统上的工程实践经验
- 了解图计算和图神经网络的应用落地经验
分布式存储已经在公共云中被广泛采用,而网络是实现云存储服务高性能和高可靠性的关键。微软是在云上最早大规模部署 RDMA 的公司,目前微软的 Azure 云上超过 70% 的 RDMA 流量都已经是 RDMA。Azure 选择 RDMA 作为高性能存储网络,目标是使其支持存储前端流量 (计算集群和存储集群之间) 和后端流量 (存储集群内),以实现高性能分布式存储。RDMA 可以显著改善磁盘 I/O 性能并节省大量 CPU 资源。
本次分享着重介绍 Azure 落地 RDMA 的经验。首先,基础设施的异构性带来了一系列新挑战,例如不同类型 RDMA 网卡之间的互操作性问题。其次,由于计算和存储集群可能位于 Azure 区域内的不同数据中心中,因此还需要在跨数据中心场景支持 RDMA。
你将获得:
- 深入理解 RDMA 网络的技术特点
- 如何解决 RDMA 网络落地的难点
- 如何监控 RDMA 网络的性能
关注主办方(InfoQ)
联系我们
交通指南
北京·富力万丽酒店
Renaissance Beijing Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小姐姐