毕业于清华大学电子系,从事计算机视觉及 AI 图像领域的研究与应用,是B站多媒体实验室算法负责人,面向视频质量体系、AI 智能化生产,及基于机器学习感知编码等业务方向
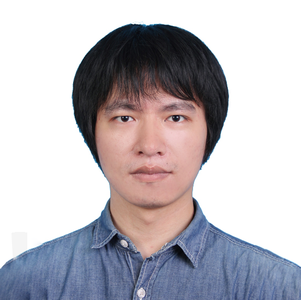
专题演讲嘉宾:成超
B 站多媒体实验室算法负责人
by 成超
B 站
多媒体实验室算法负责人AI 的发展为多媒体技术体系提供了越来越多的可能性。传统多媒体在提升音视频转码、存储、分发等基础服务质量上的应用已经相当成熟,在此基础上结合前沿 AI 算法我们能够进一步提升用户观感体验,并促进创作者权益保障体系的完善。 从用户体验的角度出发,我们建立了一套非常完整的覆盖云 / 边 / 端、点 / 直播的画质增强链路;利用大语言模型提升用户对信息流的汲取效率。 从 UP 主权益的角度出发,我们在不断尝试通过技术手段为 UP 主拓展更多的收入增长模式;在版权意识崛起的今天更好的保障 UP 主的创作成果。
演讲提纲:
1. 全链路视频画质质量监测与提升
2. 基于 LLM 的视频拆条应用落地
3. 虚拟广告植入的技术探索
4. 面向规模化的AI视频数字水印系统
你将获得:
1. B站多媒体实验室的研发热点
2. 前沿技术落地的经验与思考
关注主办方(InfoQ)
联系我们
交通指南
北京·富力万丽酒店
Renaissance Beijing Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小姐姐