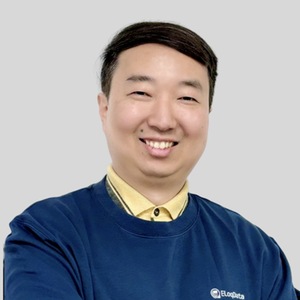
胡效赫,基流科技的创始人 / CEO。本科至博士均就读于清华大学,在清华就读博士期间,他已成功实现了全国首个 TB 级网络产品的落地,并在超级计算领域部署了千卡规模的模型通信方案。在高校及公司期间,完成数十万亿参数推荐大模型通信优化,首个软件定义自动化的国家级课题、14 篇网络系统方向 CCF-A 顶级论文,博士和博后期间负责及参与项目的累计经费近 2000 万元,导师和合作导师所参与公司的累积市值 500 亿美金。
讲师介绍
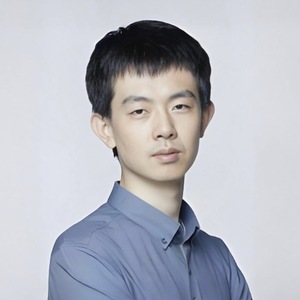
专题演讲嘉宾:胡效赫
基流科技创始人 / CEO
议题介绍
地点:北京厅2
所属专题:面向 AI 的研发基础设施
演讲:下一代自主智算系统:超大规模集群的工程实践与挑战
前沿大模型每一代算力需求指数级增长,超大规模集群是人工智能强国竞争战略的大国重器。下一代自主计算系统方案选型基于可扩展、高可用、国产化原则,从硬件层、平台层和业务层实现 GPU 解耦、网络解耦、自主可控软件,通过自研通信库、拥塞控制和负载均衡优化策略、高效能算力调度、自动化集群运维、国产 AI 通信系统、算存协同广域调度等技术构建超大规模自主智算集群,解决算力基础设施卡脖子问题,为前沿大模型发展提供算力支撑。
演讲提纲
1. 基础设施发展趋势
- Scale out、Scale up 层面实现超大规模集群建设
- 大模型基础设施全景图
- 大规模智算集群核心痛点及工程要求
2. 超大规模自主计算集群方案
- Galaxy 自主智算集群构建要点
- 可扩展设计:架构设计、通信库、网络优化、并行框架等关键技术
- 高可用设计:自研高效能算力调度、自动化算力运维平台
- 国产化设计:基于国产AI通信系统实现开放通用设计、垄断方案解耦
3. 十万卡智算集群解决方案
- 算存协同广域组网调度
- 长距离大模型训练实践
您认为,这样的技术在实践过程中有哪些痛点?
- 在 GPU 解耦层面,基于国产芯片的迁移适配、多元异构混合训练需要联合 GPU 厂商支持,且国产 GPU 在 Scale up 层面进展较慢,构建基于国产 GPU 的下一代自主智算系统难度较大
- 在国产 AI 通信层面,目前基于国产交换芯片的交换机最大交换容量是 25.6 T(64 个 400 G 端口),三层组网最大支持 65536 张卡,需要创新设计十万卡集群架构。
演讲亮点
- 国产全栈端到端 AI 通信系统方案:在交换机、集合通信库、拥塞控制调优、网络运维平台、长距和异构通信等方面,通过软硬件协同设计,形成全国产智算网络全栈产品和解决方案
- 丰富的大规模集群项目实施经验:方案中的关键技术累积应用在超过多个大规模智算集群,集群规模累积超过 4 万张国际先进 GPU 卡
关注主办方(InfoQ)


联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Jin
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手