随着大模型技术从技术变革转向产业变革,大模型应用也会进一步繁荣,传统基础设施技术... 展开 >
面向 AI 的研发基础设施
会议室:北京厅2出品人:郑然
- Topic 1
应茹
百度 智能云基础公有云部主任架构师 - Topic 2
沈桐
字节跳动 研发工程师 - Topic 3
黄维啸
月之暗面 系统工程师 - Topic 4
陈亮
晨章数据 创始人,首席架构师 - Topic 5
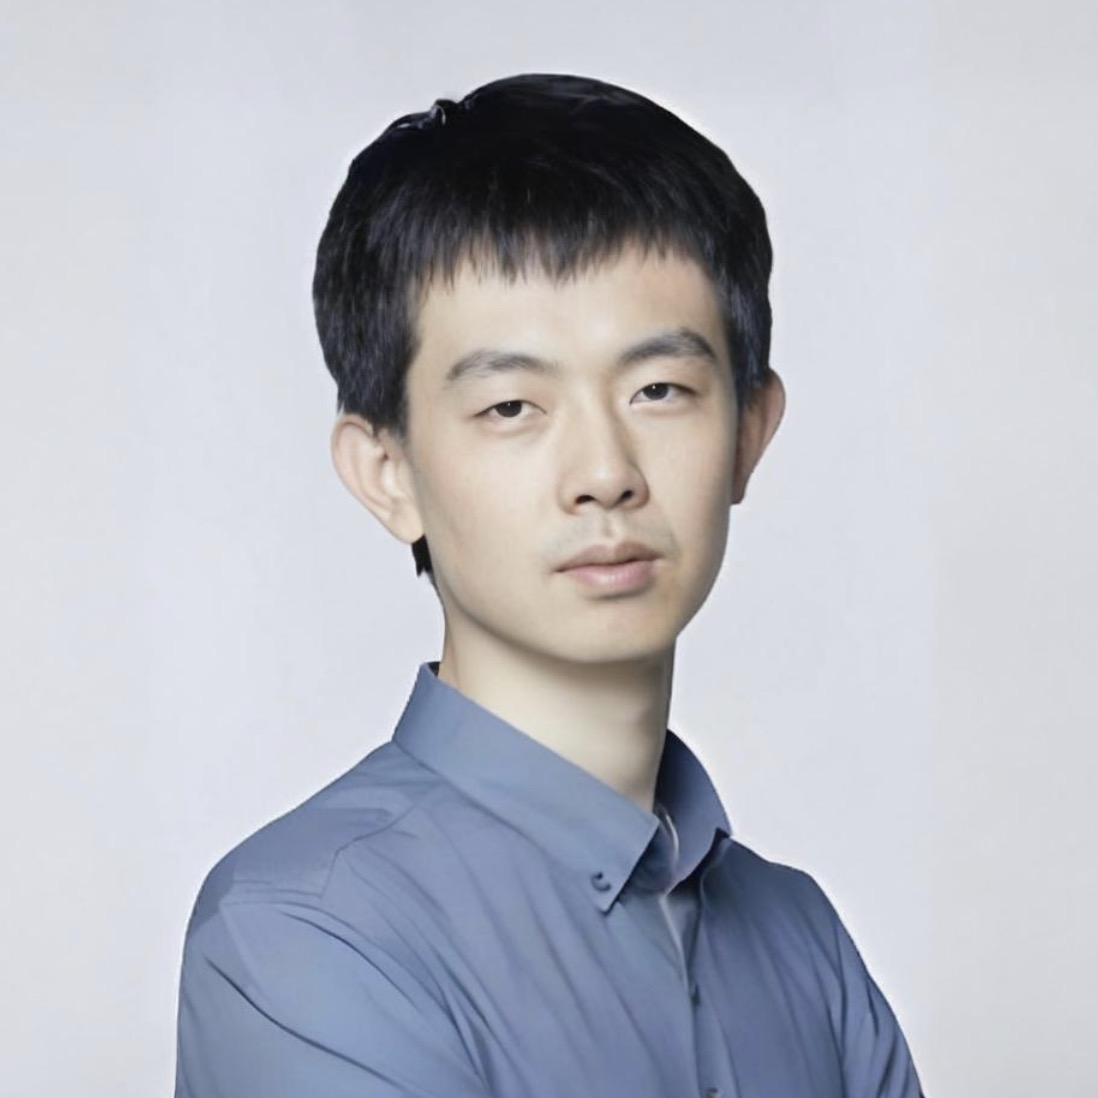
胡效赫
基流科技 创始人 / CEO - Topic 6
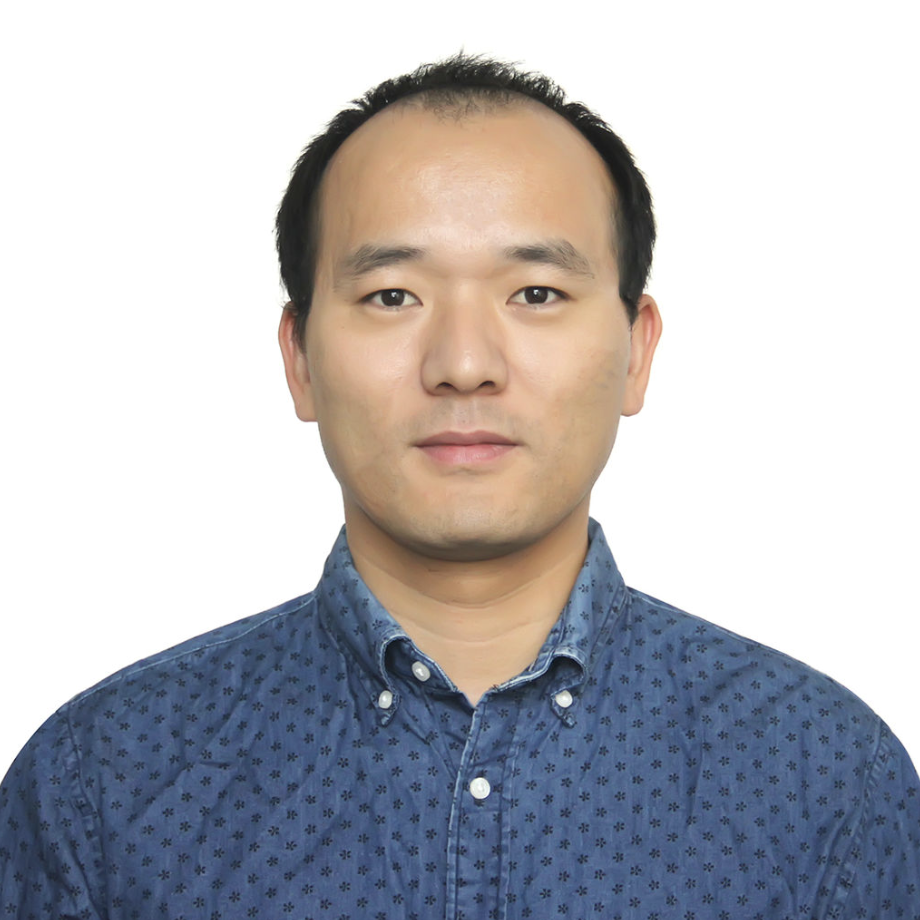
李虎
百度 网络架构师 - Topic 7
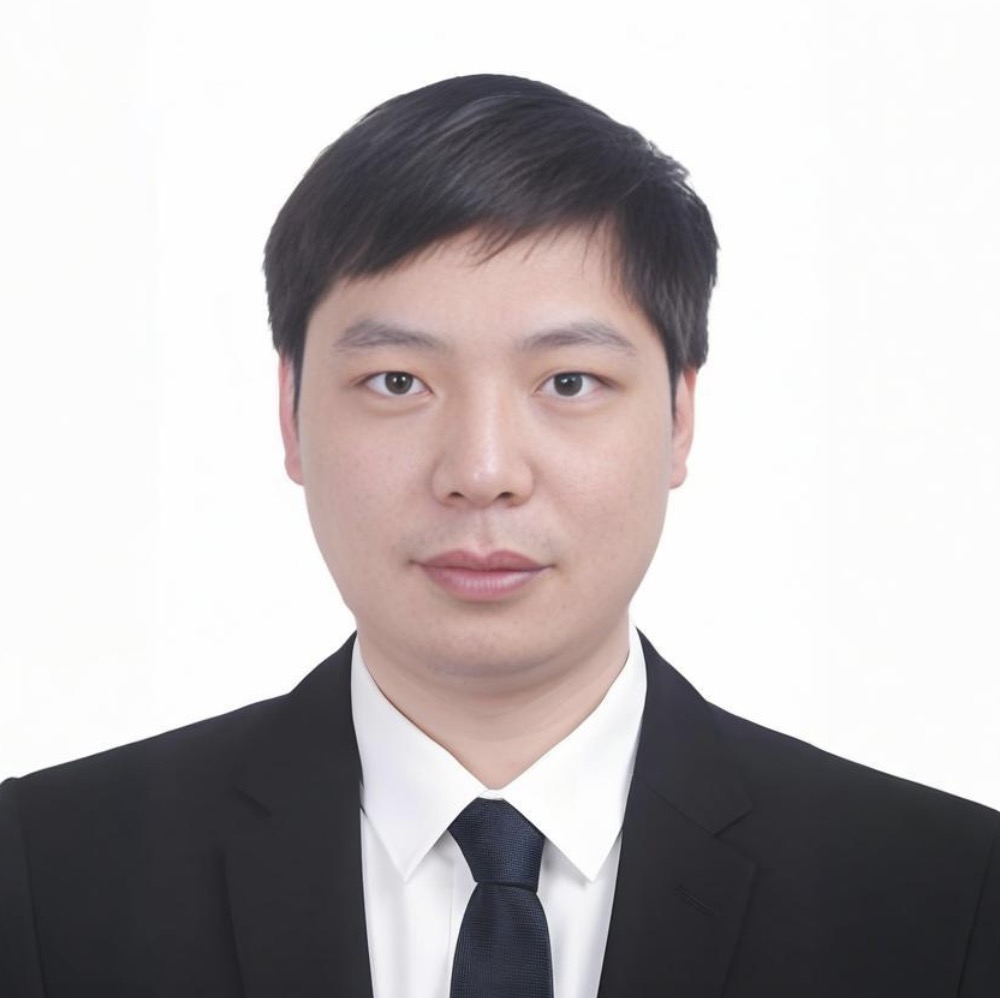
郑加利
华为 高级工程师
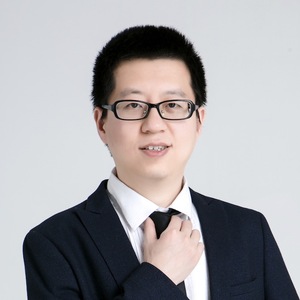
专题出品人:郑然
百度杰出架构师,百度智能云基础公有云技术负责人
郑然,百度杰出架构师,百度智能云基础公有云技术负责人。自加入百度以来,一直从事分布式系统和工程架构的研发工作,先后负责大规模分布式索引系统、云原生平台、分布式存储技术、虚拟化和弹性计算技术等大型分布式系统的设计和研发工作。积极参与技术社区活动,多次担任 QCon /TOP 100 等技术大会的联席主席,讲师,出品人等。
地点:北京厅2
专题:面向 AI 的研发基础设施
随着大模型技术从技术变革转向产业变革,大模型应用也会进一步繁荣,传统基础设施技术已经不足以满足大模型应用的快速发展。在 AI 原生应用快速演化的过程中,从机房布局、供电、散热到高性能网络和线缆的技术、芯片和服务器设计,再到分布式训练和推理, transformer 算法和工程的优化等,整个基础设施技术和产业链正在快速转型,向大模型基础设施技术演变。
本专题将深入分析 AI 基础设施的关键技术,包括机房服务器和芯片设计、大规模高性能网络技术、分布式模型并行技术、推理架构优化、算法和工程的结合等优化技术,以及它们在大规模生产环境中的应用和实践。
涵盖方向:
- AI 机房和服务器设计(液冷、功耗、 布局、高密等)
- AI 芯片的设计和方案实践(NV / Intel / AMD /国产芯片等)
- 高性能网络(网络架构 / 跨地域传输 / 线缆 / 集合通信等)
- GPU 虚拟化 / 机密计算(容器虚拟化 / 虚机优化 / 机密计算技术等)
- 分布式训练架构(序列并行、模型并行、流水并行、 数据并行等)
- 推理服务架构( vllm / kvcache / 任务调度等)
- 算法和工程的结合(高效微调、模型量化、知识蒸馏等)
通过本专题的深入探讨,希望让听众了解并掌握大模型基础设施技术的发展趋势和前沿动态,从企业工程实践和学术研究领域借鉴成功经验,为自身企业制定更大规模、更高性能以及更加稳定的大模型基础设施技术。
by 应茹
百度
智能云基础公有云部主任架构师大模型技术的迅速发展和AI应用的繁荣,对云 IaaS 基础设施提出了新的要求。IaaS 的单机虚拟化技术,基于其计算与设备的虚拟化能力,为云上应用提供极致性能与弹性的计算实例,在这样的背景下,我们也面向 AI 原生应用做了诸多探索和实践,如基于大模型性能和效率的评价视角进行端到端技术栈优化,面向 Serverless 训推场景推出安全容器虚拟化形态,以及面向 AI 数据安全场景落地训推一体的 AI 机密计算实例等等,以支撑 AI 原生应用在云上的高效运行。
演讲提纲
- 基于 DPU 的全资源售卖虚拟化架构
- 由大模型评价视角驱动的虚拟化技术栈优化
- Serverless 场景 AI 安全容器
- AI 机密计算实例
您认为,这样的技术在实践过程中有哪些痛点?
- 全资源售卖架构下无法达到 100% 持平裸金属的性能表现
- 安全容器在弹性与企业级特性之间需要有所取舍
- 机密计算实例在安全与性能之间需要由所取舍,性能优化之路道阻且长
演讲亮点
- 整体虚拟化架构从传统架构向基于DPU的全资源售卖架构转变,各 DPU 厂商的在设备模拟方面的实现方案各有差异,虚拟化架构需要清晰划分边界高效对接、纳管同时推动设备虚拟化往统一的形态去发展
- AI 智算视角的虚拟化技术迭代,如何利用通算场景积累的优势,同时又面向智算去做演进和优化。
听众收益
- 理解云计算 IaaS 虚拟化架构的演进状态
- 在 AI Infra 蓬勃发展的背景中,IaaS 虚拟化架构可以做什么,做了什么,都有什么样的收益
by 沈桐
字节跳动
研发工程师在大模型应用开发过程中,如何将研究成果与软件工程紧密结合,并解决新领域中的新问题是开发者面临的重大挑战。本次分享将介绍基于 Golang 的解决方案,以字节跳动的实际产品功能为例,重点介绍 Eino 框架在 “组件” 抽象和业务编排方面的创新实践,解决字节实际业务场景中的问题。希望能让听众收获 Eino 框架在大规模生产环境中的应用价值与实践经验参考。
演讲提纲
1. 大模型应用开发过程的挑战
- 研究成果与软件工程的脱节
- 语言和生态差异
- 认知和术语差异
- 新领域的新问题
- 可枚举的组件,多变但有迹可循的编排模式
- 基于数据帧的流式处理
2. 基于 Golang 的解决方案
- 基于 Golang 的大模型应用开发框架:Eino
- Golang 的优势:编译期强类型检查
- 定义组件抽象,提供组件实现
- 解决组件编排使用的问题
- 两个重要的解决方案:
- 通过类型对齐,尽早发现代码错误
- 流式数据传输和处理
3. 分享一个字节跳动的实际产品功能从需求到生产的过程
- 需求引发框架功能的扩展
- 编排实现业务流程
- 具体痛点解决过程
4. 经验总结
- 应用开发框架作为基础设施的真正作用和正确使用姿势
- 从实践出发,按需跳出框架的范围
您认为,这样的技术在实践过程中有哪些痛点?
- 基于 Golang 的 AI 应用生态,相比 Python 的 AI 应用生态,在覆盖面和丰富度上有不足
- Eino 作为一个基础设施性质的开发底座,需要时刻权衡“积极提供最新的功能扩展”和“最大程度保证 API 稳定,谨慎迭代”两个相反的考量
演讲亮点
- 基于实践经验,总结大模型应用开发过程中的真实痛点,并给出可落地的解决方案
- 分享真实案例,剖析实际问题解决过程
听众收益
- 针对大模型应用开发过程中的真实痛点,获取可落地的解决方案和思路
- 通过具体案例和时机演示,获得感性认识,提供思考的养料
by 黄维啸
月之暗面
系统工程师随着大模型训练的 Scaling up,对于基础设施的稳定性和高效性提出了更高的要求。本次演讲我将分享月之暗面在训推混部集群中的实践经验,重点探讨如何快速定位并隔离故障,实现任务的高效恢复,从而提升系统整体稳定性。同时,我还会分享如何在资源有限的情况下最大化利用率,避免浪费,进一步将该思路应用于强化学习任务的训练中。希望能为关注大规模模型训练的同行们提供一些可靠的技术思考与实践参考。
演讲提纲
1. 大规模训练推理集群的挑战
- 大规模集群中机器故障频率高,任务失败率高
- 推理场景中的用户请求具备潮汐效应
- 强化学习场景存在资源浪费情况
2. 提高训推混部集群稳定性和资源利用率
- 任务检查点的高效存储和回复
- 故障节点快速发现和隔离,提高训练可观察性,快速找到慢节点
- 潮汐优先级调度,最大化提高资源利用率
3. 通过混合架构提高强化学习效率
- 混合 Sidecar 部署架构
- 训推任务高效切换
您认为,这样的技术在实践过程中有哪些痛点?
- 大规模集群中机器故障问题难以彻底解决,系统上需要做一些权衡
- 训推混部集群存在资源利用率不均衡的问题
演讲亮点
- 通过实际大规模集群的训推混部经验以及框架侧的优化,真实提高了整个系统的可靠性和可扩展性
听众收益
- 了解大模型训练和推理中遇到的稳定性问题及相关实践方案,并进一步提高资源利用率
- 了解在强化学习中如何高效利用显存并提高系统可扩展性
by 陈亮
晨章数据
创始人,首席架构师随着大模型快速发展,以 AI agents 驱动的新一代 AI 原生应用快速发展,取得巨大成功。AI 原生应用以大模型为基础,通过各类 Agents 和应用数据交互,智能地完成各类任务。AI Agents 驱动的应用开发迭代迅速,同时维护多种模态的数据,不同模态数据的访问模式和流量差别巨大。这些特点给底层数据平台提出了新的挑战。未来 AI Agents 驱动的原生应用需要怎样的数据基座?本演讲将分享我们关于 AI 时代数据基座架构的思考,如何通过该架构解决 AI 原生应用的数据挑战,以及在云计算、新硬件环境下实现高性能数据基座的工程实践。
演讲提纲
1. AI agent 驱动的 AI 原生应用
2. AI 原生应用面临的数据挑战
- 多种数据模态
- 数据规模灵活多变
- 管理复杂
3. 多模态数据基座
- 数据库解耦
- 基于数据基层的多模数据基座
- 灵活扩缩容
- 多模态一致性访问
4. 面向未来的工程实现
- 趋势:云计算,弹性扩缩容
- 趋势:新硬件
- 打造服务 AI agents 高性能数据基座服务
5. 总结和展望
您认为,这样的技术在实践过程中有哪些痛点?
- 私有化部署和传统实践不同
- AI agents 开发者需适应数据基座新的数据处理能力
演讲亮点
- 通过创新的工程实践,将现有开源组件和新的数据基座整合,减少用户使用门槛
- 面向新一代编程框架的实现 (协程,异步 IO 等)
听众收益
- 给 AI 原生应用开发者提供数据管理的新思路
- 给 AI Infra 开发者在面向云计算、新一代硬件开发的参考和启发
by 胡效赫
基流科技
创始人 / CEO前沿大模型每一代算力需求指数级增长,超大规模集群是人工智能强国竞争战略的大国重器。下一代自主计算系统方案选型基于可扩展、高可用、国产化原则,从硬件层、平台层和业务层实现 GPU 解耦、网络解耦、自主可控软件,通过自研通信库、拥塞控制和负载均衡优化策略、高效能算力调度、自动化集群运维、国产 AI 通信系统、算存协同广域调度等技术构建超大规模自主智算集群,解决算力基础设施卡脖子问题,为前沿大模型发展提供算力支撑。
演讲提纲
1. 基础设施发展趋势
- Scale out、Scale up 层面实现超大规模集群建设
- 大模型基础设施全景图
- 大规模智算集群核心痛点及工程要求
2. 超大规模自主计算集群方案
- Galaxy 自主智算集群构建要点
- 可扩展设计:架构设计、通信库、网络优化、并行框架等关键技术
- 高可用设计:自研高效能算力调度、自动化算力运维平台
- 国产化设计:基于国产AI通信系统实现开放通用设计、垄断方案解耦
3. 十万卡智算集群解决方案
- 算存协同广域组网调度
- 长距离大模型训练实践
您认为,这样的技术在实践过程中有哪些痛点?
- 在 GPU 解耦层面,基于国产芯片的迁移适配、多元异构混合训练需要联合 GPU 厂商支持,且国产 GPU 在 Scale up 层面进展较慢,构建基于国产 GPU 的下一代自主智算系统难度较大
- 在国产 AI 通信层面,目前基于国产交换芯片的交换机最大交换容量是 25.6 T(64 个 400 G 端口),三层组网最大支持 65536 张卡,需要创新设计十万卡集群架构。
演讲亮点
- 国产全栈端到端 AI 通信系统方案:在交换机、集合通信库、拥塞控制调优、网络运维平台、长距和异构通信等方面,通过软硬件协同设计,形成全国产智算网络全栈产品和解决方案
- 丰富的大规模集群项目实施经验:方案中的关键技术累积应用在超过多个大规模智算集群,集群规模累积超过 4 万张国际先进 GPU 卡
by 李虎
百度
网络架构师本次演讲我将深入介绍百度 AI 网络架构的设计与实现,重点探讨在 AI 训练和推理过程中遇到的痛点问题及其创新解决方案,以及跨AZ(可用区)RDMA场景下的技术挑战与优化策略。最后,结合 DeepSeek 等前沿 AI 技术的发展,探讨其对 AI 网络架构带来的新需求与挑战,为未来 AI 网络的高效部署与扩展提供思路。
演讲提纲
1. 百度 AI 网络的发展历程
- 网络架构介绍,以及为何选择这类网络架构
- 百度自研交换机赋能百舸 AI 网络
2. AI 网络中痛点问题及解决方案
- 如何高效解决网络拥塞问题
- 如何高效定位网络故障
- AI 网络故障的全新解决思路
3. 跨 AZ RDMA 探讨
- 实验室测试数据分享和后续规划
4. 基于 DeepSeek 批量部署后,AI 网络遇到的新挑战
- MOE alltoall、PD 分离等场景下对网络带来的新挑战以及优化手段
您认为,这样的技术在实践过程中有哪些痛点?
- 没有一套网络架构或者参数是适用于所有模型的,我们需要在实践中输出最合适本公司的解决方案
演讲亮点
- 业内先进的拥塞控制解决方案
- 为了提升 AI 网络稳定性,百度实践经验
听众收益
- 基于网络侧的优化,提升超大规模 AI 网络的训练、推理性能
by 郑加利
华为
高级工程师大模型的训练过程极其复杂,不仅涵盖了众多技术层面,同时也面临着巨大的挑战。面对巨大规模的模型参数量与计算量,单靠一张计算卡难以满足需求,必须依赖多张计算卡进行并行计算。然而,大规模集群计算带来的复杂性显著增加,这在一定程度上拖慢了模型训练的速度。在此背景下,本次分享我将介绍昇腾 MindSpeed 分布式训练加速库通过在计算、通信以及显存等多个维度上的优化措施,来加速模型的训练过程,有效提升了训练效率,为大模型的训练提供了强有力支持的实践案例。
演讲提纲
1. 大模型训练的趋势与挑战
- 模型规模与计算需求:大模型参数量与计算量的指数级增长
- 分布式训练的复杂性:大规模集群计算带来的挑战
- 效率瓶颈:现有解决方案的局限性
2. 业界加速套件
- 主流加速库的特点与不足
- 昇腾 MindSpeed 的差异化优势
3. MindSpeed 架构设计
- 整体架构概览
- 核心模块与功能
4. MindSpeed 优化策略
- 通信优化
- 高效通信协议与算法
- 通信性能提升案例
- 内存优化
- 显存管理与优化技术
- 内存优化的实际效果
- 计算优化
- 算法加速与硬件适配
- 计算效率提升的关键点
- 并行优化
- 并行策略的灵活组合与实践
5. MindSpeed 的实战效果
- 性能提升案例:具体模型训练的加速效果
- 效率提升:训练时间缩短与资源利用率提升
- 行业应用:MindSpeed 在不同场景中的落地实践
6. 未来展望
- 昇腾 MindSpeed 的发展方向
- 对大模型训练的持续支持与创新
您认为,这样的技术在实践过程中有哪些痛点?
- 在此次演讲中提到的大部分技术点都属于使用场景广泛,成本较小。并行优化中会有一些优化点开发工作量相对较多
演讲亮点
- 显存优化中通过 BF16 与 FP32 数据格式同指数位的特点,共享显存地址,以节省显存开销,当前业界无此方案
听众收益
- 了解昇腾分布式训练加速库的一些前沿的技术和成果
- 开拓一些新思路,用新想法解决大模型中的显存和通信耗时
关注主办方(InfoQ)
联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Jin
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手