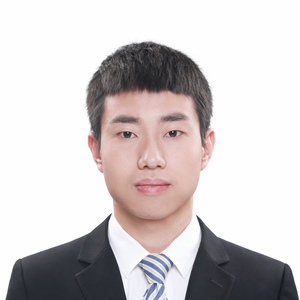
负责蚂蚁百灵Ming系列全模态模型(https://huggingface.co/inclusionAI/Ming-flash-omni-2.0 )研发,在多模态领域有丰富研发经验,发表CVPR/ICCV/ICML/NIPS等顶会议发表文章近30篇,授权国内外专利近40项。
讲师介绍
议题介绍
地点:首府5
所属专题:多模态理解与生成的突破
演讲:Ming-Flash-Omni:全模态统一大模型的关键技术与实践
构建一个同时具备视觉、语音、语言理解与生成能力的全模态统一模型,面临表征差异、模态失衡和训练效率三重挑战。我们提出 Ming-Flash-Omni,基于 100B 参数(6.1B 激活)的稀疏 MoE 架构,采用模态专属路由与双均衡机制在高稀疏度下实现多模态联合训练的稳定收敛;通过两阶段流水线(感知→生成)配合生成式分割范式,有效缓解理解-生成目标冲突;在基础设施层面,针对多模态数据和模型的双重异构性,设计了灵活并行策略与序列打包机制,将 MFU 从基线 7% 提升至 28%。最终模型覆盖图像/视频理解、图像生成与编辑、语音识别(含方言和上下文 ASR)、语音合成等六大方向,以仅100B-A6B模型参数在 50+ 公开 benchmark 上达到开源领先水平:视觉理解达到 Gemini 2.5 Pro ,图像生成 GenEval 0.94(SOTA),ContextASR 综合最优(Avg WER 3.30),方言识别领先同类模型 43%,多轮流式视频对话超越 Gemini 2.5 Pro。
演讲提纲
- 问题背景:为什么需要全模态统一模型,为什么难
- 从"模态专家拼接"到"统一全模态":技术趋势
- 三大技术挑战:表征差异(视觉连续 vs. 语音离散 vs. 文本符号)、模态失衡(不同模态数据量级和难度差异巨大)、理解-生成目标冲突(生成梯度干扰已学好的理解能力)
- 训练工程挑战:动态 batch / 变长序列导致 GPU 利用率低,编码器-解码器异构引入 pipeline bubble
- 全模态统一架构:稀疏 MoE + 模态专属路由
- 模态专属路由器设计:T-Router / V-Router / A-Router 如何让不同模态激活不同 expert 子集,避免模态间干扰
- 双均衡机制(辅助 load-balancing loss + per-router bias):解决高稀疏训练下 expert 坍缩
- 两阶段训练流水线:先 perception(三阶段预训练→两阶段指令微调→GRPO 强化学习)再 generation
- 踩坑经验:多轮跨模态交互:如何实现视觉 QA、音频描述、文档分析在单轮对话中的无缝切换
- 多模态生成:在统一模型中同时做好图像与语音生成
- 语音生成:用连续声学潜变量替代离散 token,消除量化损失;12.5Hz VAE 统一语音/音乐/环境音潜空间;方言可控生成(四川话 ACC 83.25%)
- 图像生成与编辑:生成式分割范式如何将理解能力传递给生成模块,实现身份保持、文字渲染等精细可控能力
- 视觉生成强化学习:多维奖励(真实感、指令遵循、美学质量)防止 reward hacking 的实践
- 训练基础设施:4 倍 MFU 提升的工程实践
- 数据异构解法——序列打包:变长多模态样本填充为定长 batch,PP 阶段间通信-计算 overlap
- 模型异构解法——灵活并行策略:编码器/解码器独立 DP/PP/TP 配置,pipeline 依赖建模为线性规划自动求解最优 stage layout,端到端加速 58.1%–69.7%
- 算子优化:自定义 CUDA kernel(LayerNorm/RMSNorm)将带宽利用率提升至 80%,前向+反向延迟降低 25.3%,相比 PyTorch 原生 5 倍加速
- 综合效果:MFU 从 baseline 的约 7% 提升至 28%
- 效果验证与总结
- 核心效果:50+ benchmark 覆盖七大模态维度的关键指标
- 当前方案的局限性与未来方向
这样的技术在实践过程中有哪些痛点?
- 模态间的"跷跷板效应":全模态联合训练中,提升一种模态的能力往往伴随另一种模态的退化。例如增加图像生成数据比例后,语音识别 WER 明显上升。目前只能通过两阶段分离训练(先感知后生成)缓解,尚无法实现所有模态的完全端到端联合优化。
- 多模态数据配比缺乏理论指导:文本数据以万亿 token 计,图像-文本对以十亿计,语音数据以万小时计,视频数据更稀缺——不同模态在数据规模、标注质量和任务难度上差异巨大。当前阶段仍依赖大量经验性调参,配比变化对各模态能力的影响难以预测,试错成本较高。
- 统一模型的推理部署复杂度:虽然激活参数仅 6.1B,但 100B 总参数需常驻显存,实际部署的内存开销远大于同等激活量的 Dense 模型。多模态输入的动态 shape 也给 KV cache 管理和 expert 调度带来额外的工程复杂度。
- 全模态评测体系的不完备:覆盖了 50+ benchmark 仍不够——现有评测主要衡量单次单任务表现,难以量化模型在真实场景中多轮、跨模态连续切换时的一致性、流畅度和交互体验。
演讲亮点
- 业界少有的真正全模态统一实践:一个模型覆盖六大模态方向的完整技术链路: 区别于业界主流方案通过外挂多个专用模块拼接能力,Ming-Flash-Omni 在单一架构内同时实现了图像理解、图像生成/编辑/分割、语音识别(含上下文感知和方言)、语音合成(含语音/音乐/音效)、视频理解、多轮跨模态对话六大能力,并且在各方向均达到或接近开源 SOTA 水平。本演讲将完整呈现从架构选型、模态融合策略到各模态能力逐一打通的全链路工程实践,包括各环节的关键技术决策和失败教训。
- 生成式分割范式——业界首个将理解-生成目标统一的方法:与主流方案(如 Janus、BAGEL 等使用独立理解/生成头或冻结 LLM 来避免干扰)不同,我们将分割重构为编辑任务,使"理解"成为"生成"的显式前提条件。这一设计从优化目标层面根治了理解-生成的表征鸿沟,使单一统一模型在图像分割上接近专用模型水平,同时在图像生成(GenEval 0.94)和编辑(GEdit-Bench 全面领先)上达到开源SOTA,是目前已知唯一同时在理解、生成、分割三项任务上均有竞争力的开源统一架构。
听众收益
- 了解全模态模型训练的挑战及解决方案:如何在单一模型中融合视觉、语音、语言的理解与生成能力,以及面临的模态统一 和任务统一 的挑战, 以及Ming系列模型的解决方案。
- 了解多模态模态和任务均衡的实践策略:文本、图像、音频、视频数据在规模上差异数个数量级,各模态任务难度 以及收敛速度差异大,了解实现模态和任务均衡的训练策略。
关注主办方(InfoQ)


联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手