随着多模态技术的快速发展,人工智能正在从单一模态向多模态演进。近年来,以GPT-... 展开 >
多模态理解与生成的突破
会议室:首府5出品人:严明
- Topic 1
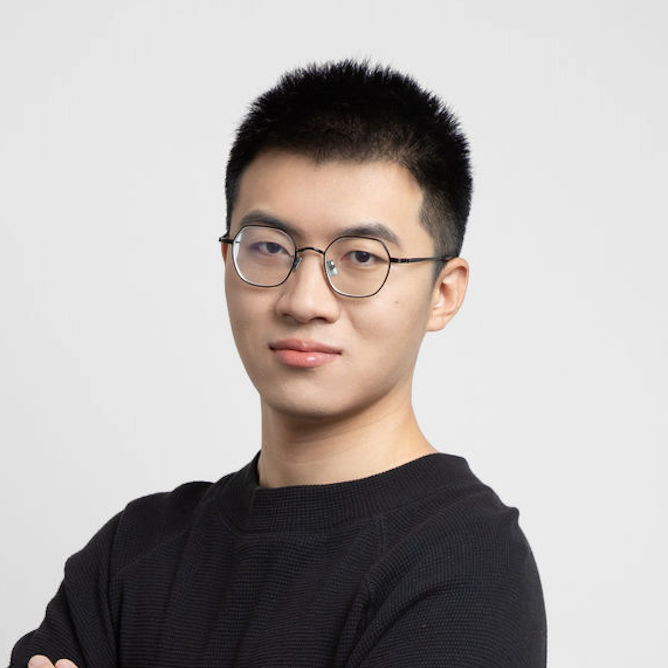
张延钊
阿里巴巴 算法工程师 - Topic 2
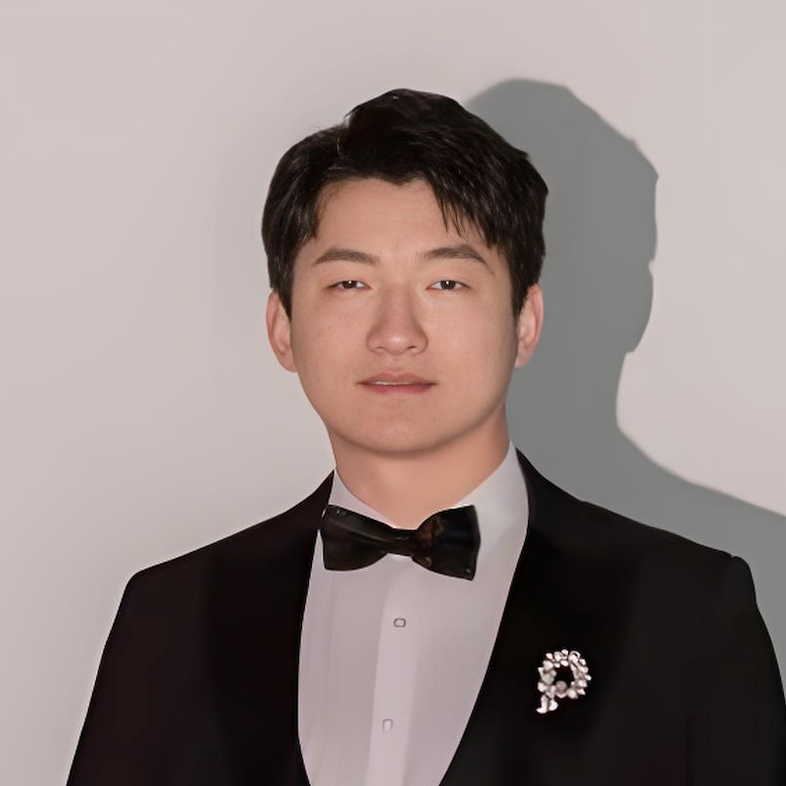
王曜明 博士
美团 Staff Engineer - Topic 3
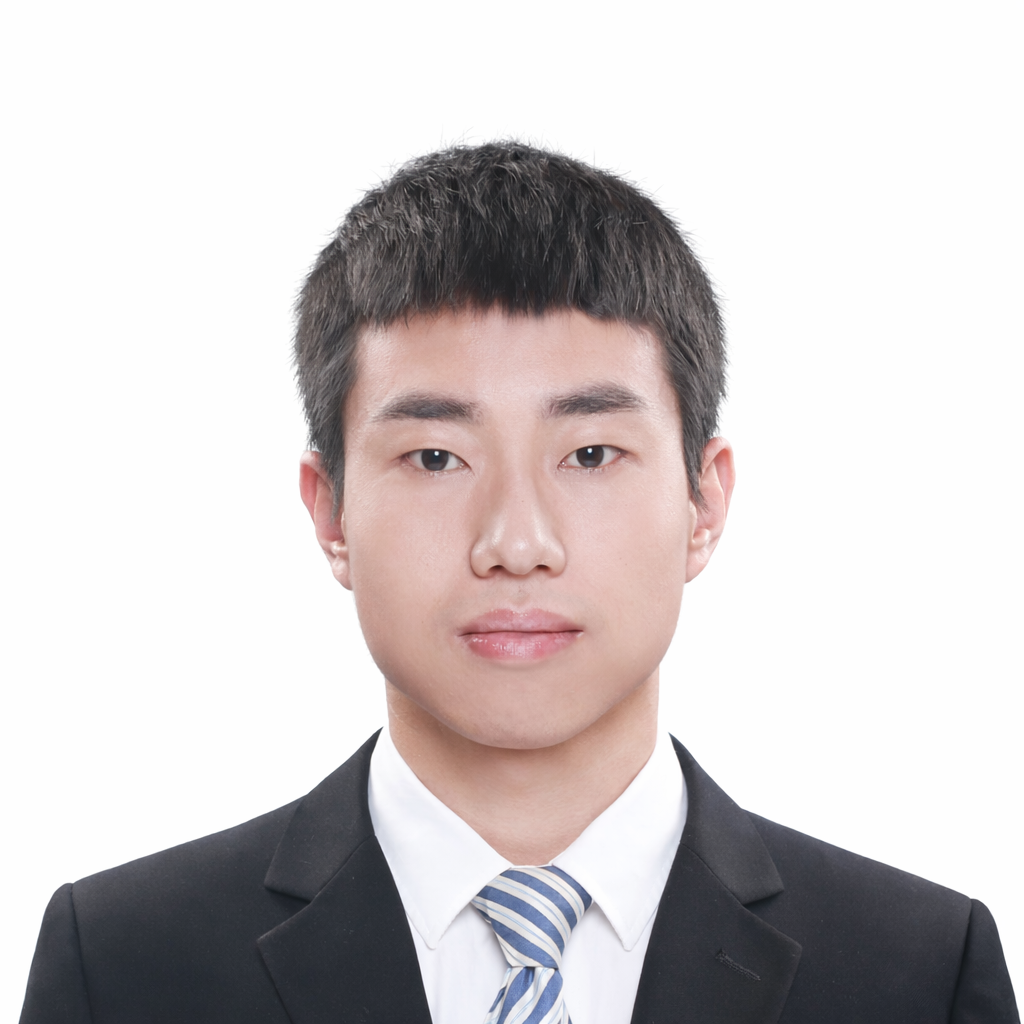
郭清沛
蚂蚁集团 高级算法专家 - Topic 4
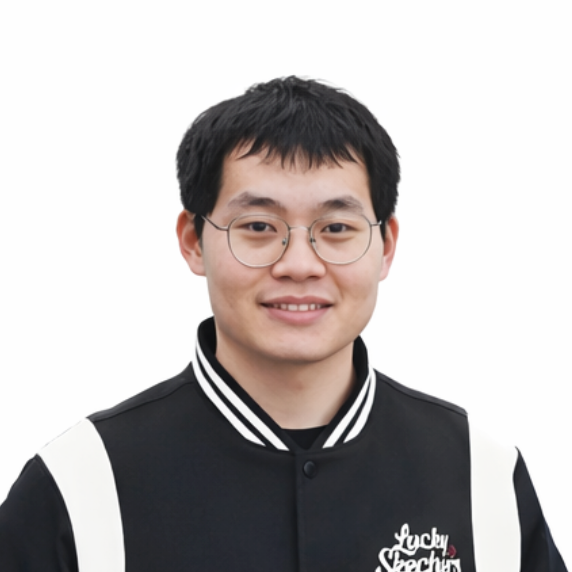
韩剑
字节跳动 算法工程师
专题出品人:严明
阿里巴巴通义实验室文档智能技术负责人
严明,通义实验室文档智能技术负责人和GUI智能体Mobile-Agent负责人,主要研究方向多模态智能体、长文本理解和推理、文档智能解析和多模态文档创作等,负责打造文档智能模型产品QwenLong、Qwen-Doc,以及文档智能解析产品Document Mind,相关能力应用于千问APP、通义智文以及内外部多个产品线,并主导Mobile-Agent开源技术体系影响力建设(7k+ Stars)和创新产品孵化,在ACL、ICML、ICLR、NeuIPS、CVPR等国际会议期刊发表100多篇相关学术论文。
地点:首府5
专题:多模态理解与生成的突破
随着多模态技术的快速发展,人工智能正在从单一模态向多模态演进。近年来,以GPT-4o、Gemini、Sora、Nano Banana等为代表的多模态理解和生成模型的突破,标志着AI能力边界的重大跨越,相关技术也逐步在搜索、分析、设计与交互体验等各个生产力场景发挥重大作用。
本专题旨在全面介绍多模态理解与生成的前沿进展,重点关注文本、图像、音视频等多模态的统一表示、跨模态推理与生成协同,以及这些能力如何重塑搜索、分析、设计与交互体验,探索多模态如何真正进入业务流程,成为生产力的一部分,为更多企业引入多模态理解与生成应用提供清晰的指引与借鉴。
我们期望通过深入分析, 重点探讨如下问题:
- 多模态理解与生成的最新技术发展趋势有哪些?
- 多模态理解与生成技术的难点与挑战,如何提升相关技术的效果和实用性?
- 在不同行业和领域,多模态理解与生成技术如何真正进入业务流程,成为生产力的一部分?
通过本专题,期望能让听众及时掌握多模态理解与生成技术的前沿动态,了解其中的难点与挑战,拓宽技术视野。从众多企业成功案例中汲取灵感,来为自身制定更具创新性与可行性的多模态理解生成应用计划。
by 张延钊
阿里巴巴
算法工程师本次演讲将围绕 Qwen-Embedding 与 Qwen-VL-Embedding 系列模型,介绍向量表示与排序模型的发展脉络、关键优化技术、训练数据构造方法及典型应用场景。内容将结合文本与多模态 Embedding、Rerank 的基础背景,重点分享 Qwen 系列模型在效果优化、使用方法和实践落地中的经验,并展望 Embedding 与 Rerank 技术未来的发展方向。
演讲提纲
- Embedding & Rerank 发展历史介绍
- 文本 Embedding 历史介绍
- 多模态 Embedding 历史介绍
- Rerank 背景知识介绍
- Qwen-Embedding & Qwen-VL-Embedding 介绍
- 对比学习优化
- 训练数据构造方法
- 模型效果介绍
- Qwen-Embedindg & Qwen-VL-Embedding 应用场景介绍
- 应用场景举例
- 使用方法说明
- 发展与展望
- Embeding、Rerank发展方向说明
这样的技术在实践过程中有哪些痛点?
- 需要使用者对模型能力有基本的了解,懂得如何在性能和效果之间进行平衡。
演讲亮点
- Qwen-VL-Embedding/Reranker是业界领先的多模态向量/排序模型,在多个榜单上效果排名第一,特别是在视觉文档场景效果优秀
听众收益
- 了解多模态向量表示与排序模型的最新进展与应用场景。
by 王曜明 博士
美团
Staff Engineer本次分享聚焦“统一多模态大模型”,探讨从“理解、生成、编辑”分立的方案转向单模型统一框架。将以自回归 Decoder-only 统一模型为主线,结合 Chameleon、Show-o、Janus、BAGEL、InternVL-U、Qwen-Image 等代表性工作,梳理统一多模态模型的主流技术路线,重点介绍美团探索的 Decoder-only 架构、各模态共享 MoE、无 ViT 结构设计、生成理解联合的多阶段训练范式、生成端 RL 策略及理解端 OPD 联合后训练等在统一理解与生成模型上的技术创新,并总结工程实践中的 FSDP2 + EP 训练范式、稀疏 MoE 与硬编码 MoE 的联合优化,以及多任务多模态数据配比等典型挑战。提出的自回归 Decoder-only 统一模型在多个基准上展现出兼顾性能与效率的优势,同时实现了交错生成与理解的交互方式,达成生成与理解的共同 SOTA。
演讲提纲
- 统一多模态大模型的演进趋势与动机
- 从分立到统一: 梳理从“理解、生成、编辑”模块化组合到“单模型原生统一”的范式转变。
- 为什么需要统一模型
- 行业主流路线梳理与代表作分析
- 离散 Token 自回归路线: 以 Chameleon、BAGEL 为代表的纯序列建模。
- 混合建模路线: 结合 AR 理解与 Diffusion/Flow 生成的方案(如 Show-o、Janus)。
- 统一 Decoder-only 架构的核心设计
- 无 ViT 结构设计
- 分模态共享 MoE 机制
- 支持交错生成与理解的交互方式
- 全链路训练范式与后训练优化
- 生成理解联合的多阶段预训练
- 差异化的后训练策略
- 工业级工程实践与典型挑战
- 训练效能优化(训练 Infra)
- MoE 的极致协同
- 数据科学与配比
- 总结与未来展望
- 当前效果
- 演进方向
这样的技术在实践过程中有哪些痛点?
统一多模态模型的核心挑战,在于不同任务之间的表示冲突与训练冲突。理解与生成共享同一模型框架,往往会带来能力相互牵制的问题;离散 token 路线虽然统一性更强,但也可能损失视觉细节与语义表达。此外,这类模型对训练 recipe 高度敏感,蒸馏设计、任务配比、分辨率策略都会直接影响最终效果。
演讲亮点
本次分享不仅梳理技术脉络,更从系统设计与工程实践的角度重新审视统一多模态模型。一方面,将系统比较 OneCAT、Janus、BAGEL、Show-o 等方法在表示、融合与生成机制上的差异;另一方面,以自回归decoder-only统一模型为案例,深入解析其架构取舍与关键优化思路,帮助听众理解统一框架背后的设计逻辑。
听众收益
- 通过本次分享,听众将获得对统一多模态大模型更清晰的整体认知,建立分析这类模型的基本框架;
- 理解当前不同技术路线在统一性、生成质量、推理效率和落地能力上的权衡;
- 掌握若干具有实践价值的方法经验,为后续论文阅读、模型复现和系统选型提供参考。
by 郭清沛
蚂蚁集团
高级算法专家构建一个同时具备视觉、语音、语言理解与生成能力的全模态统一模型,面临表征差异、模态失衡和训练效率三重挑战。我们提出 Ming-Flash-Omni,基于 100B 参数(6.1B 激活)的稀疏 MoE 架构,采用模态专属路由与双均衡机制在高稀疏度下实现多模态联合训练的稳定收敛;通过两阶段流水线(感知→生成)配合生成式分割范式,有效缓解理解-生成目标冲突;在基础设施层面,针对多模态数据和模型的双重异构性,设计了灵活并行策略与序列打包机制,将 MFU 从基线 7% 提升至 28%。最终模型覆盖图像/视频理解、图像生成与编辑、语音识别(含方言和上下文 ASR)、语音合成等六大方向,以仅100B-A6B模型参数在 50+ 公开 benchmark 上达到开源领先水平:视觉理解达到 Gemini 2.5 Pro ,图像生成 GenEval 0.94(SOTA),ContextASR 综合最优(Avg WER 3.30),方言识别领先同类模型 43%,多轮流式视频对话超越 Gemini 2.5 Pro。
演讲提纲
- 问题背景:为什么需要全模态统一模型,为什么难
- 从"模态专家拼接"到"统一全模态":技术趋势
- 三大技术挑战:表征差异(视觉连续 vs. 语音离散 vs. 文本符号)、模态失衡(不同模态数据量级和难度差异巨大)、理解-生成目标冲突(生成梯度干扰已学好的理解能力)
- 训练工程挑战:动态 batch / 变长序列导致 GPU 利用率低,编码器-解码器异构引入 pipeline bubble
- 全模态统一架构:稀疏 MoE + 模态专属路由
- 模态专属路由器设计:T-Router / V-Router / A-Router 如何让不同模态激活不同 expert 子集,避免模态间干扰
- 双均衡机制(辅助 load-balancing loss + per-router bias):解决高稀疏训练下 expert 坍缩
- 两阶段训练流水线:先 perception(三阶段预训练→两阶段指令微调→GRPO 强化学习)再 generation
- 踩坑经验:多轮跨模态交互:如何实现视觉 QA、音频描述、文档分析在单轮对话中的无缝切换
- 多模态生成:在统一模型中同时做好图像与语音生成
- 语音生成:用连续声学潜变量替代离散 token,消除量化损失;12.5Hz VAE 统一语音/音乐/环境音潜空间;方言可控生成(四川话 ACC 83.25%)
- 图像生成与编辑:生成式分割范式如何将理解能力传递给生成模块,实现身份保持、文字渲染等精细可控能力
- 视觉生成强化学习:多维奖励(真实感、指令遵循、美学质量)防止 reward hacking 的实践
- 训练基础设施:4 倍 MFU 提升的工程实践
- 数据异构解法——序列打包:变长多模态样本填充为定长 batch,PP 阶段间通信-计算 overlap
- 模型异构解法——灵活并行策略:编码器/解码器独立 DP/PP/TP 配置,pipeline 依赖建模为线性规划自动求解最优 stage layout,端到端加速 58.1%–69.7%
- 算子优化:自定义 CUDA kernel(LayerNorm/RMSNorm)将带宽利用率提升至 80%,前向+反向延迟降低 25.3%,相比 PyTorch 原生 5 倍加速
- 综合效果:MFU 从 baseline 的约 7% 提升至 28%
- 效果验证与总结
- 核心效果:50+ benchmark 覆盖七大模态维度的关键指标
- 当前方案的局限性与未来方向
这样的技术在实践过程中有哪些痛点?
- 模态间的"跷跷板效应":全模态联合训练中,提升一种模态的能力往往伴随另一种模态的退化。例如增加图像生成数据比例后,语音识别 WER 明显上升。目前只能通过两阶段分离训练(先感知后生成)缓解,尚无法实现所有模态的完全端到端联合优化。
- 多模态数据配比缺乏理论指导:文本数据以万亿 token 计,图像-文本对以十亿计,语音数据以万小时计,视频数据更稀缺——不同模态在数据规模、标注质量和任务难度上差异巨大。当前阶段仍依赖大量经验性调参,配比变化对各模态能力的影响难以预测,试错成本较高。
- 统一模型的推理部署复杂度:虽然激活参数仅 6.1B,但 100B 总参数需常驻显存,实际部署的内存开销远大于同等激活量的 Dense 模型。多模态输入的动态 shape 也给 KV cache 管理和 expert 调度带来额外的工程复杂度。
- 全模态评测体系的不完备:覆盖了 50+ benchmark 仍不够——现有评测主要衡量单次单任务表现,难以量化模型在真实场景中多轮、跨模态连续切换时的一致性、流畅度和交互体验。
演讲亮点
- 业界少有的真正全模态统一实践:一个模型覆盖六大模态方向的完整技术链路: 区别于业界主流方案通过外挂多个专用模块拼接能力,Ming-Flash-Omni 在单一架构内同时实现了图像理解、图像生成/编辑/分割、语音识别(含上下文感知和方言)、语音合成(含语音/音乐/音效)、视频理解、多轮跨模态对话六大能力,并且在各方向均达到或接近开源 SOTA 水平。本演讲将完整呈现从架构选型、模态融合策略到各模态能力逐一打通的全链路工程实践,包括各环节的关键技术决策和失败教训。
- 生成式分割范式——业界首个将理解-生成目标统一的方法:与主流方案(如 Janus、BAGEL 等使用独立理解/生成头或冻结 LLM 来避免干扰)不同,我们将分割重构为编辑任务,使"理解"成为"生成"的显式前提条件。这一设计从优化目标层面根治了理解-生成的表征鸿沟,使单一统一模型在图像分割上接近专用模型水平,同时在图像生成(GenEval 0.94)和编辑(GEdit-Bench 全面领先)上达到开源SOTA,是目前已知唯一同时在理解、生成、分割三项任务上均有竞争力的开源统一架构。
听众收益
- 了解全模态模型训练的挑战及解决方案:如何在单一模型中融合视觉、语音、语言的理解与生成能力,以及面临的模态统一 和任务统一 的挑战, 以及Ming系列模型的解决方案。
- 了解多模态模态和任务均衡的实践策略:文本、图像、音频、视频数据在规模上差异数个数量级,各模态任务难度 以及收敛速度差异大,了解实现模态和任务均衡的训练策略。
by 韩剑
字节跳动
算法工程师目前视觉生成以扩散模型为主,我们探索了一条不同的自回归视觉生成的路线。本次演讲中,我们将以过去一年我们发表的顶会论文为基础,介绍我们在自回归视觉生成领域中的一些前沿技术探索,希望给大家科普自回归做视觉生成的方法细节、优劣势、未来发展方向。
演讲提纲
- 概览:自回归 vs. 扩散模型
- 自回归文生图:Infinity
- 背景
- 方法架构:Bitwise Modeling
- 实验结果
- 自回归文生视频:InfinityStar
- 背景
- 方法架构:Spacetime Autoregressive
- 实验结果
- 下一代自回归视觉生成模型
- 背景
- 方法架构
- 实验结果
- 总结
这样的技术在实践过程中有哪些痛点?
- 在效果上,距离 top-tier 的闭源扩散模型仍有一定差距。
听众收益
- 自回归怎么做图像/视频生成;
- 自回归生成的优势和劣势。
关注主办方(InfoQ)
联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手