多模态大模型技术迅猛发展,以视觉-语言大模型(VLA/VA)为代表的离身智能已实... 展开 >
具身智能与物理世界交互
会议室:富力3+5出品人:隋伟 博士
- Topic 1
何泳澔 博士
地瓜机器人 具身智能负责人 - Topic 2
李元庆
乐享科技 创新业务合伙人 - Topic 3
王舒捷
小雨机器人 合伙人 - Topic 4
彭君然 博士
北京科技大学 副教授
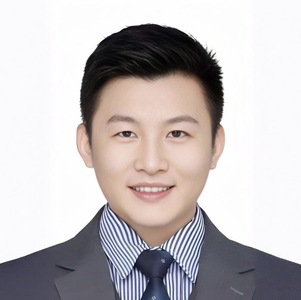
专题出品人:隋伟 博士
地瓜机器人算法副总裁
2011 年,他于北京航空航天大学探测制导与控制技术专业毕业,之后进入中科院自动化研究所深造,并取得博士学位,其研究方向为模式识别与智能系统。
2016 年 7 月博士毕业后,担任模式识别国家重点实验室助理研究员,负责 3D 视觉感知方向的研发工作。
2019 年 1 月隋伟博士加入地平线,任高级算法工程师,主要负责机器人和自动驾驶场景下,基于旭日和征程系列芯片的 2.5D 及 3D 视觉算法研发。2020 年 12 月- 2023 年 12 月,任研发总监,带领团队(30人)成功开发了地平线高阶自动驾驶 BEV 感知方案,并且搭建了国内首套最为完备且先进的 4D Label 标注系统。目前旭日系列芯片出货量已达数百万片,BEV 感知方案也已在多个车型上定点量产,为自动驾驶领域的发展做出了重要贡献。隋伟博士在 ICRA、IROS、CVPR、TIP、TVCG 等国内外知名期刊和会议上先后发表学术论文 20 余篇,拥有专利 40 多项。此外,他长期担任 ICRA、IROS 等机器人会议的审稿人,同时担任《智能驾驶和机器视觉》《智能驾驶与多维重建》等自动驾驶相关著作的主编。
2023 年 11 月至今任地瓜机器人算法 VP ,负责面向消费机器人和具身智能的软件算法方案研发。
地点:富力3+5
专题:具身智能与物理世界交互
多模态大模型技术迅猛发展,以视觉-语言大模型(VLA/VA)为代表的离身智能已实现初步通用化与泛化能力,在数字领域构建起成熟应用基础。具身智能作为AI从数字世界迈向物理现实的核心跃迁,成为通往通用人工智能(AGI)的关键路径,却受限于模型泛化性、数据采集与闭环等难题,技术落地受阻。本专题聚焦 VLA/VA 模型与数据体系两大核心,深度拆解具身智能技术链路。拟探讨模型现状、核心挑战与机会,分享高质量数据解决方案,解析仿真与 World Model 的赋能价值,破解核心技术瓶颈。旨在搭建顶尖交流平台,助力从业者与研究者明晰方向,加速具身智能技术研发转化与产业规模化落地。
专题受众
本专题精准覆盖具身智能领域全产业链从业者与研究者,具体包括:
- 具身智能行业工程师(软硬件):聚焦模型设计、数据闭环搭建及硬件优化,推动技术从实验室规模化落地。
- 具身智能相关研究者:聚焦核心技术瓶颈,探索突破性研究方向,促进学术与产业融合。
- 产品经理与决策者:依托技术现状布局,平衡需求与可行性,把握产业机会制定发展策略。
by 何泳澔 博士
地瓜机器人
具身智能负责人在工业领域,机器人主要依靠示教编程执行高重复性、低复杂度的任务。然而,随着全球制造业向“柔性化”和“高度自动化”转型,企业面临着更多非结构化环境下的精密操作需求。
具身智能经历了3年的发展,2026 到了比拼落地的深水区,我们需要用一个务实且有前瞻性的思考指引未来的方案设计。当前的痛点在于:传统方案难以应对多变的操作目标,而全栈的大模型(VLA)在工业环境的低延迟和高精度要求下仍显沉重。本次演讲我将聚焦于如何通过 VA (Vision-Action) 架构,结合传统自动化与现代深度学习,构建一套可落地的工业级机器人操控方案。
演讲提纲
1. 工业操控问题的分类和定义
- 操作任务的多维度拆解
- 基于操作精细度的任务划分(如:微米级装配 vs. 公分级码垛)
- 基于空间复杂度的建模(如:6自由度约束、动态避障需求)
- 典型工业场景案例
- 从物料分拣到精密组装的场景特征分析。
- 技术路线思辨:VA vs. VLA
- 不同视角的对比:为何语言模型(L)在某些闭环工业任务中并非必需
- 为什么 VA (Vision-Action) 更适配泛工业场景的效率与稳定性要求
- 注意力放在 VA 上,那么潜台词就是,我们并没有在考虑通用性
- 问题的定义
- 探讨如何将复杂的物理交互逻辑收敛为端到端的 VA 模型
2. 硬件架构选型:从本体到末端执行器
- 机器人本体配置:上半身与下半身(移动底座)的协同能力选型
- 末端执行器(End-effector):针对特定任务的夹具、灵巧手与力控传感器匹配
- 选型基本原则:可靠性、响应频率、载荷比以及与算法框架的兼容性
3. 算法方案深度解析:传统与 AI 的融合
- 核心理念:传统自动化与新一代数据驱动方法的有机结合
- 模块化策略:利用数据驱动的深度学习解决通用性最强、模型难以建立的环节
- 主流 VA 方法论介绍
4. 高质量数据闭环:方案落地的基石
- 高质量遥操作(Teleoperation):如何通过人工示教获取具有“专家级轨迹”的原始数据
- 轨迹数据“标准化”处理:通过标准化流程提升数据质量,降低模型训练震荡
- 仿真数据(Sim-to-Real)的价值:利用物理引擎大规模合成数据,解决长尾场景缺失问题
- 技术实践中的痛点分析
您认为,这样的技术在实践过程中有哪些痛点?
- 硬件适配场景,以及硬件本身的工业可用性
- 传统自动化与新方法的融合
- 数据方案如何兼顾质量和效率
演讲亮点
- 去伪存真:不盲目推崇 VLA 大模型,而是理性分析 VA 在工业效率上的优势,具有极强的落地参考价值
- 全栈视野:从硬件选型的物理基础到数据预处理的细节技巧,提供了可行的实施路径
- 数据质量观:提出了轨迹数据“归一化”的概念,抓住了当前具身智能训练中“数据质量优于数量”的关键
听众收益
- 方法指引:掌握一套从问题定义到硬件选型、再到算法调优的工业机器人方案闭环
- 避坑指南:通过对痛点的剖析,听众可以提前规避在传感器选型及数据采集中的常见陷阱
- 行业前瞻:理解为何在当前的工业环境下,VA 架构是平衡通用性与工业级可靠性的最优解
by 李元庆
乐享科技
创新业务合伙人本专题围绕 “具身智能与物理世界交互” 核心方向,聚焦智能 Agent 如何衔接视觉 - 语言大模型(VLA/VA)与真实物理场景。在多模态大模型具备强泛化能力的基础上,探讨具身 Agent 如何实现感知、决策、规划与执行的全闭环,打通从数字智能到物理交互的关键链路。内容将解析模型泛化、数据体系、仿真与世界模型等核心瓶颈,分享面向真实场景的 Agent 架构设计与高质量数据方案,为具身智能技术突破、产品化落地与产业规模化提供清晰路径与实战思路。
演讲提纲
1. 背景:多模态大模型(VLA/VA)的离身智能成果与局限
- 核心点切入:具身智能落地的核心瓶颈(模型泛化、数据闭环、物理交互),具身 Agent 是破解瓶颈、衔接 VLA/VA 与物理世界的核心载体
- 核心认知:具身智能 Agent 的定位与价值
- 定义解析:具身智能 Agent 与离身智能(VLA/VA)的区别与关联——以“感知-决策-规划-执行”全闭环,实现物理世界交互
- 核心价值:为什么 Agent 是具身智能落地的关键?(衔接 VLA/VA泛化能力、适配物理场景不确定性、实现自主交互与闭环优化)
- 应用锚点:结合专题方向,聚焦Agent在物理交互场景中的核心作用(打破数字与物理壁垒,推动技术从实验室走向产业
2. 技术拆解:具身 Agent 的核心技术链路
- 基础支撑:VLA/VA 模型如何赋能具身 Agent(视觉-语言理解、多模态交互能力迁移,解决“能看懂、能听懂”的问题)
- 核心架构:具身 Agent 的全链路设计(感知层:多模态融合感知;决策层:基于 World Model 的意图预判与规划;执行层:物理交互落地;反馈层:数据闭环优化)
3. 关键瓶颈与突破路径
- 模型泛化性——如何让 Agent 适配复杂、多变的物理场景(避免“实验室好用、现场失效”)
- 数据体系——高质量物理交互数据的采集、标注与复用方案(破解数据稀缺、标注成本高的难题)
- 仿真与 World Model 赋能——如何通过仿真训练提升 Agent 的物理交互能力,降低真实场景落地成本
4. 实践分享:具身 Agent 落地案例与经验
- 典型案例:聚焦物理交互场景,分享具身 Agent 的落地实践(模型选型、数据方案、仿真应用、交互优化)
- 实践痛点:落地过程中遇到的 Agent 设计、数据闭环、物理适配等实际问题及解决思路
- 可复用经验:面向从业者、研究者,提供具身 Agent 研发与落地的核心方法论
5. 未来展望与互动交流
- 未来方向:具身 Agent 的技术迭代重点(更优泛化性、更高效数据闭环、更自然的物理交互)
- 产业价值:Agent 推动具身智能规模化落地的路径,以及对通用人工智能(AGI)的支撑作用
- 互动答疑:针对技术瓶颈、落地实践等问题,与现场听众交流探讨
您认为,这样的技术在实践过程中有哪些痛点?
- 大模型很强,但落到物理世界完全不好用
- 数据极度稀缺,且无法像互联网一样快速积累
- 世界模型(World Model)好听不好做
- 多智能体协同、长期记忆几乎没有成熟方案
演讲亮点
- 不空谈大模型能力,聚焦 “从 VLA/VA 到物理动作” 的可工程化 Agent 架构
- 提出面向真实场景的轻量化 World Model 与数据闭环方案
听众收益
- 掌握从 VLA/VA 多模态大模型到具身智能 Agent 的真实落地链路
- 获得解决具身智能三大痛点的实战方案:泛化性、数据闭环、物理鲁棒性
- 建立面向 AGI 方向的具身智能顶层认知与技术判断框架
by 王舒捷
小雨机器人
合伙人具身智能在高价值工业场景落地,核心挑战在于处理人、机、料、法、环带来的系统性复杂度。单点作业速度的提升往往难以转化为全链路的提效,必须综合考量节拍对齐与运维成本。
本次分享我将介绍我们在工业具身场景的落地实践,探讨长上下文理解与推理速度的工程平衡策略,分享在现场落地过程中遇到的现场硬件失效、传感器干扰等问题。目前,在特定高价值场景下,具身系统的综合成本已趋近人力成本临界点,结合高技能工人缺口现状,为规模化落地提供了支撑。
演讲提纲
1. 真实场景落地逻辑:算法之外的工程考量
- 人、机、料、法、环对算法、硬件设计提出要求
- 全链路效率:成本与产出比
- 实际落地中的隐形成本
2. VA 路线在垂直行业的落地
- 解决 VA 模型在 3D 空间中的绝对尺度预测问题
- 在垂直领域样本稀缺的情况下,如何构建有效的数据获取闭环
3. 现场实际案例
- 硬件和传感器稳定性带来的挑战
4. 高价值场景的具身落地机会
- 高技能工人的供需失衡
- 机器人成本与人力成本趋近零界点
您认为,这样的技术在实践过程中有哪些痛点?
- 模型端上部署对算力要求高
- 工业复杂场景环境结构复杂,为了避免碰撞需要大量仿真 & 真机强化
演讲亮点
- 基于带尺度大规模仿真数据 + 工业真实数据的预训练
听众收益
- 掌握在垂直领域数据稀缺的背景下,如何构建有效的数据闭环并降低模型在不同机器人硬件上的适配成本
- 获取针对真实工业环境(如极端温差、传感器冷凝、粉尘干扰)导致的系统失效应对
by 彭君然 博士
北京科技大学
副教授空间智能旨在让机器理解、生成与利用三维空间中的结构、物体与物理属性,是数字孪生、具身智能与自动驾驶等应用的基础。若仅依赖人工建模或单一数据源,难以在规模与真实性上同时满足“可仿真、可交互”的需求。我们期望实现的完备空间智能,应包含对空间结构、物体、关系及物理属性(几何、材质等)的完整刻画与利用方式。空间智能与 3D/4D 世界模型一脉相承,其在内容创作、智驾仿真与具身智能等方面具有广阔前景;我们围绕完备空间智能应包含的信息与利用方式,从生成与重建两条路径进行了探索:生成方法面向大规模、大尺度的泛化以及场景数量级的扩充,通过程序化内容生成(PCG)与 Agent 从语义/图像出发批量搭建场景;重建方法则面向对现实世界的精细复刻,将真实场景抽象为具备几何与材质物理属性的数字孪生。两条路线应对的应用场景不同,但都旨在得到完备的空间智能数据表现形式,为仿真与决策提供可靠环境。本次演讲将围绕“什么是空间智能、如何构建、完备空间智能应包含哪些知识与信息利用方式”展开,重点分享在生成与重建两条路径上的技术选型、代表性工作与实践中的经验与局限。
演讲提纲
1. 空间智能:定义、目标与两条技术路线
- 空间智能的内涵:空间结构、物体、关系与物理属性(几何、材质)的理解与利用
- 完备空间智能应包含的知识与信息利用方式(几何、材质、功能、操作、关系等)
- 为何需要两条路径:生成满足“规模与多样性”,重建满足“真实世界一致性”
- 总体框架:生成方法(PCG + Agent) vs 重建方法(几何 + 材质)
2. 生成方法:从语义/图像到可交互场景
- 要解决的问题:如何从高层语义(文字/参考图)批量化、多样化地搭建室内外场景
- 解决思路:以功能性物体与结构的摆放逻辑为核心,用 PCG 生成多层级建筑与室内外结构
- 代表工作与管线:
- SceneX / CityX:基于 PCG 的室内外多层级场景生成与搭建逻辑
- MarketGen:首个可扩展的具身超市场景仿真平台;Agent + PCG 管线,从文字或参考图生成高保真复杂超市场景
- 信息利用方式:从自然语言或二维图片提取物体属性、物体间关系及操作方式,体现“从生成角度构造空间智能”的一种方式
3. 重建方法:从真实世界到可仿真的数字孪生
- 要解决的问题:如何把真实场景抽象为具备正确几何与材质物理属性的数字孪生,以支持碰撞、摩擦、光照等仿真与交互
- 解决思路:分拆为表面材质与几何结构两条子线,再在场景级融合
- 材质属性刻画:
- 需求:摩擦力、光反射率等交互属性,决定仿真中的交互反馈
- MaterialSeg3D:单物体表面材质;12 个实例类别、30+ 材质类别数据集;为文生3D/图生3D 资产提供表面材质预测,保证仿真交互真实性
- SceneMaterial:城市场景下路面与建筑表面材质生成,支撑智驾仿真等大型城市场景
- 几何结构重建:
- 需求:正确碰撞体与平面拓扑,以支持放置、拖拽、平移等平面交互。
- GSPlane:基于高斯溅射 + 二维平面先验,重建室内外大小平面结构及绝对平滑的平面拓扑;可将承载平面(桌面、地面)上的物体拆分为独立个体,在仿真中可移动与交互
- 与现有方法对比:稠密三角网格易产生错误平面拓扑,无法支持仿真中的放置与拖拽;GSPlane 的平面拓扑可直接支持上述交互
4. 实践过程与经验未来发展前景
- 生成侧:数据与逻辑(物体摆放、功能约束)的平衡;Agent + PCG 管线的可扩展性与控制粒度
- 重建侧:结构化几何的获取;正确拓扑对仿真交互的关键作用;从单物体到城市场景的泛化
5. 未来发展前景
- 共同经验:生成与重建在未来会融合(如用生成补全重建缺失、用重建约束生成真实性)
- 生成与重建的融合、多模态(文字/图像/点云)统一建模、与具身智能/智驾仿真的深度结合
- 4D 世界模型是空间智能的演进形态,在内容创作、智驾仿真与具身智能中潜力巨大。NeoVerse 直接利用海量单目视频进行大规模训练,通过重建-生成混合与免姿态前馈 4D 重建,推动 4D 空间智能从实验室走向数据驱动,成为通用 4D 世界模型底座
您认为,这样的技术在实践过程中有哪些痛点?
- 生成场景的物理与几何一致性如何与下游仿真(碰撞、材质)对齐
- 重建中平面拓扑与物体分割的自动化与鲁棒性(复杂遮挡、弱纹理)
- 材质与几何数据的标注成本与跨场景泛化(如从室内到城市场景)
- 大规模城市场景的生成/重建效率与存储、渲染、仿真的工程化
演讲亮点
- 双路线框架:不局限于单一技术路线,从生成与重建两条路径系统阐述空间智能的构建方式,为“何时用生成、何时用重建”提供清晰的选型依据
- 问题驱动叙事:围绕问题—解决思路—实践过程—经验教训组织内容,避免技术平铺,突出可落地的技术决策与权衡逻辑
- 技术深挖:选取平面拓扑与仿真交互、材质物理属性等 1–2 个关键点深入剖析,揭示“可仿真、可交互”背后的几何与物理约束,具有直接落地参考价值
- 演进视野:从 3D 到 4D 世界模型的技术脉络切入,结合 NeoVerse 等前沿工作,点明空间智能从静态到动态、从实验室到大规模数据驱动的演进方向
听众收益
- 方法指引:掌握从空间智能定义、到生成/重建双路线选型、再到代表性工作的完整技术视野与实施思路
- 避坑指南:通过对几何拓扑与材质物理属性的剖析,理解为何错误平面拓扑会导致仿真中无法支持放置与拖拽,提前规避“只重外观、忽视交互属性”的常见陷阱
- 行业前瞻:理解在数字孪生与具身/智驾仿真场景下,生成与重建的分工与融合;把握从 3D 到 4D 世界模型的演进趋势,形成对完备空间智能及其数据表现形式的整体认知
关注主办方(InfoQ)
联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手