卡奥斯工业智能首席科学家,东京大学博士,深耕工业视觉、数字孪生与具身智能,以第一/通讯作者发表顶会顶刊 29 篇、第一发明人授权专利 29 项,曾获日本机器人大奖、泰山产业领军人才。
讲师介绍
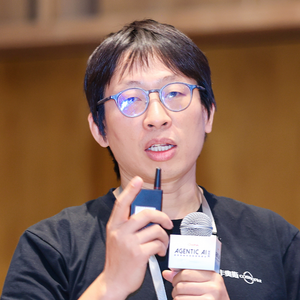
专题演讲嘉宾:余锦泽 博士
卡奥斯 COSMOPlat工业智能首席科学家
议题介绍
演讲:Agent 的记忆不在对话里:把企业数仓沉淀为可治理的共享语义记忆
Agent 记忆的业界主线是对话与个性化:主流框架记住”用户说过什么”。但工业多智能体更缺的记忆是”这家企业的数据语义”——指标的分子分母、同一工单号在不同表里的多种写法——它们不在对话流里,在数仓、代码与文档里;而且写错的记忆比遗忘更危险:我们实测只注入一半语义,正确率反而低于不注入。
本次演讲分享把企业数仓沉淀为多智能体共享语义记忆的工程路径:写入侧大模型只提议、真实数据裁决、证据分级入库;冲突用时间轴校验、双源融合与对抗评审消解;使用侧按对象锚定动态构建上下文;教训沉淀为可插拔提示词组件与回归断言。结论:企业语义记忆是需要治理的资产——写入有裁决、冲突有消解、经验能沉淀、错误可撤销。
演讲提纲
一、为什么业界记忆框架搬不进工厂
- 记忆热潮的主线:Mem0、Zep(时序知识图谱)、Letta/MemGPT 等框架解决的是”跨会话记住用户”——记忆主要来自对话与交互流
- 工业 Agent 的记忆缺口:要记的不是”用户偏好”,而是”直通率的分子分母是什么、工单号在不同表里有几种写法”——这些语义不产生于对话,藏在数仓表结构、建表代码与工艺文档里,且没有外键、命名晦涩
- 写错比不记更危险:学界正在讨论记忆污染(memory contamination),企业场景的代价是口径错账——我们的实测:只注入实体与关系、不带指标口径,回答正确率反而低于完全不注入,模型会更自信地选错表
- 本场主张:企业语义记忆是资产,要治理——写入有裁决、冲突有消解、经验能沉淀、错误可撤销
二、记忆从哪来:语义记忆的受治理写入
- 记忆的结构与置信分层:对象、关系、事件、指标、动作、场景六要素;每条记忆带证据等级——数据验证(verified)、人工断言(asserted)、缺口(gap)——类比业界情景记忆/语义记忆分层,区别在于置信等级由真实数据裁决产生,不由模型自评
- 写入把关:大模型只提议、真实数据裁决——取值重叠度须过阈值、子键不唯一、父键接近唯一、列名有据可依,四道判据缺一不可;通不过的降为候选,不入正式记忆
- 踩坑之一:时序假象。同一对字段在单日窗口下取值完全重合,看上去就是一条真关系,窗口拉长到一个月即崩塌——采样窗口不足一律不予写入
- 冲突消解三招:时间轴校验(排除巧合性重合)、双源融合(代码中的 JOIN 证据优先于命名推断)、对抗评审(独立评审多数否决即打回重抽)
- 踩坑之二:人工断言冒充数据验证。早期实现允许把人工确认写成 verified,记忆置信被悄悄稀释;现在这条纪律写进接口签名——人审只产生”断言”,verified 只能由数据裁决产生
- 与业界方案的分工:时序知识图谱记忆(如 Zep 的双时序边)回答”事实何时有效”;我们在企业库场景回答”这条记忆该不该写入”——记忆生命周期的两端,可互补
三、记忆怎么用:共享、调度与动态上下文构建
- 共享语义记忆:多个智能体读写同一套语义,“工单”在所有 Agent 中是同一个”工单”;写权限唯一收口——大模型唯一的写路径是把自然语言翻译成带类型的受治理操作,预览、人审后落盘,全程可回滚
- 记忆调度即上下文构建:按问句锚定对象→沿已验证关系召回子图→挂指标口径与术语,成套注入;只注入锚定命中的子图而非全图,兼顾上下文长度与成本
- 踩坑之三,存而不用:数百条中英术语词典建成后,检索链路曾长期没有消费它——由此提出”消费方审计”:每新增一类记忆,必须答得出”它的消费方在哪”
- 用记忆做指代消解(本体即实体注册表):多轮对话中的指代(“它/该产线”)显式回填上文命中的对象,不引入通用 NLP 组件;中文表名后缀剥离——“销售订单事实表”须按”销售订单”命中
- 答案的可追溯与拒答规范:答案同屏给出指标口径卡(计算口径、出处表列、血缘入口);实体未在记忆中命中即明确拒答,不做无锚定的自由生成
四、记忆怎么长:经验沉淀与持续学习闭环
- 程序性记忆的沉淀:把建模教训做成可插拔的提示词组件注入构建流程——对比实验:注入”建模规范”组件后,对象与关系候选大幅收敛、已验证占比明显上升、关系动
- 词全部落入白名单,“经验轨迹→Skill”有可对照的产物证据
- 教训固化为代码而非文档:踩过的坑各有归宿——时序假象固化为采样窗口判据、断言冒充固化为接口签名、存而不用固化为消费方审计清单、跨引擎模型名错配固化为运行时模型族校验、数据对不上账固化为分层对账检查项
- 证据回流:用户反馈→评审队列→记忆修订→下游即时生效(评审否决一条关系,引用它的查询立即被拦截);版本快照与一键撤销保证记忆修订可逆
- 持续学习的度量:自建金标评测集(Spider、BIRD 等公开基准覆盖不了企业口径与脏数据),金标先在库上实跑校准;评测暴露的”记忆的病”往往是数据的病——汇总层与明细层对不上账,处置是把分层对账固化为数据质量检查项
五、边界与取舍
- 写入把关的覆盖率代价:宁缺勿滥会把部分真知识挡在正式记忆之外——我们选择”缺口透明”而非”虚假完整”
- 前置条件:指标口径要有人拍板,这是管理问题不是技术问题
- 什么时候不需要:单表能答、口径唯一的场景,一条 SQL 就够
- 收束:记忆不是缓存,是需要治理的资产——写入有裁决、冲突有消解、经验能沉淀、错误可撤销
实践痛点
- 写入把关的覆盖率与准确性之争:数据裁决宁缺勿滥,代价是把一部分真实存在但证据不足的关系挡在正式记忆之外,覆盖率承压;我们选择把它们透明地放进候选与缺口清单,而不是降低门槛换虚假完整——但这意味着冷启动阶段记忆覆盖有限
- 共享记忆的写治理成本:多智能体共享一套语义,写权限必须唯一收口、高风险改动必须人审,换来一致性与可追责,代价是写入吞吐受限,不适合高频自动写入的场景
- 遗忘与审计的张力:错误记忆要能撤销,但审计要求留痕——我们采用”降级候选+版本快照”而非物理删除,存储与检索都要为历史版本付成本
- 判据阈值是工程经验值:取值重叠度、父键唯一性等判据的阈值来自实践调优而非理论最优,跨行业迁移时需要重新标定,且每条判定都要留下依据供复核
- 评测的外部效度:自建合成基准可复现、金标可校准,但规模有限,不等于真实客户库表现;真实库评测涉及数据授权,只能分阶段推进
演讲亮点
- 记忆来源与写入裁决方式不同:主流记忆框架(Mem0、Zep、Letta 等)主要从对话与交互流萃取记忆,写入由模型判断;我们从数仓表结构、建表代码与文档萃取企业语义记忆,每条记忆写入前由真实数据裁决(取值重叠、父键唯一性、时间轴校验),“该不该记”有可复核的证据,不靠模型自评。
- 对记忆污染给出工业可用的工程防线:证据三级分层+写入把关+“人工断言永不冒充数据验证”(写进接口签名而非规章),并配套消费方审计与可逆修订——对应学界记忆污染议题,给出一套在企业场景跑通的完整防线。
- “经验轨迹沉淀为 Skill”有产物级证据:把建模教训组件化为可插拔提示词组件,用同目标对比实验展示注入前后产物的可见差异(候选收敛、已验证占比上升、动词全部落入白名单)——程序性记忆的沉淀不停留在概念,可逐条对照验收。
听众收益
- 一套企业语义记忆的组织方法:六要素结构、证据三级置信、“数据裁决产生置信”的写入设计,可直接套用到自家数据 Agent
- 冲突消解三招:时间轴校验、双源融合(代码证据优先于命名推断)、对抗评审——每招都配真实踩坑案例
- 记忆调度的上下文构建方法:对象锚定、子图注入、指代回填、消费方审计清单
- 程序性记忆沉淀的可操作路径:教训如何组件化、如何写进接口与回归断言、如何用对比实验验收沉淀效果
- 一份边界清单:写入把关的覆盖率代价、共享记忆的写治理成本、遗忘与审计的取舍,以及”什么时候不需要这套记忆”
关注主办方(InfoQ)


联系我们
交通指南
上海建工浦江皇冠假日酒店
Shanghai Construction Group Pujiang Crowne Plaza Hotel
地址:上海市闵行区陈行公路 3701 号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手