不管对已经应用于搜广推多年的机器学习,CV 领域的深度学习,还是近一年火热的 L... 展开 >
面向 AI 的存储
会议室:富力 3+5出品人:苏锐
- Topic 1
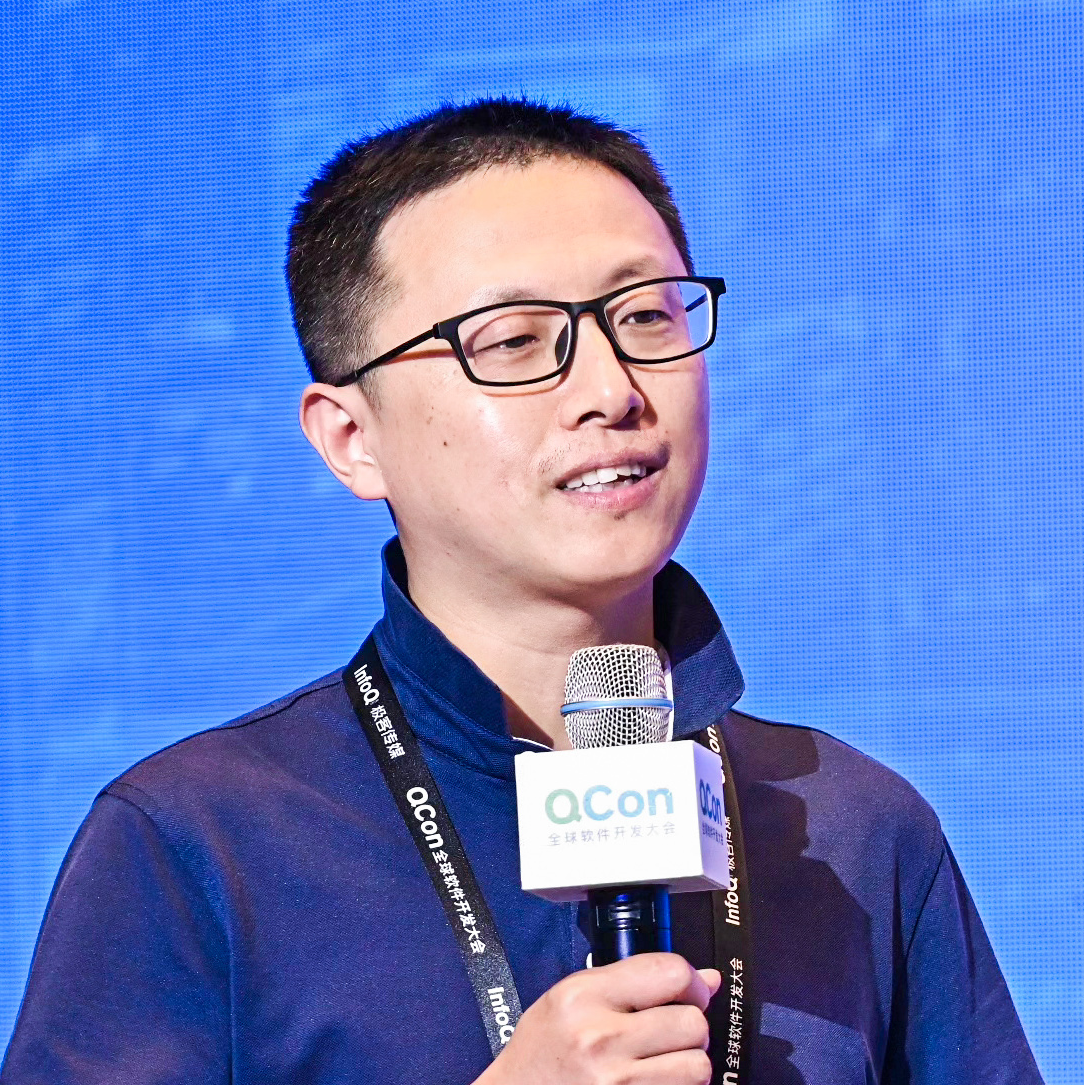
罗庆超
阿里云 资深技术专家 - Topic 2
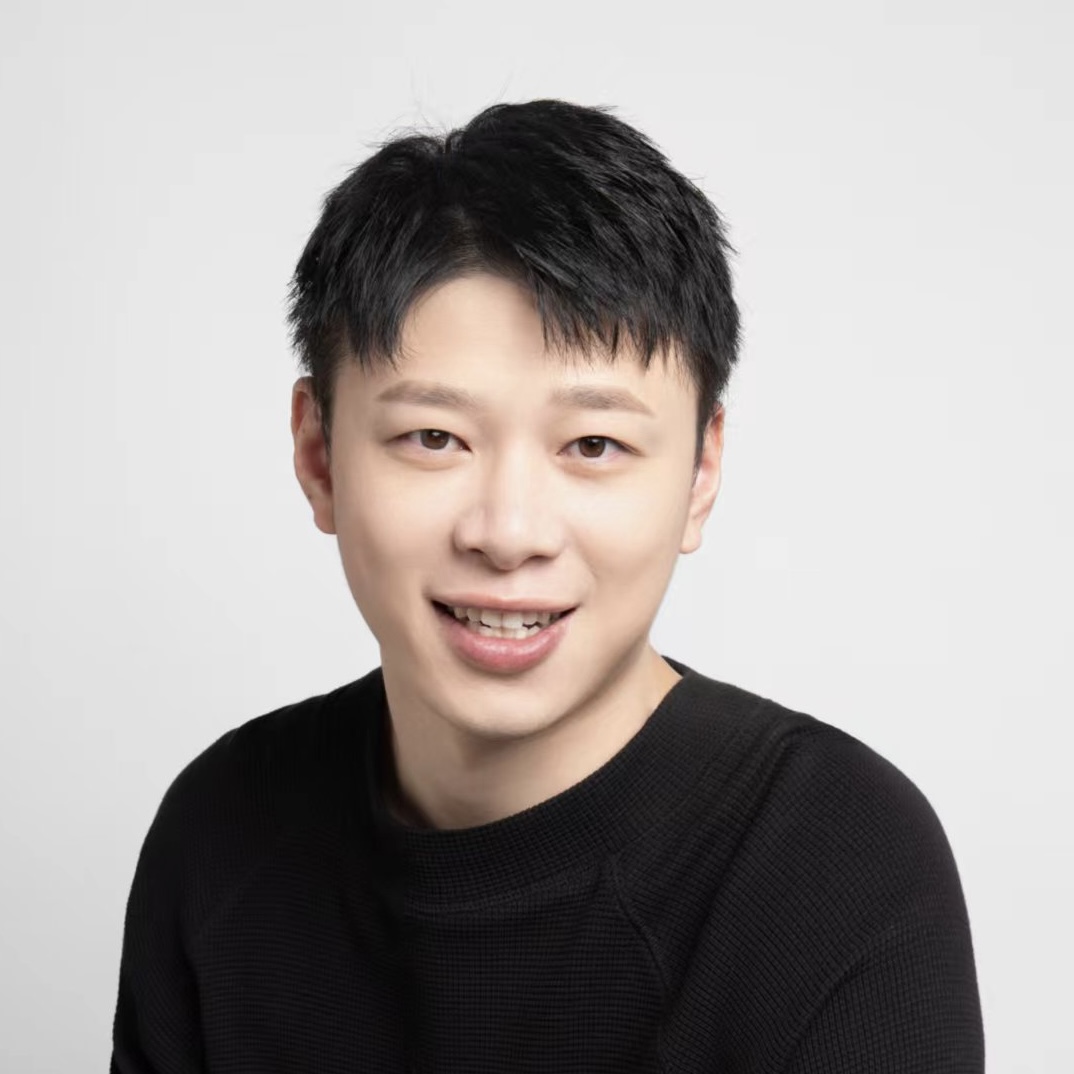
陈静力
网易 资深系统开发工程师 - Topic 3
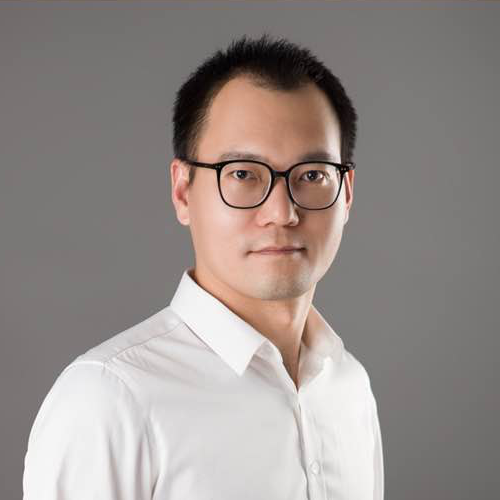
张文涛
焱融科技 CTO - Topic 4
彭毅格
vivo AI 研究院计算平台组资深工程师
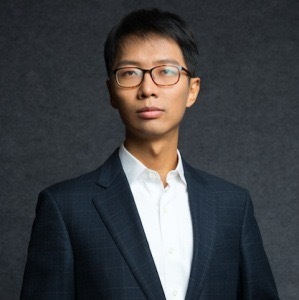
专题出品人:苏锐
Juicedata 合伙人
苏锐,Juicedata 合伙人,2017 年开始作为创始成员参与 JuiceFS 产品、市场、开源社区构建的全过程。16 年行业经验,在软件、互联网、NGO 等机构中担任过研发、产品管理、创始人等角色。
地点:富力 3+5
专题:面向 AI 的存储
不管对已经应用于搜广推多年的机器学习,CV 领域的深度学习,还是近一年火热的 LLM 而言,数据始终是 AI 最重要的基石,然而存储系统的打造又非一朝一夕可以完成。数据规模 10 倍量级,GPU 性能创造出新的「摩尔定律」,存储能喂饱 GPU 么?同时,在算力与数据同时增加的背景下,调度管理也不断提出新的挑战,今天 AI 参与者对这样的问题有着什么样的看法和实践?本次 AI 存储论坛会邀请在预训练模型、AI 基础设施、AI 应用开发者等不同方向的参与者向大家分享他们的观点。
by 罗庆超
阿里云
资深技术专家数据湖作为大数据平台的底层支撑架构,从存储、元数据、计算框架维度提供了良好的支撑。在 BI 时代,支撑好海量数据存储的稳定性、扩展性、成本是关键技术竞争力;随着 AI 的兴起,特别是 LLM 大模型计算的热潮,对数据湖也带来在性能、安全性上更多的需求,通过阿里云数据湖在该领域的摸索,希望能够给业界在 BI+AI 的基础设施建设上带来更多思路。
演讲提纲:
1. 数据湖支撑数据分析场景和技术
- 数据湖支撑 Hadoop 体系的数据分析
- 数据湖对接 MaxCompute 的数据分析
- 对稳定性的技术要求
- 对扩展性的技术要求
- 对成本的技术要求
2. AI 带来的技术挑战
- 对数据湖存储的接口的技术挑战(POSIX)
- 对数据湖元数据、计算生态管理的挑战
- 对多租户的带宽技术挑战
- 云原生容器化后对访问加速的技术挑战
3. LLM 的新趋势
- 趋势 1:GPU 直通存储的性能要求
- 趋势 2:数据安全和隔离(多租、混合云)
- 趋势 3:数据的移动
4 总结与展望
- 数据湖对 BI+AI 生态的建设与贯通
- 数据湖一站式支撑 BI+AI 的数据分析/建模和线上服务
你将获得:
- 掌握数据湖如何支撑 BI
- 掌握数据湖如何支撑 BI+AI
- 掌握数据湖在 LLM 下的趋势
by 陈静力
网易
资深系统开发工程师随着 AI 业务的迅速发展,产⽣的数据量越来越多,对存储的成本和性能提出了新的挑战。本次演讲将从 AI 的业务的不同场景出发(数据集 / 模型管理、在线编程 / 项⽬管理、数据预处理、训练和预测),说明 AI 业务对存储系统的需求,并介绍 Curve ⽂件系统采⽤了哪些技术来满⾜这些需求,以及在实践过程中遇到的问题与挑战。
演讲提纲:
1. 背景
- 介绍 AI 的业务特点(从不同场景出发讲对存储的需求)
- 介绍 AI 的业务需求
2. Curve 实践
- Curve ⽂件系统简介
- Curve ⽂件系统为 AI 业务降本
- Curve ⽂件系统为 AI 业务提效
3. 总结与展望
- 和 AI 框架的融合:做到⾃动预热
- ⼤数据和 AI 的融合:提供 HDFS 接⼝,使⽤ Curve ⽂件系统即可以⽤在数据⽣产收集也可以 ⽤于后续处理和训练
- 推动在更多业务场景的落地
你将获得:
- 了解 AI 场景对存储的需求
- 了解 Curve ⽂件系统在对接AI业务中遇到问题与挑战、解决⽅案与收益
by 张文涛
焱融科技
CTO对于 AI 训练而言,基于深度学习的多模态大语言模型需要海量的算力和数据,但随着数据集和模型规模不断增加,应用程序载入数据所花费的时间变得越长,进而影响了应用程序的性能,缓慢的 I/O 严重拖累 GPU 的强大算力。如何大幅提升 GPU 载入大型数据集的速度将是计算和存储系统共同面临的最大挑战。本次演讲将从性能、规模、网络、协议以及成本等各个维度介绍当前 AI 企业面临的基础设施问题,并分享 YRCloudFile 高性能文件存储系统解决这些难题的的方法和思考。
演讲提纲:
1. 背景与趋势
2. AI 训练的存储难点及解决思路
3. YRCloudFile 高性能分布式文件存储实践
4. AI 训练的存储难点及解决思路
5. 总结与展望
你将获得:
- 了解 AI 训练的 IO 特点
- 了解 AI 训练中遇到难点、解决思路与收益
- 全闪文件存储在 AI 业务场景的技术应用实践
by 彭毅格
vivo
AI 研究院计算平台组资深工程师今天 AI 早已融入到智能手机的各个角落,vivo 在 AI 领域自 2018 年起就开始大力投入相关的研究和实践。除了传统的搜索、广告、推荐系统,在 CV、声音、NLP 等多个领域都有研究和落地场景,不同的研究方向对 AI 平台基础设施的要求也不同,而且随着 vivo 手机业务拓展到海外,这也给 AI 平台提出了很多新的要求。同时,随着算力和数据规模的提高以及 GPU 的升级换代,存储系统可能会阶段性地成为瓶颈,这对 AI 平台的发展提出了更高的挑战。
为了解决存储瓶颈的问题,vivo AI 训练平台 VTraining 对存储系统进行了多次升级迭代,也经历了 Gluster、Ceph 再到 vivo 轩辕文件系统的历程。
轩辕文件系统是 vivo 团队开发的一种基于对象存储的云原生文件系统。它的特点是可扩展性强、安全性高、可靠性高、易于管理和应用。
通过本次演讲,您将了解多类型 AI 训练中存储系统的挑战和 vivo 的解决思路,了解轩辕文件系统的设计和实践经验,和在大模型业务中遇到的新问题。
演讲提纲:
1. 背景
- 与您分享 vivo AI 训练平台的发展历程
- 分享 5 年来 AI 业务中存储系统遇到的挑战和循序渐进的解决方法
2. 面向 AI 的高性能存储实践
- 介绍轩辕文件系统的背景和特点
- 讨论轩辕文件系统的架构设计与发展
- 分享在 vivo AI 训练平台中使用轩辕文件系统的实践与收益
3. 新的挑战与展望
- 探讨大模型场景下的存储挑战
- 讨论数据集编排,它逐渐成为 AI 平台不可忽视的重点
你将获得:
- AI 训练中存储系统面临的挑战是什么,以及 vivo 是如何应对这些挑战的
- 轩辕文件系统的设计原理和收益,包括其在 vivo AI 业务应用中的实践经验
- 如何解决 AI 训练中存储问题的思路和方法,以及如何应用这些方法来提高训练效率和准确性
关注主办方(InfoQ)
联系我们
交通指南
北京·富力万丽酒店
Renaissance Beijing Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小姐姐