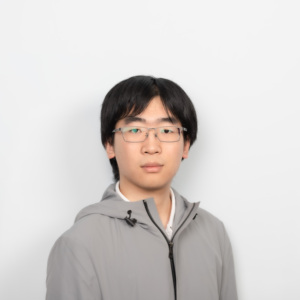
和敬凯,上海交通大学博士研究生,导师是陈海波、夏虞斌、杜冬冬教授。从事操作系统、AI基础设施等方面研究工作,成果发表在SOSP、OSDI、ASPLOS等国际著名会议和期刊,并获SOSP 2025最佳论文奖。
讲师介绍
议题介绍
地点:会议厅1
所属专题:AI Infra:算力效率决定规模化落地
演讲:如何从历史中学习?基于RhymeRL的强化学习系统优化实践
LLM 强化学习中,Rollout 占耗时的相当一大部分,长尾使最早完成 GPU 约 76% 时间空闲。通过大量数据,我们发现发现相邻 epoch 有大量的token 可匹配、因而结合历史推测解码与长度调度,提出 RhymeRL 系统。系统采用离线后缀树、奖励感知选枝、动态窗口、奇偶步互补及尾部迁移,解决在线索引开销、固定窗口无效验证和异常长样本失衡,并取得相比现有系统2.6x 的性能提升。
演讲提纲:
- 背景:强化学习后训练时代,瓶颈在 Rollout
- RL 已成为大模型对齐与推理增强的标准手段
- 实测 Rollout 占训练耗时 84%–91%(math/code RLVR),随训练响应从 2K 增至 11K+ token
- 批内长尾导致最早完成 GPU大量时间空转
- 关键观察:相邻 epoch 的 Rollout 存在“相似性”
- 基于真实轨迹分析:大量token可精确匹配上一 epoch
- 响应长度排序稳定
- 设计目标
- 不依赖额外小模型,复用 RL 已付费生成的历史响应
- 保留 one-step-off 算法边界,避免全异步的样本丢弃与范式改变
- 离线建索引、在线零额外开销,避免检索回到关键路径
- RhymeRL 的系统设计
- HistoSpec:每个提示词一棵后缀树,O(m) 前缀查询;奖励感知选枝;类 AIMD 动态草稿窗口
- HistoPipe:奇偶 step 长短互补调度;步内/跨步尾部迁移;两级 GPU 资源分配
- 端到端闭环:响应、奖励、长度回写历史索引,先验随训练演进
- 实施效果与结论
- 端到端吞吐最高为(基线版本的)的 2.6 倍;HistoSpec 单步 Rollout 吞吐最高 1.86 倍
实践痛点:
- 当前主要针对 math 和 code 进行比较深入的实践,更复杂动态的 agent RL 场景可能需求和问题不同。
前沿亮点:
- 不依赖于传统 speculative decoding 中对小模型能力的依赖
- 能够充分利用空闲算力提效
听众收益:
- 了解当前强化学习在 Rollout 阶段 Infra 侧主要开销
- 了解如何基于历史经验来优化当前的 Rollout
本专题下其他演讲
关注主办方(InfoQ)
联系我们
交通指南
上海建工浦江皇冠假日酒店
Shanghai Construction Group Pujiang Crowne Plaza Hotel
地址:上海市闵行区陈行公路 3701 号
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:18514549229

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手