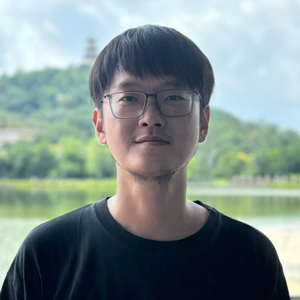
袁彬航是香港科技大学(HKUST)计算机科学与工程系(CSE)的助理教授。他在莱斯大学(Rice University)获得博士学位和硕士学位,并在复旦大学获得学士学位。在加入香港科技大学之前,他曾在瑞士联邦理工学院苏黎世分校(ETH Zurich)担任博士后研究员。主要研究方向包括大语言模型服务系统,面向机器学习的数据管理系统,以及分布式和去中心化的机器学习系统。他曾经获得2019年VLDB最佳论文提名奖,2020年SIGMOD研究亮点奖。
让 Agent 越用越强:AReaL 2.0 构建 Agent 在线强化学习闭环
所属专题:AI Infra:算力效率决定规模化落地
嘉宾 : 袁彬航 博士 | 香港科技大学助理教授
会议室 : 会议厅1
讲师介绍
专题演讲嘉宾:袁彬航 博士
香港科技大学助理教授
议题介绍
地点:会议厅1
所属专题:AI Infra:算力效率决定规模化落地
演讲:让 Agent 越用越强:AReaL 2.0 构建 Agent 在线强化学习闭环
随着 Coding Agent、企业智能助手等 Agent 应用进入真实生产环境,如何让 Agent 在持续使用过程中不断提升能力,成为下一阶段的重要挑战。传统 Agent 系统产生的大量交互轨迹、工具调用记录和用户反馈通常仅用于日志分析,难以转化为模型能力提升的数据闭环。
本次分享介绍 AReaL 2.0 如何构建面向 Agent 自演进的在线强化学习基础设施。方案通过 Agent 轨迹数据协议、数据代理层和演化控制平面,将 Agent 交互转化为可训练、可回放、可治理的数据,并通过推理与训练服务解耦的微服务架构,支持已有 Agent 以较小改动接入 Online RL。分享将以 Hermes Agent 等 Agent 服务为接入示例,并结合 AReaL RSI 在数学解题场景中的初步实验,介绍数据、执行框架与模型联合迭代的学习闭环,探索 Agent 从“一次性执行系统”逐步演进为“持续学习系统”的路径。
演讲提纲:
- Agent 为什么需要从执行闭环走向学习闭环
- 分析当前 Agent 在工具调用、任务规划方面的发展,以及真实生产环境中“无法持续变强”的核心问题。
- 介绍线上 Agent 产生的多轮交互、工具调用、用户反馈等数据为何无法直接用于训练。
- 回顾 AReaL 从大模型异步强化学习到长程 Agent 强化学习的演进,以及计算复用、内核优化和异构 GPU 训练等系统优化。
- 面向 Agent 自演进的新型 RL 基础设施设计:
- 介绍 Agent Trajectory Data Protocol(ATDP):将传统日志升级为包含观测、隐状态、动作、结果、奖励和元数据的学习轨迹。
- 介绍 Agentic Data Proxy:解决 Agent 交互中的轨迹采集、脱敏、持久化和回放问题。
- 介绍 Agent Evolution Control Plane:根据轨迹统计决定优化对象,例如 Memory 更新、Harness 调整或模型权重更新,并设置评估与回滚机制。
- Online RL 微服务化实践:
- 分享如何通过 Gateway、Router、Data Proxy、推理 Worker 与训练 Worker 解耦 Agent 服务与 RL 训练系统。
- 重点介绍低侵入式接入方式:通过配置兼容 LLM API 的推理入口,对接轨迹采集、存储与训练服务,保留已有 Agent workflow。
- 介绍稀疏策略权重传输,以及面向部署方案验证、运行监控和自适应调整的 AReaL-AutoPilot 设计目标。
- 实践中的关键经验与初步探索:
- 线上日志不足以支撑 RL,需要设计面向学习的数据协议。
- 在线更新可能带来效果回落,需要结合评测、准入检查、版本管理和回滚。
- Agent 的改进对象多样,需要区分 Memory、Tool、Prompt、Model 等不同优化路径。
- 结合 AReaL RSI 的初步数学实验,介绍数据、执行框架与模型的联合迭代,并讨论执行框架候选未达到采纳门槛、后续轮次效果下降时如何保留最优版本。
实践痛点:
- 首先,Online RL 的重要挑战是稳定性。Agent 的任务与交互数据不断变化,一次更新并不保证持续提升已有能力,需要设计评测、版本管理和回滚机制,验证并保留有效改进。
- 其次,奖励与反馈的组织仍然困难。Agent 的学习信号可能来自标量评分、评语或延迟反馈,需要将这些信息与观测、动作、结果及版本等元数据关联,形成可审计、可用于训练的完整轨迹。
- 第三,Agent 自演进并不是单纯更新模型参数。一个完整 Agent 包含模型、Prompt、Memory、Tool、执行框架等多个模块,如何根据轨迹统计选择改进对象,并验证改动是否有效,是实际系统设计中的关键挑战。
- 此外,在线学习需要兼顾系统效率与可靠性。长程 Agent 交互、频繁的策略权重刷新以及不断变化的训练负载,会增加推理、训练和通信开销,因此需要结合异步训练、权重传输优化和运行监控,在学习速度、资源成本和系统可靠性之间进行权衡。
演讲前沿亮点:
- 在大模型强化学习后训练与 Agent 强化学习的基础上,本方案进一步关注 Agent 从交互到能力提升的完整闭环。重点在于将 Agent 工作流中的轨迹、工具调用和反馈转化为可学习的数据资产,为基于实际使用经验的持续优化提供系统支撑。
- 采用低侵入式 Online RL 接入方式。通过兼容 LLM API 的推理入口和微服务化架构,将 Agent 服务、轨迹采集和训练系统解耦,使已有 Agent 可以较小改动接入在线学习基础设施。同时,通过异步训练与策略权重传输等系统优化,降低持续学习的运行开销。
- 强调 Agent 演化过程中的评测与治理能力。不仅关注“如何训练更好的模型”,还关注“为什么更新、更新什么、如何验证更新效果”。结合 AReaL RSI 的初步数学实验,展示合成数据与强化学习带来的收益,以及准入检查和版本管理在保留有效改进中的作用。
听众收益:
本次分享将帮助听众理解 Agent 基础设施发展的下一阶段趋势:从传统的模型调用和工作流编排,进一步发展到能够持续学习和自我优化的智能体系统。
技术层面,听众可以了解如何构建 Agent Online RL 闭环,包括轨迹协议设计、交互数据采集、Serving 与 Training 协同、奖励反馈管理以及模型更新流程,并了解支撑这一闭环的关键系统优化。
工程实践层面,分享将总结系统设计与初步实验中的关键经验,包括为什么简单日志无法支撑强化学习、为什么并非每次更新都能带来收益,以及如何通过评测、数据治理和版本管理保留有效改进。
对于正在建设企业级 Agent 平台的团队,本次分享能够提供一种新的系统设计思路:无需推倒已有 Agent 架构,而是通过基础设施升级,为现有 Agent 接入持续优化能力,为未来构建“越使用越强”的 AI 应用提供参考。
本专题下其他演讲
关注主办方(InfoQ)
联系我们
交通指南
上海建工浦江皇冠假日酒店
Shanghai Construction Group Pujiang Crowne Plaza Hotel
地址:上海市闵行区陈行公路 3701 号
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:18514549229

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手