Open Code Review 作者、阿里集团 AI 代码评审负责人。主要研究 AI Agent、程序分析等方向,先后负责了集团内代码导航、代码洞察、代码评审智能化等项目的落地,服务了数万阿里集团开发者,在实际业务中取得显著效果。在 AI Agent 系统设计、场景化工具链蒸馏、大规模生产环境下的质量-成本-速度平衡等方面积累了一定的经验。主导开源了 Open Code Review 项目及业界首个多语言、具备存储库上下文感知的 Code Review Benchmark(AACR-Bench),为行业提供了更精准的质量评估标准。
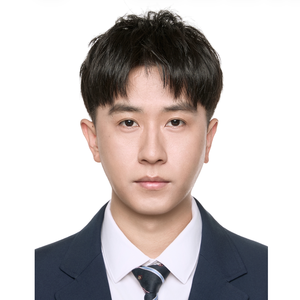
专题演讲嘉宾:李峥峰
阿里巴巴高级研发工程师
by 李峥峰
阿里巴巴
高级研发工程师随着 AI Coding 快速普及,代码生成正逐渐从研发瓶颈变成基础能力,而代码质量、安全性与工程可控性则成为新的核心挑战。越来越多团队开始尝试利用 Agent 自动完成代码评审,但在真实的大规模研发环境中,通用 Agent 往往会面临覆盖不足、定位漂移、质量波动、Token 成本过高等问题,仅依赖 Prompt 和大模型能力难以满足生产级要求。
本次分享将结合阿里 Open Code Review 的建设实践,介绍如何通过确定性工程 + Agent 协同,将通用 Agent 收敛为适用于代码评审场景的垂直领域 Agent。分享将围绕分治并发、精准定位、规则模板引擎、工具链蒸馏、上下文分层管理等关键工程实践,探讨如何将工程逻辑与模型能力结合,让确定性的工作交给工程系统,让需要语义理解的任务交给大模型,实现更高的稳定性、更低的成本和更好的评审质量。
同时,分享还将结合百万真实任务、阿里内部 2 万余名开发者的使用数据以及 Open Code Review 开源项目实践,介绍 AI Review 在生产环境中的效果验证,并进一步探讨 AI 深度参与研发后,如何建立新的评估体系,推动 AI Code Review 从"辅助工具"走向研发流程中的质量基础设施。
演讲提纲
1. AI Coding 普及后,代码评审成为新的效率瓶颈
- AI Coding 改变了代码生产方式
- 为什么交付质量成为新的核心问题
- AI Code Review 在研发流程中的价值
2. 为什么通用 Agent 难以支撑生产级 Code Review
- Demo 与生产环境的差异
- 覆盖率、定位准确率与稳定性挑战
- Token 成本与上下文膨胀问题
- 根因分析:Prompt 驱动为什么不足以解决工程问题
3. 确定性工程 + Agent 协同:五大工程实践
- 分治并发 —— 提升覆盖率
- 文件选择与智能分组策略
- 从串行 Review 到并行 Agent 协同
- 精准定位 —— 保证评审可落地
- 三层定位机制(文件→代码段→行号)
- 幻觉拦截:确保评论可对应到真实代码
- 规则模板引擎 —— 提升稳定性与一致性
- 从 Prompt 驱动到规则驱动
- 按文件类型/语言动态注入评审上下文
- 工具链蒸馏 —— 提升 Agent 可预测性和安全性
- 从真实任务中收敛高频工具调用模式
- 减少探索性调用,降低不确定性
- 上下文分层管理 —— 降低 Token 消耗
- 冻结区:不变的全局背景
- 压缩区:可摘要的历史上下文
- 活跃区:当前推理所需的最小上下文
4. 百万真实任务验证
- 阿里内部生产数据
- 2W+ 开发者使用行为分析
- AI Review 使用趋势与渗透率变化
- Benchmark 量化对比
- 准确率与召回率
- Token 消耗与成本效率
- Open Code Review 开源实践
- AI 写 → AI 审 → AI 改:完整研发闭环
- 社区场景下的效果复现
5. AI 时代如何重新定义研发度量体系
- 为什么采纳率与 AI 评论占比开始失效?
- 如何建立新的 AI Review 评估体系?
6. 总结与展望
- 从通用 Agent 到垂直 Agent 的工程范式
- AI Review 与 AI Coding 的协同演进
- AI 驱动研发质量体系的发展方向
实践痛点
1. 规则模板引擎的维护成本与泛化瓶颈
- 模板引擎提升了精度和稳定性,但代价是每新增一种文件类型、框架或业务场景都需要人工编写规则模板。通用 Agent 天然具备零样本泛化能力,而模板引擎在遇到从未见过的模式时是沉默的。规则库本身也会腐化 —— 代码规范在演进,模板如果不跟着更新就会产生过时建议
2. 度量体系本身的维护成本与时效性
- AACR-Bench 的 Ground Truth 是人工标注的某个时间切片。代码模式在变、框架在更新、AI 生成代码的缺陷分布也在漂移,Benchmark 如果不持续投入更新就会与生产现实脱节。而每次更新的标注成本极高,这不是一个能高频迭代的闭环
演讲亮点
- 完整呈现从通用 Agent 到垂直领域 Agent 的收敛路径 —— 不是理论推导,而是经过百万真实任务验证的工程实践,包含分治并发、精准定位、工具链蒸馏、上下文分层等可复用的设计模式
- 深入探讨当采纳率等传统指标在 AI 深度参与时代失效后,如何构建科学的度量体系来驱动系统持续迭代 —— 这是当前业界普遍面临但少有系统性解法的问题
听众收益
- 理解 AI Code Review 在真实生产环境中的核心挑战,以及为什么通用 Agent 难以直接满足大规模研发需求
- 掌握确定性工程、上下文管理、工具链蒸馏、规则模板等关键工程实践,学习如何构建稳定、可控、可扩展的垂直 Agent 系统
- 了解百万真实任务验证下的 AI Review 落地效果,以及 AI Coding 与 AI Review 协同构建研发闭环的工程经验
- 理解 AI 深度参与研发后的质量评估新范式,学习如何构建更加科学的研发度量体系,为 AI 驱动的软件工程实践提供参考
关注主办方(InfoQ)


联系我们
交通指南
上海建工浦江皇冠假日酒店
Shanghai Construction Group Pujiang Crowne Plaza Hotel
地址:上海市闵行区陈行公路 3701 号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手