王锦冬,小红书技术专家,就职于基础技术部技术风险组。8 年 AIOps 与可观测领域实践经验,曾就职于美团,负责百万级别指标智能监控平台落地。当前主要负责容量平台建设与 DeepSwarm 通用 RCA Agent 平台,推动 Agent 在容量规划、根因分析等 SRE 场景下的规模化落地。在智能监控、告警系统、根因分析、容量规划等方向均有生产级落地经验,专注于把大规模生产场景下的痛点转化为可复用的工程能力。
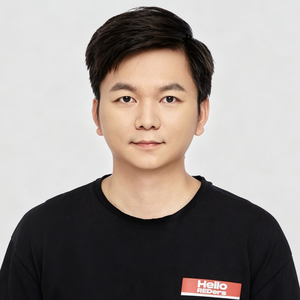
专题演讲嘉宾:王锦冬
小红书技术专家
by 王锦冬
小红书
技术专家DeepSwarm 是小红书技术风险团队构建的通用 RCA Agent 平台,面向容量、变更、异常等场景的故障根因分析,目前以容量根因分析作为首个规模化生产场景。
在运维场景里,Agent Harness 的设计需要兼顾可核对、人机协同与时效性:结论要有证据支撑,不确定时敢说“我不知道”;Agent 能自主调查,也支持人随时核验、补充信息和纠正方向;考虑到值班同学通常只能等待几十秒,需要尽早给出可用判断。这些要求共同影响了 Harness 的设计取舍:如何提高诊断可靠性、减少无效探索,并在有限时间内交付有依据的结果。
分享将展开可观测上下文工程、基于 Session Tree 的诊断过程管理,以及时效性约束下的执行与交付设计:如何将原始观测数据加工成可用证据,如何先建立公共事实、再通过多个分支验证根因假设,如何将固定排查流程封装为工具,并控制上下文规模与结果交接成本。最后结合多维评测、容量场景的验证反馈和真实翻车案例,复盘生产实践中的踩坑,以及何时需要人工核验与介入。
演讲提纲
1. 运维场景下 Agent 的三个设计目标
- 结论可核对、过程可协同、结果及时交付——这三个目标如何影响 Harness 的设计取舍
- 为什么选择容量根因分析作为首个规模化生产场景
- DeepSwarm 架构概览:数据与领域工具、诊断 Harness、交互与结果交付
2. 可观测上下文工程:把原始信号加工成可用证据
- 上下文质量决定诊断型 Agent 的结论上限
- metric / log / trace / change 的上下文加工思路与关键取舍
- 对齐异常时间窗、聚合重复信息、保留关键差异、标明数据缺口
3. Session Tree:让诊断过程可追溯,支持多分支探索与人工介入
- 线性会话的局限:不同调查方向容易相互干扰,纠偏与继续调查需要保留原有路径完整保留调查历史,按需构建模型上下文:共享已有事实,隔离各分支的调查过程
- 控制分支交接的信息量:各分支向主分支返回简洁结论、关键证据引用和未决问题,完整过程保留在分支中,支持按需核验
- 支持人工介入:通过历史预览、回退与 Fork,从指定位置纠正方向、继续调查
4. 时效性约束下的执行与交付:两段式下钻与假设验证
- 第一阶段:问题定界,建立公共事实——明确异常时间窗、影响范围、关键变化与数据缺口,减少重复调查
- 第二阶段:提出假设,按需多分支深挖——基于公共事实形成候选根因,依托 Session Tree 寻找支持证据与反证
- 执行分工:固定排查交给工具,动态判断交给 Agent——将成熟排查步骤封装为领域工具,减少重复规划与多轮调用;Agent 负责选择验证路径、综合证据与调整调查方向,每类 Agent 只提供必要的工具与技能
- 控制执行成本,明确停止条件——控制分支数量、调查深度和交接成本,根据证据充分性与时间预算收敛,保留未决假设与后续核验方向
- 及时交付可用结果——区分调查进展、已确认事实与初步判断;明确判断依据和未决问题,生成可核对的诊断报告及结构化结果
5. 多维评测闭环:从一次翻车到系统改进
- 如何判断诊断真的变好:围绕结论准确性、证据充分性与时效性,结合自动评测和 SRE 盲评
- 一次真实翻车复盘:还原错误结论如何产生,明确 Agent 的能力边界与人工介入点
- 让教训持续生效:将 Bad Case 纳入回归评测,并据此调整输出约束、验证步骤和停止条件
6. 容量场景的生产验证与展望
- 上线规模与覆盖:接入的核心服务数、覆盖的容量告警比例
- 效果数据:SRE 采纳率、首次可用判断耗时、完整诊断耗时,以及诊断错误率与典型错误类型
- 当前能力边界:哪些问题能够独立完成诊断,哪些仍需人工补充证据和判断
- 展望:积累服务与场景知识、探索诊断到处置的闭环,以及从容量向更多 RCA 场景扩展
实践痛点
- 上下文加工的信息取舍:压得太狠会丢失关键信号,压得太松会增加上下文负担;不同数据源需要针对性加工
- 固定流程与动态判断的分工:封装不足会导致重复规划和调用,封装过度会限制对现场变化的适应能力;需要明确工具的适用条件与输出边界
- 多分支的收益与交接成本:并行不一定更快,重复查询、启动等待和结果摘要都可能抵消收益;精简交接内容时,需要保留关键证据引用,支持按需回查与核验
- 时效性与完备性:及时的初步判断更有实用价值,但何时停止调查、如何表达未决问题,需要结合真实反馈持续迭代
- 评测体系的运营成本:基准集维护,以及更具挑战性的测试案例构造,都需要 SRE 持续投入
演讲亮点
1. 可观测上下文工程:把原始数据加工成可靠的诊断依据
- 从容量 RCA 实践出发,展示 metric / log / trace / change 如何被加工为可供诊断的结构化证据。通过加工前后的具体对比,解释时间对齐、关键差异保留和数据缺口表达如何影响最终判断,分享信息压缩与证据完整性之间的工程取舍
2. Session Tree:让诊断过程可追溯,支持多分支探索与人工介入
- 完整保留调查历史,按需构建模型上下文。各分支共享已有事实、独立开展调查,通过简洁结论与证据引用完成结果交接,支持按需回查。结合历史预览、回退与 Fork,让人工核验、纠偏和继续调查成为 Harness 的原生能力
3. 时效性驱动的执行:用工具完成固定排查,用多分支验证根因假设
- 以两段式下钻组织诊断:先定界、建立公共事实,再提出假设、按需多分支验证。将成熟排查流程封装为领域工具,减少重复规划与调用,结合时间预算和证据充分性明确停止条件,在时效约束下交付可核对的诊断结果
听众收益
- 建立诊断型 Agent 的设计视角:从可核对、人机协同与时效性出发,识别自身场景的边界约束,选择匹配的 Harness 机制
- 掌握可观测上下文加工思路:理解如何将原始指标、日志、调用链和变更记录提炼为可用证据,保留关键差异并表达数据缺口
- 获得可借鉴的诊断执行方法:理解公共事实、候选假设、分支验证与结果交接如何配合,判断哪些流程值得封装为工具、哪些决策需要动态判断,以及何时并行、何时停止
- 理解人机协同与持续改进如何落地:通过可追溯的调查过程支持人工核验与纠偏,将真实失败转化为输出约束、回归案例和执行策略的改进
关注主办方(InfoQ)


联系我们
交通指南
上海建工浦江皇冠假日酒店
Shanghai Construction Group Pujiang Crowne Plaza Hotel
地址:上海市闵行区陈行公路 3701 号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手