杨林枫,阿里巴巴高级技术专家,斯坦福大学博士。长期从事 AI 软件栈、AI 编译与算子编译工作,是开源 AI 框架 MindSpore 核心贡献者,曾主导昇腾算子编译器 SWFT 的设计与研发。现聚焦大模型推理、GPU Kernel 自动生成与长周期智能体工程,是 Atrex Kernel Agent 核心研发者,相关实践支撑阿里百炼MaaS大规模GPU集群的性能优化。也曾支撑 Qwen3.8 获得 NVIDIA SOL-ExecBench FlashInfer 算子优化榜首。
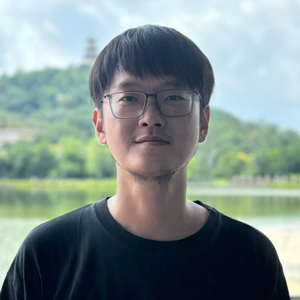
专题演讲嘉宾:杨林枫 博士
阿里巴巴高级技术专家
by 杨林枫 博士
阿里巴巴
高级技术专家MaaS 业务中的模型、硬件和请求工况变化较快。传统的部署调优和算子优化依赖人工完成需求分析、性能定位、算子开发、验证及上线,优化周期难以跟上生产负载的变化。
本次分享将介绍一套面向 MaaS 生产场景的自动优化流程:给定卡型、模型和典型工况,探索合适的部署配置;从实际运行 Trace 中识别热门算子,并结合当前工况判断是否采用已有的算子融合模式;对典型工况进行归并、清洗、脱敏和泛化,生成可复现的 Benchmark;再由 Atrex Kernel Agent 通过 Agent Loop 完成性能分析、代码生成、验证和持续优化;最后将优化结果回接推理框架,进行端到端性能回归和灰度验证。分享将重点介绍算子优化,以及各环节之间如何衔接。
演讲提纲
- 为什么 MaaS 推理优化需要自动化
- MaaS 场景中的模型、卡型、请求工况和部署配置持续变化
- 传统流程依赖人工完成需求分析、性能定位、算子开发和框架集成,整体周期较长
- 单算子 Benchmark 的优化结果不一定能转化为端到端收益
- 从部署配置探索、算子任务生成、Agent 优化到框架上线的整体流程
- 探索推理部署配置
- 给定卡型、模型和典型工况,探索并行策略、批处理及推理引擎配置
- 结合延迟、吞吐、显存和资源成本选择候选部署方案
- 根据实际运行 Trace 定位当前部署配置下的主要性能瓶颈
- 从生产 Trace 到算子 Benchmark
- 从生产 Trace 中识别热门算子,归并动态 Shape,选取典型 workload
- 结合卡型、模型、工况和算子 Trace,判断是否采用已有的算子融合模式
- 对生产工况进行去重、清洗、脱敏和泛化,形成可复现的 Benchmark
- 建立正确性、数值容差和性能评测标准,确定算子任务的优化优先级
- Atrex Kernel Agent 的优化 Loop
- Agent 循环进行 profile、瓶颈分析、方案生成、代码修改、验证和复盘
- 通过隔离会话、Git worktree、结构化 memory 和实验 journal 管理多轮优化
- 外围 Loop 负责实验预算、状态恢复、正确性门禁和终止控制,并使用完整 workload 与同卡 ABBA 测量验证性能收益
- 记录有效方案和失败实验,并结合代表性算子介绍一次完整的优化过程
- 优化结果回接推理框架并上线
- 将优化后的算子回接推理框架,检查接口、依赖和硬件兼容性
- 进行算子正确性与性能回归,以及模型端到端性能验证
- 通过灰度发布观察实际效果,并保留异常回滚能力
- 实践成果
- 支撑 Qwen3.8 获得 NVIDIA SOL-ExecBench FlashInfer 算子优化榜首
- 介绍百炼 MaaS 中面向不同卡型、模型和生产工况的优化实践
- 展示代表性算子的优化结果,以及回接框架后的端到端效果
实践痛点
- 生产工况变化快且存在长尾。采样过少可能遗漏重要场景,采样过多则会增加分析和评测成本
- 线上 Trace 不能直接作为 Benchmark,需要进行数据脱敏、Shape 去重、工况归并和可复现性处理
- Agent 可能过拟合公开 Shape,也可能将 GPU 测量波动误判为性能收益
- Kernel 局部变快不代表端到端一定有收益,仍需在推理框架和模型层重新验证
- 自动生成的代码在进入生产环境前,仍需经过正确性验证、性能回归、灰度发布和异常回滚
演讲前沿亮点
- 从真实生产工况中生成优化任务。 根据 MaaS 部署中的实际 Trace 识别热门算子和典型 workload,而不是只依赖人工提交优化需求
- 衔接部署配置与算子优化。 给定卡型、模型和工况,先探索候选部署配置,再从实际运行结果中提取算子任务
- 通过 Agent Loop 完成多轮算子优化。 Agent 负责性能分析和优化实验,外围 Loop 负责正确性检查、性能验证、状态恢复和终止控制
- 将优化结果放回框架验证。 算子优化完成后回接推理框架,以模型端到端结果判断实际收益
听众收益
- 了解如何从 MaaS 生产工况和运行 Trace 中提取可用于优化的算子 Benchmark
- 了解 Atrex Kernel Agent 如何通过 Agent Loop 完成多轮算子性能优化和结果验证
- 了解算子优化结果回接推理框架并进行端到端验证的基本流程
关注主办方(InfoQ)


联系我们
交通指南
上海建工浦江皇冠假日酒店
Shanghai Construction Group Pujiang Crowne Plaza Hotel
地址:上海市闵行区陈行公路 3701 号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手