拥有17年大数据/AI存储研发与架构经验,先后任职京东、阿里云EMR和腾讯云TBDS,长期深耕HDFS、JuiceFs和缓存加速等技术。曾主导数千节点集群跨机房迁移、版本升级及存算分离项目,节省成本超千万。在TBDS主要负责TBDSFS研发,支持批、OLAP、多模态湖仓检索、AI训推等计算场景的大规模、高性能数据存储和访问需求。
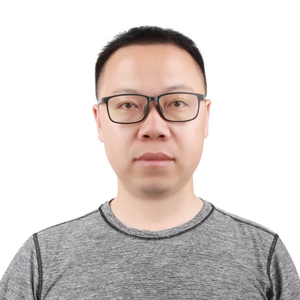
专题演讲嘉宾:何良均
腾讯云TBDS 存储研发负责人
by 何良均
腾讯云
TBDS 存储研发负责人企业 Agent 上线后,如何从任务、反馈和失败中持续学习,而不是每次从零开始?
我们基于 TBDS-FS、Ray、混合检索和评测体系,构建面向 Agent 自主进化的多模态记忆湖:统一管理原文、图片、Chunk、Embedding、轨迹、反馈及版本,通过向量检索、BM25、RRF 和 Reranker 召回经验,利用 Ray 完成分布式解析、反思提炼和索引构建。实践覆盖千万级 Chunk、TB 级数据,实现分钟级增量更新,并通过离线评测、灰度发布和版本回滚控制错误进化。过程中解决了小文件、权限穿透、重复记忆、模型升级及旧知识残留等问题。
内容大纲:
1.为什么企业 Agent 必须具备自主进化能力
2.Agent 自主进化的闭环架构
3.为什么长期记忆不能只是一个向量数据库
4. TBDS-FS 多模态记忆湖的统一建模
5.混合检索如何让 Agent 想起正确经验
6. Ray + TBDS-FS 构建分布式进化流水线
7. 如何避免 Agent 越学越错
8.版本、权限和遗忘机制
9.实践效果、指标体系与踩坑
10.总结:自主进化的三个层次
听众收益:
1、获得一套可落地的自主进化架构:理解观察、记忆、反思、评测、发布和遗忘的完整闭环。
2、理解向量数据库与向量湖的边界:避免把企业 Agent Memory 简化为向量数据库选型。
3、了解 Ray 与统一存储的规模化实践:处理分布式解析、Embedding、索引构建
失败重试和增量发布。
适合人群:
适合正在建设或运营企业级 Agent 的架构师、AI 平台与 RAG 工程师,以及关注多模态数据底座、检索系统和 AI 治理的大数据平台工程师
关注主办方(InfoQ)
联系我们
交通指南
上海建工浦江皇冠假日酒店
Shanghai Construction Group Pujiang Crowne Plaza Hotel
地址:上海市闵行区陈行公路 3701 号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:18514549229

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手