海量数据的积累以及云计算的发展对数据中心架构提出了严峻的挑战,对新型数据存储的需... 展开 >
现代数据架构
会议室:沙龙厅 1出品人:堵俊平
- Topic 1
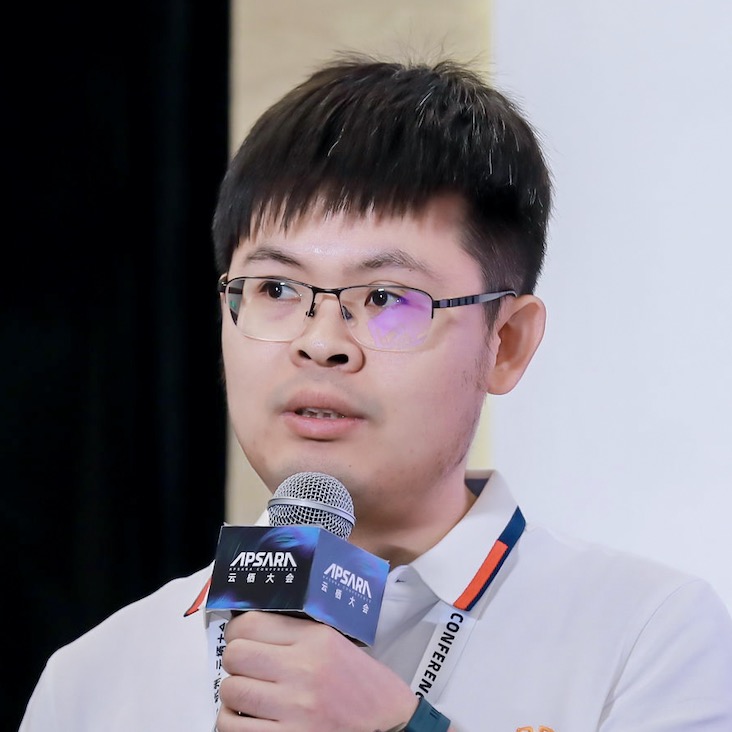
沈春辉
阿里云 资深技术专家 - Topic 2
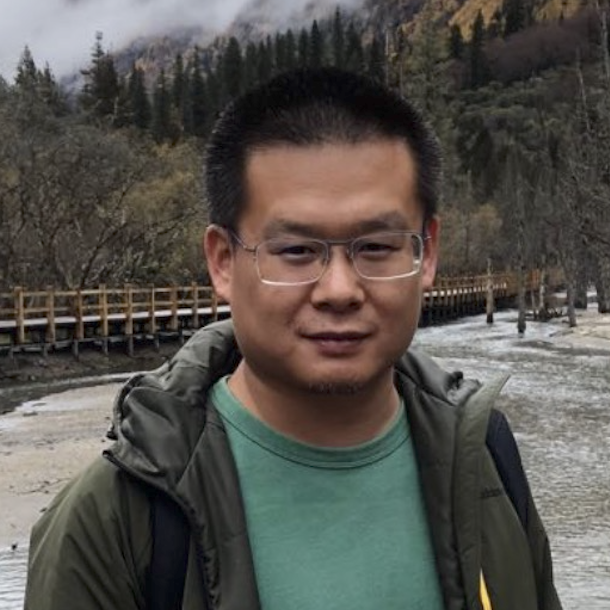
陈龙
腾讯 专家工程师、EMR技术负责人 - Topic 3
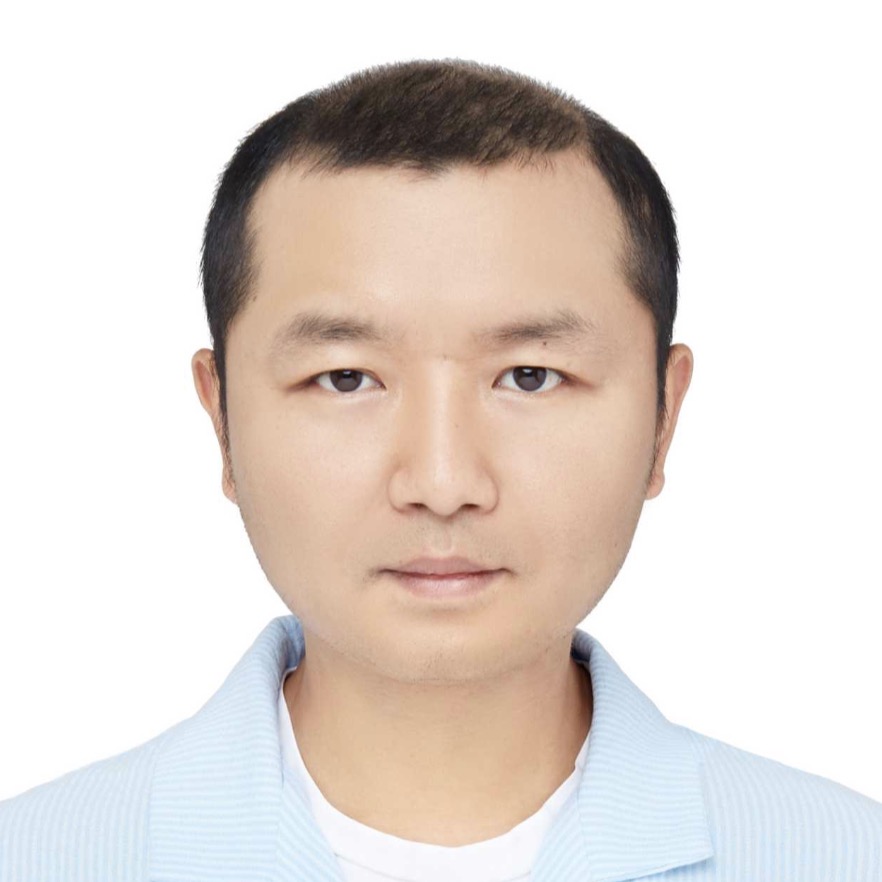
杨亚洲
OPPO 文档数据库MongoDB负责人 - Topic 4
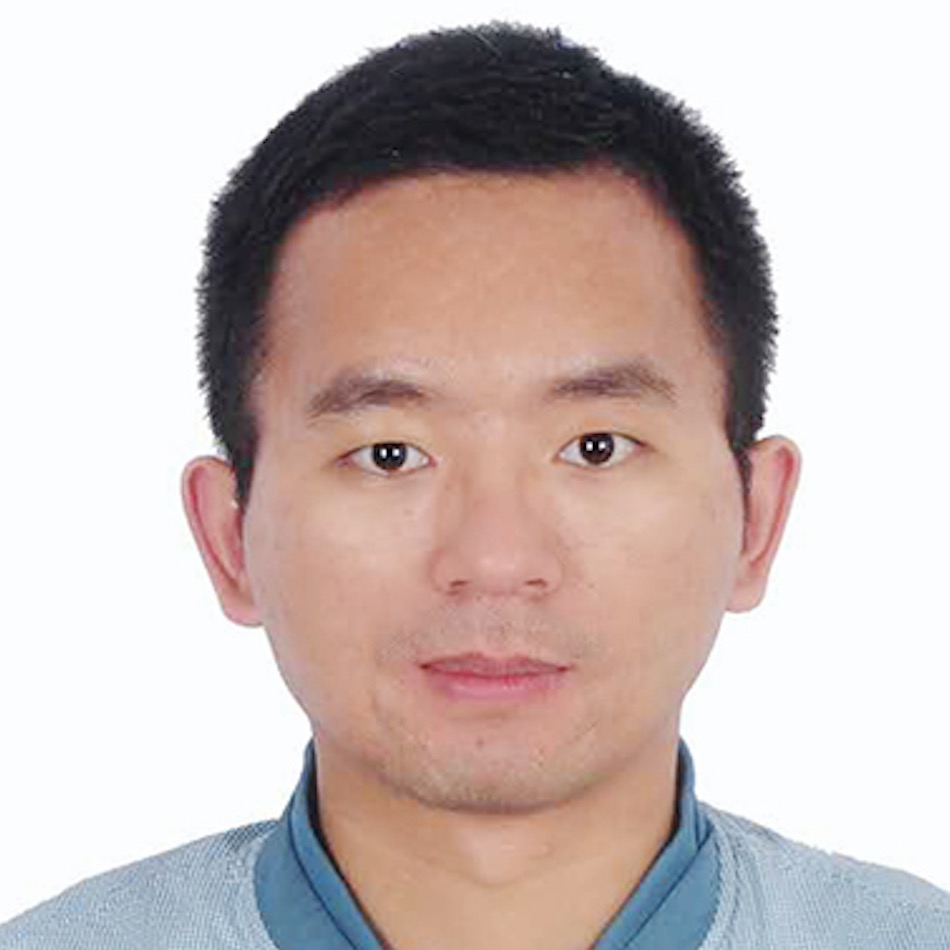
罗旦
华为 高级开发工程师
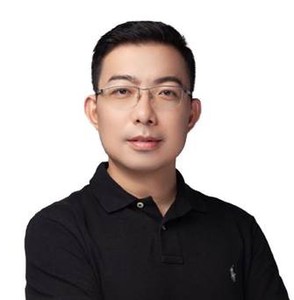
专题出品人:堵俊平
华为云与计算开源业务(OSDT)总经理
堵俊平,现为华为云与计算开源业务(OSDT)总经理,开放原子开源基金会TOC(技术监督委员会)主席,Apache软件基金会Member, Apache Hadoop PMC & Committer以及Apache NuttX, YuniKorn等项目导师。加入华为前,历任腾讯开源联盟主席/数据平台部总监,Hortonworks Hadoop核心团队(美国)负责人等角色,积累了在云计算,大数据以及开源领域长期的研发、管理和业务经验,具有广阔的技术视野和业界影响力。
地点:沙龙厅 1
专题:现代数据架构
海量数据的积累以及云计算的发展对数据中心架构提出了严峻的挑战,对新型数据存储的需求也持续增强。组织的数据架构越成熟,业务就越成功。在降低成本和提升效率的需求的驱动下,如何进行数据架构变革?在面向云原生,支撑实时 OLAP,以及新硬件技术的驱动下,各个层次的数据存储架构又正在面临哪些变革?本专题将汇集全球前沿技术团队,一起探讨数据架构技术。
by 沈春辉
阿里云
资深技术专家随着互联网、物联网思维的深入发展,企业需要应对海量异构数据的存储与处理,而多种数据系统组合使用的复杂性逐渐成为当代应用中的一大核心痛点,为此,Gartner在2017年预测多模数据管理将成为未来的主要趋势,并在随后几年逐渐成为主流数据库的选择。在阿里巴巴,同样面临着应用对多样化数据处理的需求和挑战,本议题将分享Lindorm在多模数据库方向的思路、演进及实践,包括模型选择、引擎设计、数据融合、统一访问等,并探索长远的未来需求及发展路线。
内容大纲
1、多模数据库的发展背景
- 数据趋势
- 应用的数据架构
- 多模数据库的诞生与发展
- 多模数据库的四个阶段与价值
2、阿里的多样化数据需求及技术演进
- 阿里内部的数据库生态
- Lindorm的十年发展演进
- 当代业务的数据处理需求剖析
- 应对解决思路
3、Lindorm的多模数据架构介绍
- 整体系统架构
- 核心设计介绍: 存算分离、融合多模、Serverless等
- 关键技术解析:存储引擎、冷热分离、多副本一致性、一体化存储检索等
4、 典型场景实践
- 阿里内部电商场景的实战案例分享
- IoT行业的实战案例
听众受益
- 多样化数据处理的应用需求和技术应对
- 多模数据库的技术设计和演进
- 更多了解云原生架构
- 了解原生多模Lindorm与多系统(MySQL/HBase/ES)组合使用的异同
适合人群
关注大数据、数据库、存储、云原生数据架构等开发人员。
by 陈龙
腾讯
专家工程师、EMR技术负责人ClickHouse是计算引擎里的一个后起之秀,在OLAP里有着强劲的性能表现,同时面向不同的业务场景提供了多种存储引擎支持,因此各大云厂商也在快速跟进,如何满足客户根据数据热度不同实现数据的冷热分离以及有效的支持云上存储,是云厂商针对ClickHouse内核扩展和优化的重点方向之一,腾讯云在ClickHouse的云化、Kafka读取效率提升、支持对象以及数据自均衡等其他方面做了大量的优化工作,本次分享将围绕ClickHouse的存储策略、存储卷和Disk深度展开,详细介绍ClickHouse的存储策略以及如何让云存储作为ClickHouse的底层存储以实现ClickHouse云化和基于数据冷热有效的降低成本和提高性能。
内容大纲
1. 云数仓和ClickHouse
简要介绍传统数仓和云数仓的差别,为什么腾讯云现阶段选择ClickHouse来构建云上数据仓库系统
2. ClickHouse Cloud Storage Engine
基于计算存储分离的架构,如何充分利用云的资源弹性和海量存储来发挥ClickHouse的性能长处,将介绍如何扩展ClickHouse的存储引擎来适配云环境下计算存储分离
3. ClickHouse 对象存储作为磁盘
分析如何将对象存储作为ClickHouse的存储磁盘,以及和目前社区ClickHouse的差异和优劣
4. 云数仓ClickHouse产品形态
最后分享云ClickHouse的产品能力和社区ClickHouse的差异,以及这样做的原因
听众受益
1. 了解什么是ClickHouse
2. ClickHouse如何实现存储分级
3. 云和ClickHouse
适合人群
关注大数据、实时数据分析、云存储、数仓等开发人员。
by 杨亚洲
OPPO
文档数据库MongoDB负责人当前OPPO自研MongoDB内核版本服务于OPPO互联网数百个业务,每秒峰值TPS/QPS近千万级,总数据量万亿级。自研MongoDB致力于解决公司异地多活、高并发大流量、海量数据存储等业务痛点。
OPPO-mongodb基于开源MongoDB做了一些内核定制化开发,使其在高并发读写、超大规模数据量存储、扩容迁移速率等方面相比开源版本具有更好的性能表现,其中一些业务场景性能有数十倍提升。
内容大纲:
1. MongoDB在OPPO互联网推广经验分享-如何把一个淘汰边缘的数据库逐步变为公司主流数据库
2. 谈谈当前国内对MongoDB误解(丢数据、不安全、难维护)?
3. MongoDB跨机房多活方案-实现成本、性能、一致性"三丰收"
4. MongoDB线程模型瓶颈及其优化方法
5. 并行迁移:MongoDB内核扩容迁移速率数倍/数十倍提升优化实践
6. 百万级高并发读写/千亿级数据量MongoDB集群性能数倍提升优化实践
7. 万亿级数据量MongoDB集群性能数十倍提升优化实践
8. 磁盘800%节省-记某服务接口千亿级数据迁移MongoDB,近百台SSD服务器节省原理
9. 展望:借助MongoDB完善的分布式、高可用、机房多活等功能,如何实现NoSQL、NewSQL融合
10.其他
听众收益
1. 了解MongoDB同城、异地机房多活方案如何实现成本、性能、一致性"三丰收"
2. 了解MongoDB内核高并发访问线程模型优化方法
3. 了解分布式数据库MongoDB的优势
4. 了解MongoDB海量数据存储原理
5. 了解MongoDB内核服务层及存储引擎性能优化方法
6. 了解MongoDB成本节省原理
by 罗旦
华为
高级开发工程师随着大数据技术的应用和发展,数据种类越来越多,数据分布越来越广,查询场景也越来越复杂。当前大数据面临三个问题:
- 开发语言多、组件多、开发门槛高;
- 数据分散,管理复杂;
- 跨源分析需要数据搬迁,查询效率低。
为了改善大数据的易用性,华为发起数据虚拟化引擎openLooKeng开源项目。openLooKeng使用了业界著名的开源SQL引擎Presto来提供交互式查询分析基础能力,并继续在融合场景查询、跨数据中心/云、数据源扩展、性能、可靠性、安全性等方面发展,让大数据使用更简单。本次演讲将主要分享openLooKeng的应用场景、系统架构、关键特性和性能优化实践。
内容大纲
1、大数据分析现状和问题
- 大数据行业背景
- 大数据查询面临的挑战
- openLooKeng聚集的应用场景
2、openLooKeng架构介绍
- 整体系统架构
- 关键特性解析:统一数据访问接口、虚拟集市、高可用AA、跨源跨域跨DC融合分析
3、openLooKeng即席查询性能优化实践
- 即席查询面临的挑战
- 性能优化关键技术:动态过滤、启发式索引、Star-Tree Index
听众受益
- 了解大数据的现状和当前面临的问题
- 了解openLooKeng大数据分析引擎优势
适合人群
具备基本的大数据知识的研发同学。
关注主办方(InfoQ)
联系我们
交通指南
深圳机场凯悦酒店
Hyatt Regency Shenzhen Airport
地址:广东省深圳市宝安区空港八道12号
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 17310043226

领取往期热门演讲视频
小姐姐 Ring